让AI学会给昇腾NPU调优!复旦联手华为小艺,算子生成成功率达95.5%
让AI学会给昇腾NPU调优!复旦联手华为小艺,算子生成成功率达95.5%把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
来自主题: AI技术研报
8394 点击 2026-10-27 14:00

 搜索
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
Perplexity推出本地优先智能体Portable Computer,通过专为端侧模型设计的Harness配合Qwen3.8-27B实现近零成本的本地推理,并在多项基准测试中超越Hermes和Pi等开源通用框架。
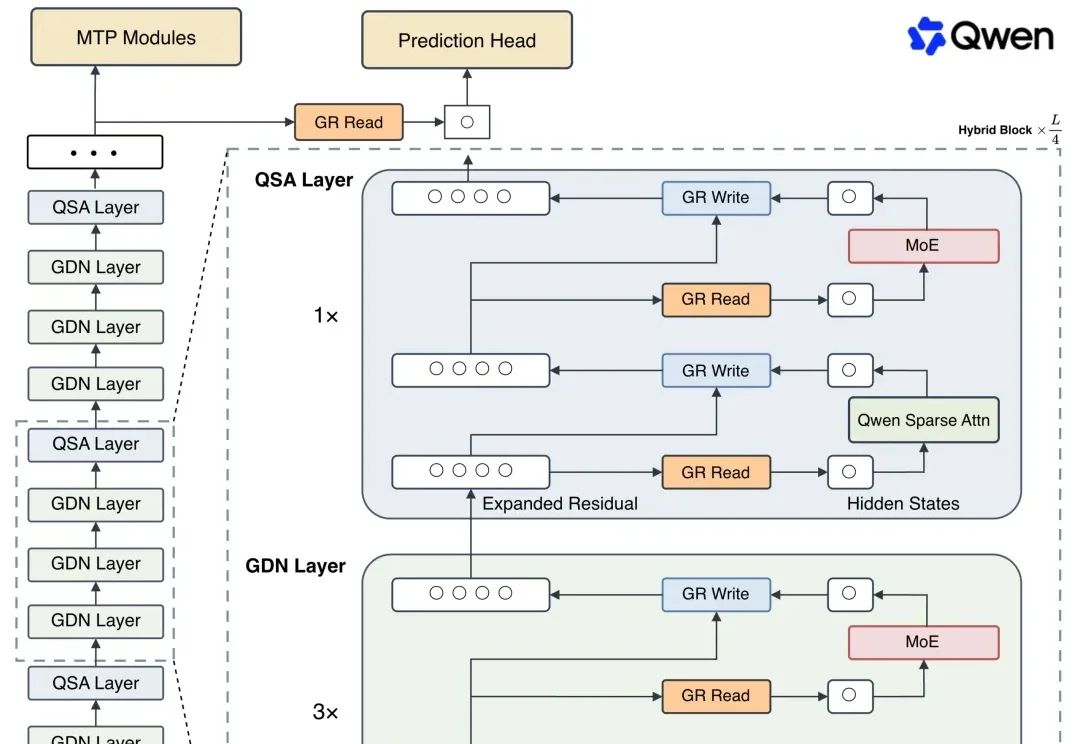
Qwen4还没出,架构先开源了。
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
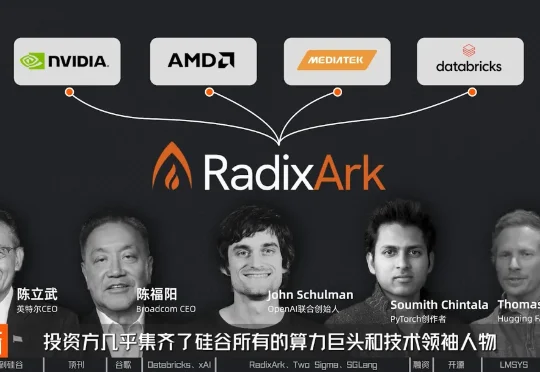
她是xAI前推理团队负责人。她研究并发起的开源推理引擎SGLang,已经成为众多大模型部署和推理的重要底层工具,也是目前AI infra领域最具影响力的开源推理框架之一。如今,她从SGLang开源生态中孵化出创业公司RadixArk,希望把只有少数科技巨头才能拥有的前沿AI基础设施,变成整个行业都可以使用的开放技术底座。
这家名为 PrismML 的初创公司表示,已将 Qwen 3.6 缩减至可在 iPhone 17 Pro 上运行,该模型拥有 270 亿参数(参数大致类似于大脑中的突触,能够帮助决定模型可处理数据的复杂性)。相比之下,大多数在手机上运行的模型一次仅有几十亿个参数处于活动状态。
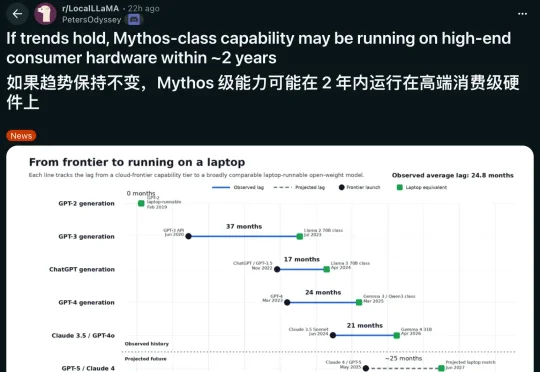
两年后,Fable 5 级 AI,可能就躺在你的笔记本里。就在昨天,全球最大的本地大模型社区r/LocalLLaMA,一张图刷屏了整个AI圈——标题简单粗暴:如果趋势持续,Mythos级能力可能在2年内运行在高端消费级硬件上。
最近,我们都在关注旗舰级大模型的进步,其实本地运行的 AI 模型也迎来了重要的分水岭。
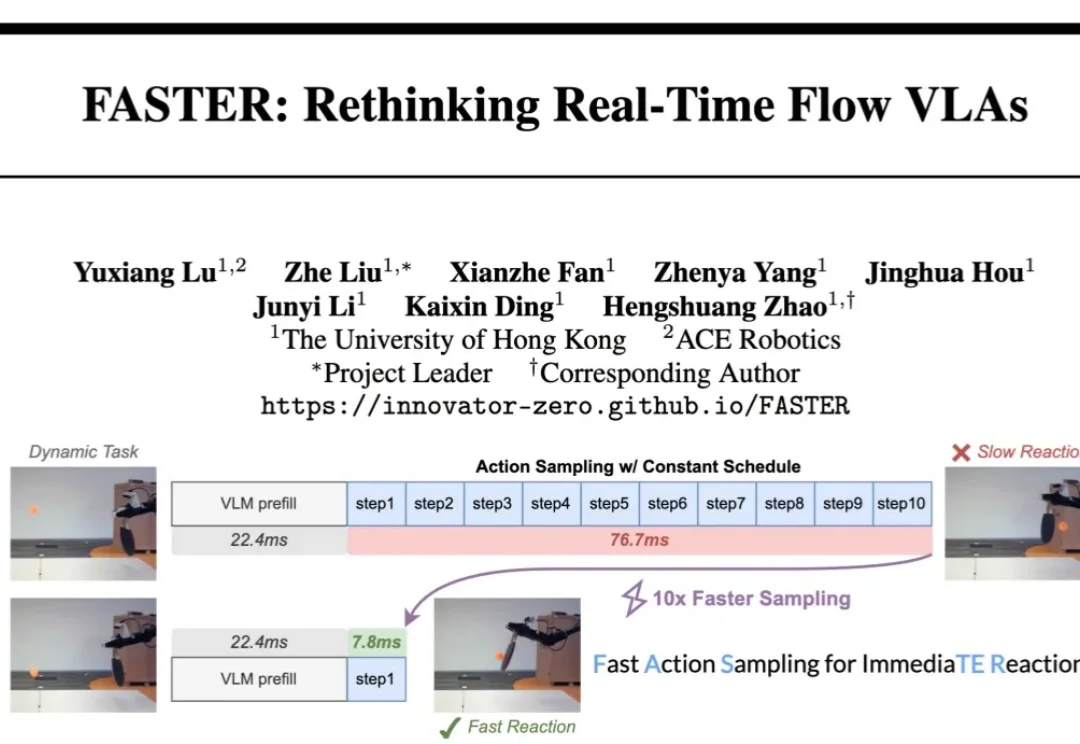
具身智能正以前所未有的速度发展,VLA 模型展现出越来越强的动作和泛化能力。然而,当我们真正把 VLA 模型部署到物理世界时,一个核心挑战浮出水面:实时性。
Factory 发布桌面端应用,让自治 AI 代理(Droids)直接在你的电脑上操控 VS Code、浏览器、终端和 Excel——官方原话是「像你一样操作你的电脑」。多代理并行、持久化机器、本地模型部署一步到位,官方称企业团队采用速度翻倍、会话量暴涨 4.6 倍。发布推文 21 万人围观,近 900 人点赞。