敢和英伟达现场PK的国产GPU,我是服的
敢和英伟达现场PK的国产GPU,我是服的天数智芯展示云端GPU天垓300、端侧产品彤央TY1200和天数智算软件栈,现场随机文生图测试中天垓300用时95.6秒、快于英伟达H200的112秒,TY1200在Qwen与Cosmos模型实测中性能超过Jetson Thor T5000。
来自主题: AI资讯
6907 点击 2026-10-30 15:28

 搜索
天数智芯展示云端GPU天垓300、端侧产品彤央TY1200和天数智算软件栈,现场随机文生图测试中天垓300用时95.6秒、快于英伟达H200的112秒,TY1200在Qwen与Cosmos模型实测中性能超过Jetson Thor T5000。
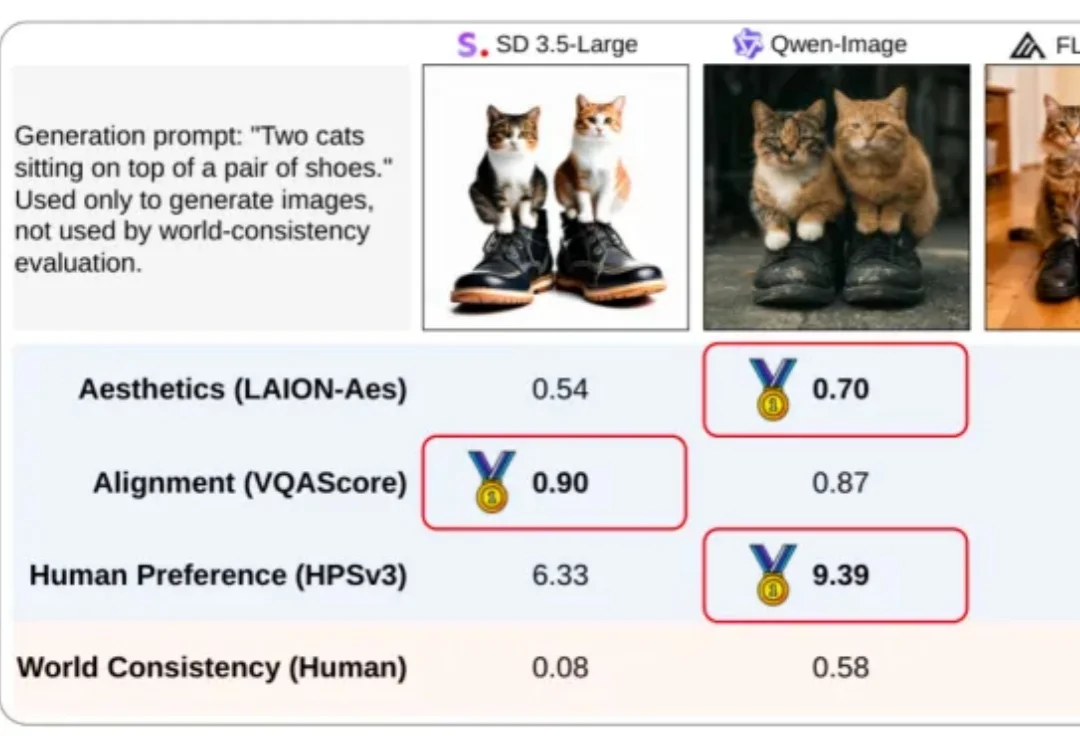
一张 AI 生成的图,可以在美学、提示词对齐和人类偏好指标上拿到高分,画面里却藏着扭曲的肢体、相互穿透的物体,或不合理的物理现象。这些错误,并不总能从现有分数中看出来。
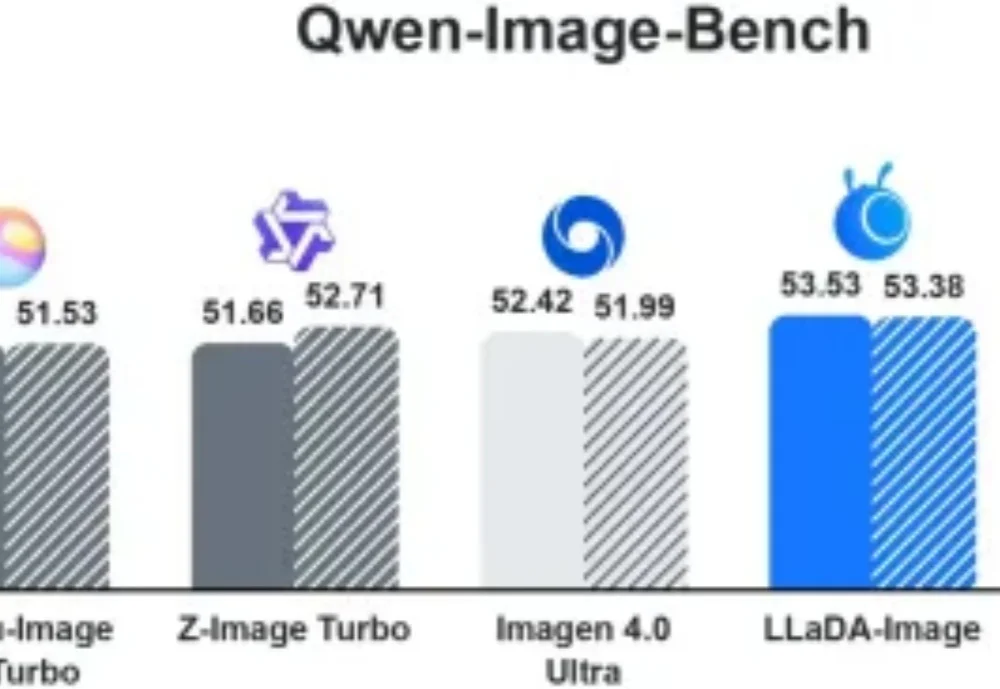
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
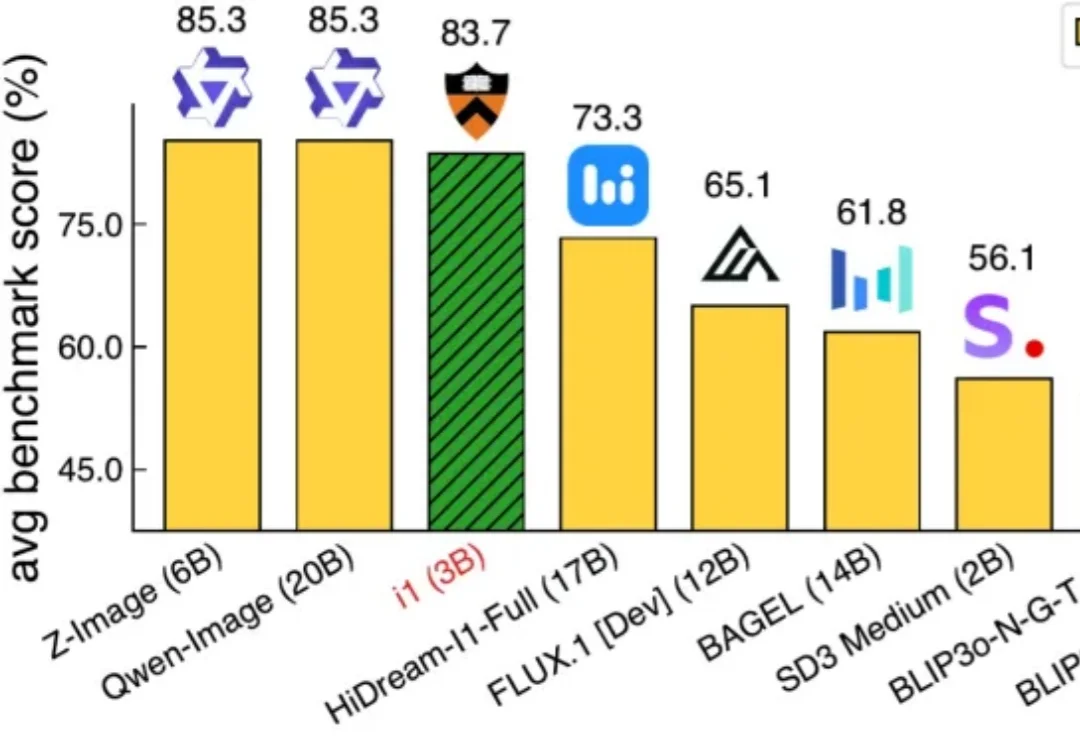
近来文生图模型发展迅速,但每篇工作多是独立地引入一整套模型、数据和训练设计,然后用私有的数据训出来了一个亮眼的模型。
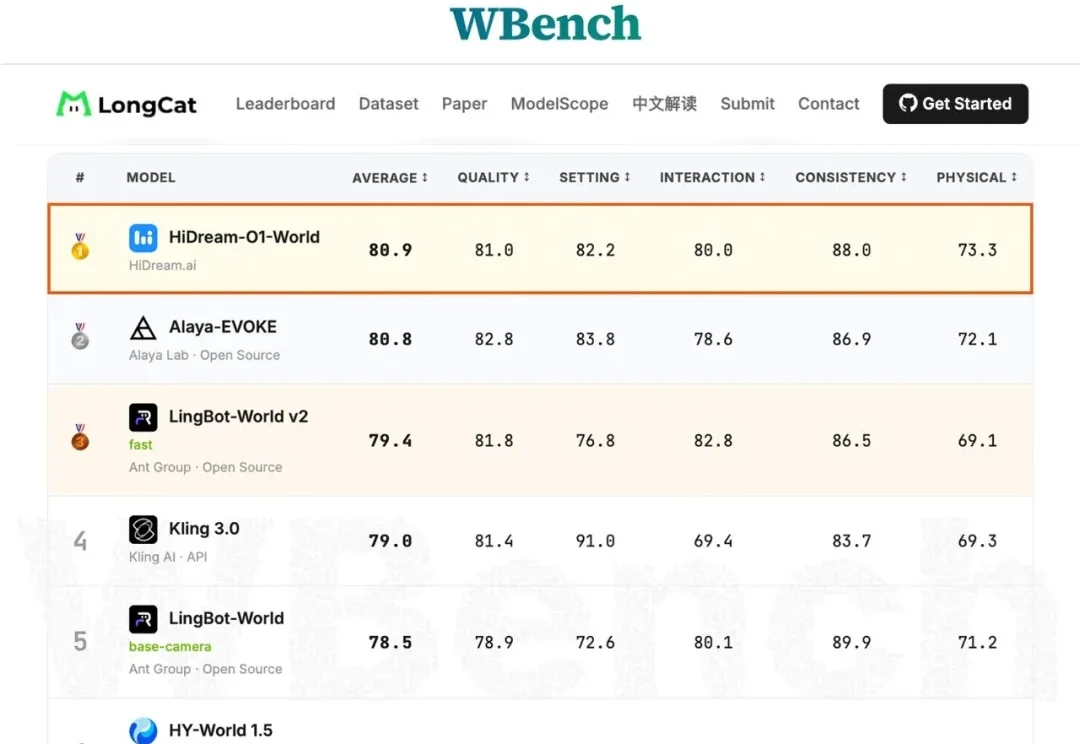
过去三年,AI 内容生成行业经历了几轮密集的技术迭代。从文生图到文生视频,从几秒的短片到分钟级的长视频,每一轮升级都让生成内容的质量和时长向前推进一步。
训练一个顶级文生图模型,到底需要多少钱?
文本生成图像的领域早已经是一片红海,看上去已经卷无可卷了。
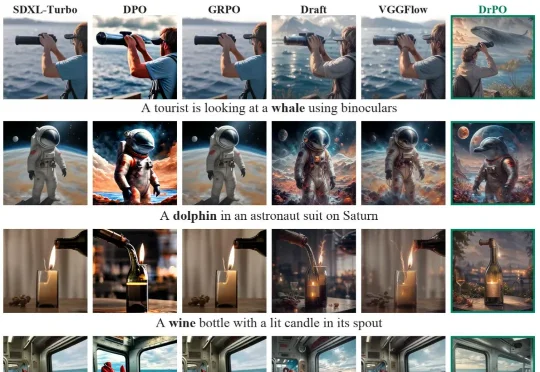
来自西湖大学和香港中文大学(深圳)的团队沿着这一思路提出 Drifting Preference Optimization(DrPO),把漂移场用于单步文生图模型的偏好后训练。在 DrPO 中,奖励只负责对候选图像排序,不参与反向传播。具体而言,针对同一个文本提示词,当前模型生成一组候选图像。高分样本在特征空间中产生吸引,低分样本产生排斥,并结合参考模型约束给出模型的更新方向。
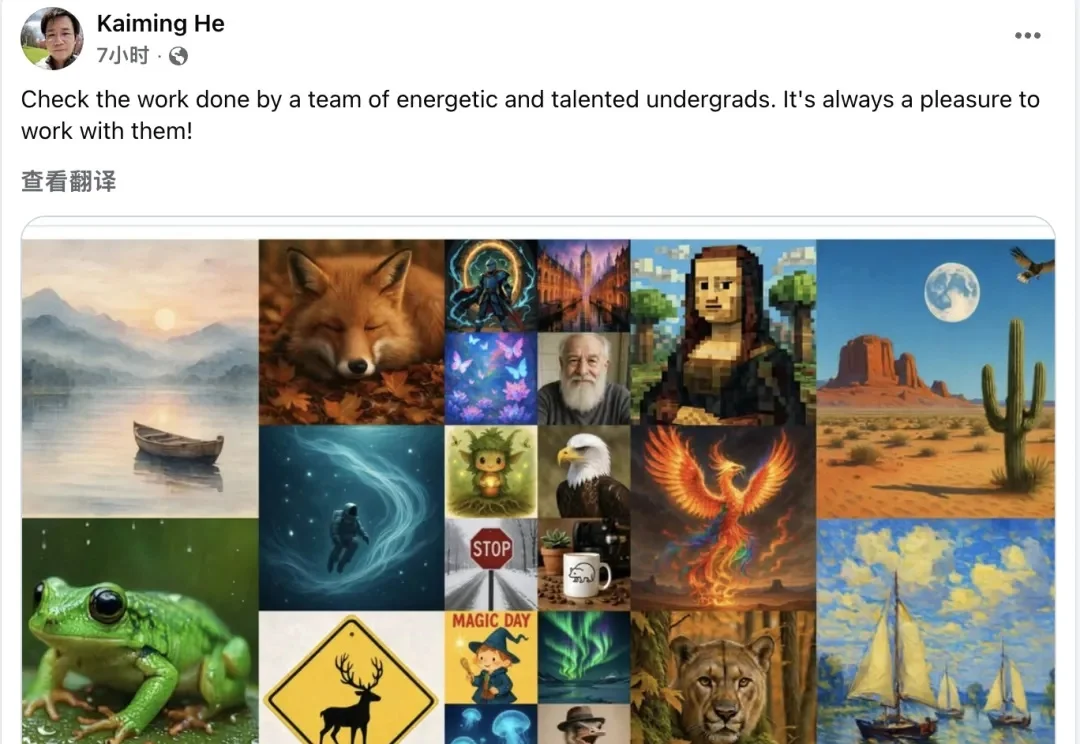
全员本科生! 刚刚,何恺明携本科生“军团”又放出一篇新论文。
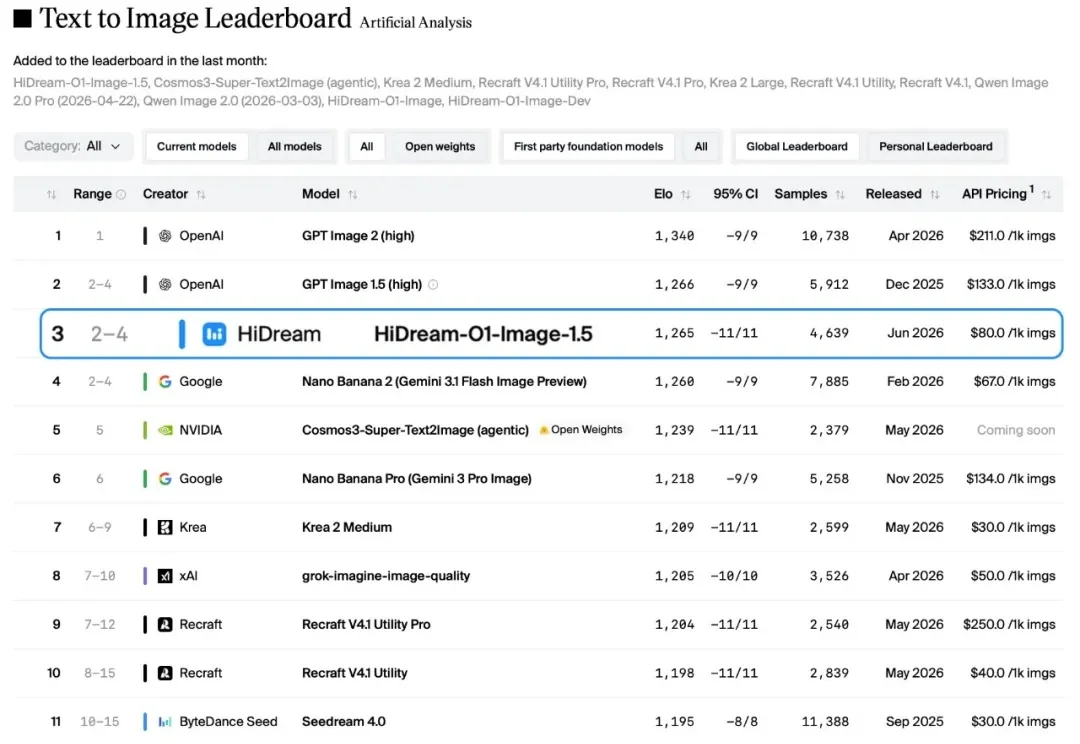
文生图的"慢思考",到底有没有用?