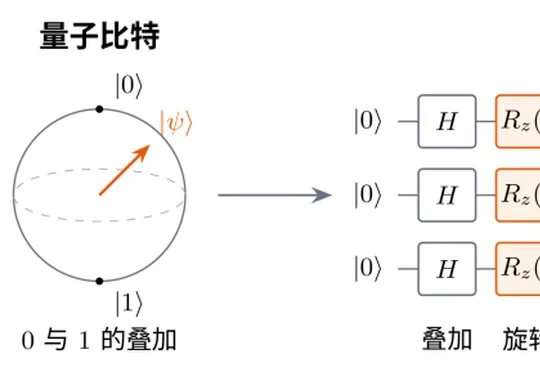
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
来自主题: AI资讯
7570 点击 2026-10-24 13:40

 搜索
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
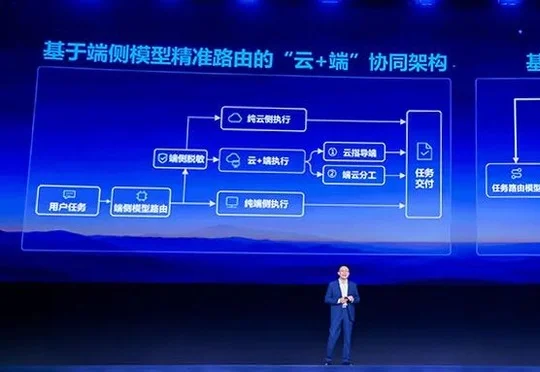
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
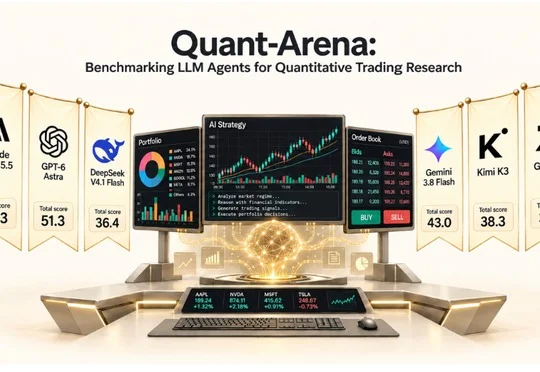
EinsiaAI旗下Navers Lab发布Quant Arena,将6家厂商的9个模型置于A股历史数据中评测,4个代表策略盈利、5个亏损,最佳GPT-6 Astra年化收益10.7%仍低于17.1%的市场基准。
这两年大模型圈有一条几乎没人怀疑的信条,Scaling Law。
用 AI 最让人崩溃的瞬间,莫过于你花半天纠正它把任务做对,换个新会话,它转头又踩进同一个坑里。模型做过了事,却没变成它的成长。跑通单次任务之外,它真正缺的是把反馈转化为经验,并在之后主动调用。
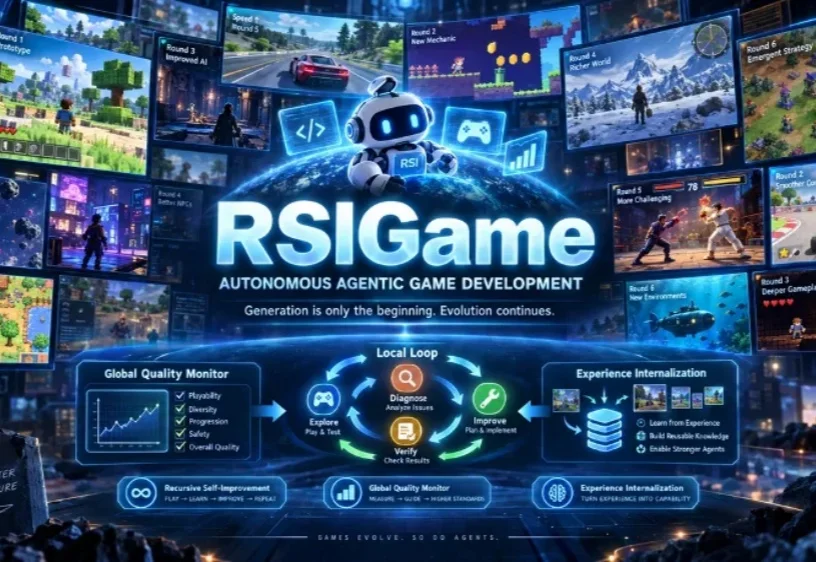
现在的大模型,已经越来越擅长从自然语言直接生成一个可以运行的游戏。
上月发布 GPT-6-Astra 时,OpenAI 称它为「全球智能程度最高且最符合人类意图的模型」。具身社区则是惊讶的发现,VLA vs WAM 的路线之争,被通用大模型用文字模态「降维打击」了,大家不禁想问:
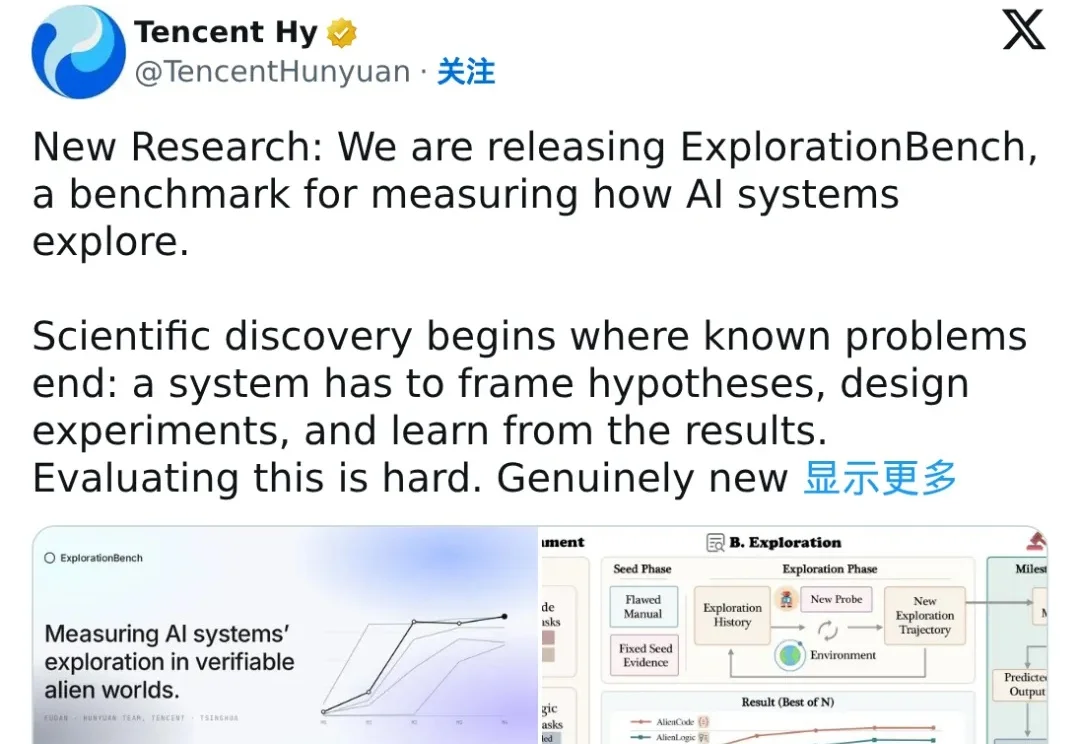
近日,腾讯混元官方账号(@TencentHunyuan)在 X 上发布了一项新研究:ExplorationBench,一个专门衡量 AI 系统如何「探索」的评测基准;随后,腾讯 AI 官方账号(@TencentAI_News)也发文进行了专题推介。
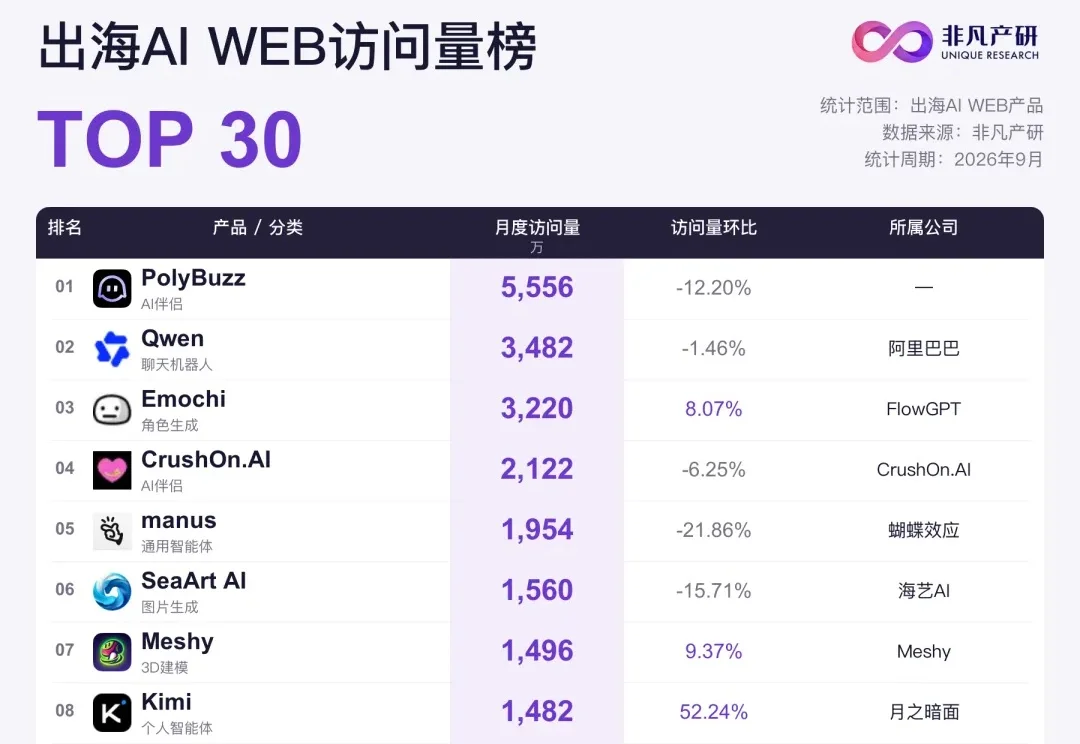
即便通用大模型的图像、视频能力越来越强,消费者依然持续为垂直创意工具付费
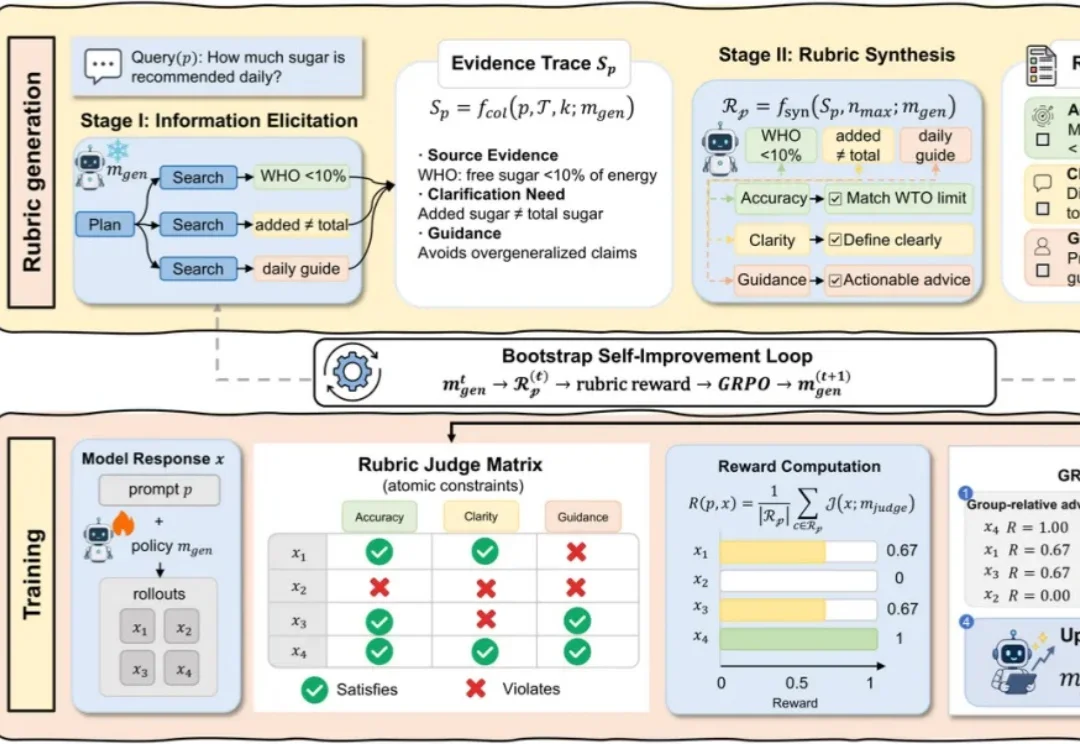
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。