Meta新研究:字节模型蒸馏后,天花板破了
Meta新研究:字节模型蒸馏后,天花板破了Token词元替代了Byte字节,但不意味着大模型都得是Token。
来自主题: AI技术研报
5704 点击 2026-09-15 13:59

 搜索
Token词元替代了Byte字节,但不意味着大模型都得是Token。
AI 的竞赛正在经历一次深刻的转向。过去两年,行业目光从“卷参数”转向“卷推理”,如今新的分水岭已经显现:AI 能否从数字世界走进物理世界,真正去“行动”?
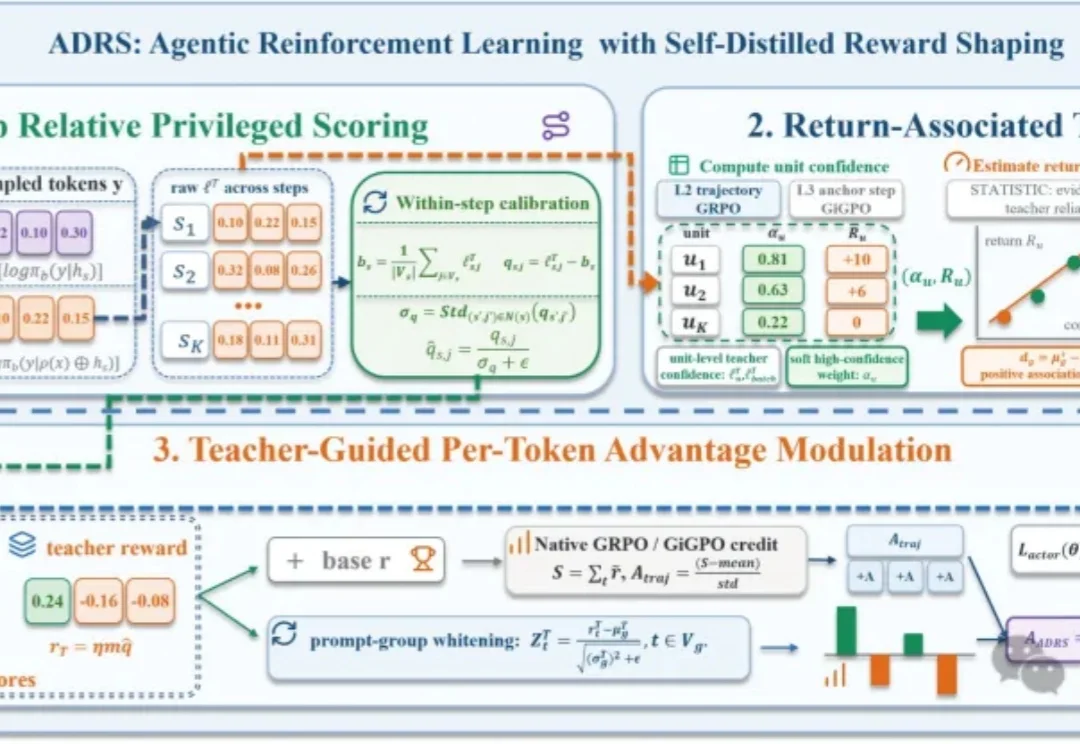
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。

清华大学AI Agent课题组提出加速扩散语言模型单元测试生成的框架DiffuTester,通过抽象语法树动态挖掘多个测试用例间的共享结构模式,在解码过程中保留相关token,在保持测试覆盖率的同时实现最高约2–3倍加速,相关论文已被EMNLP 2026接收。

趋境科技通过部署SGLang HiCache+Mooncake Store,将KV Cache从单机资源升级为集群级共享池化资源,支撑其日均产出超万亿Token的生产实践,KV Cache命中率稳定突破90%,并在生产环境中持续优化大规模推理集群的性能与稳定性。
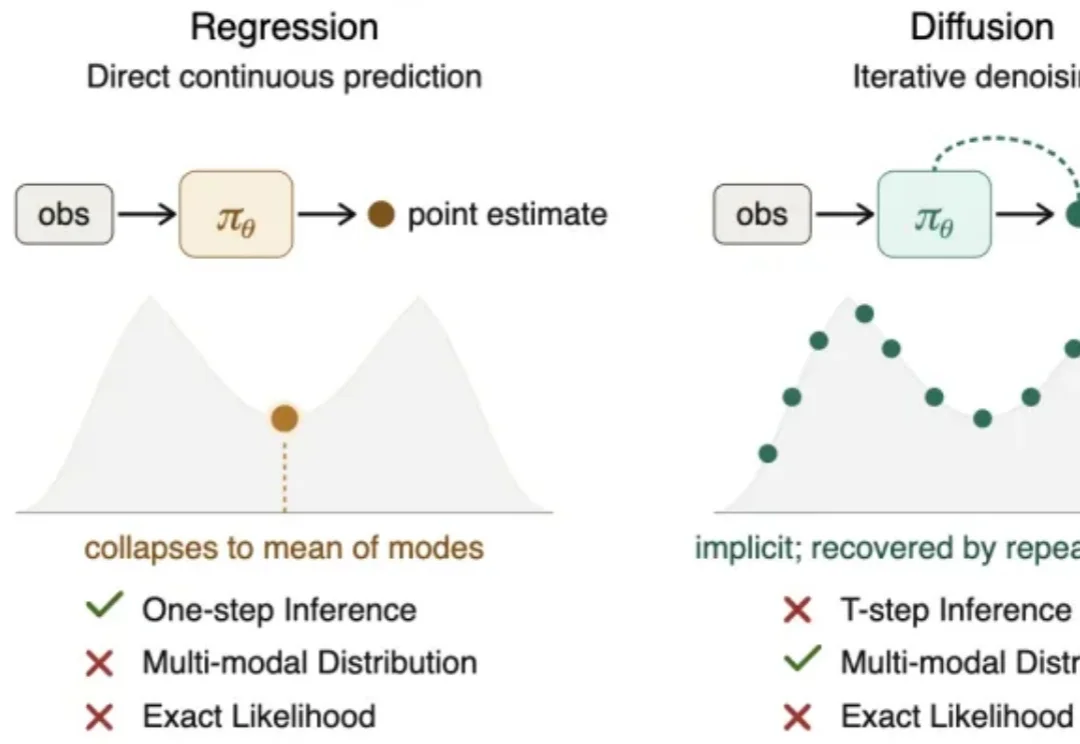
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
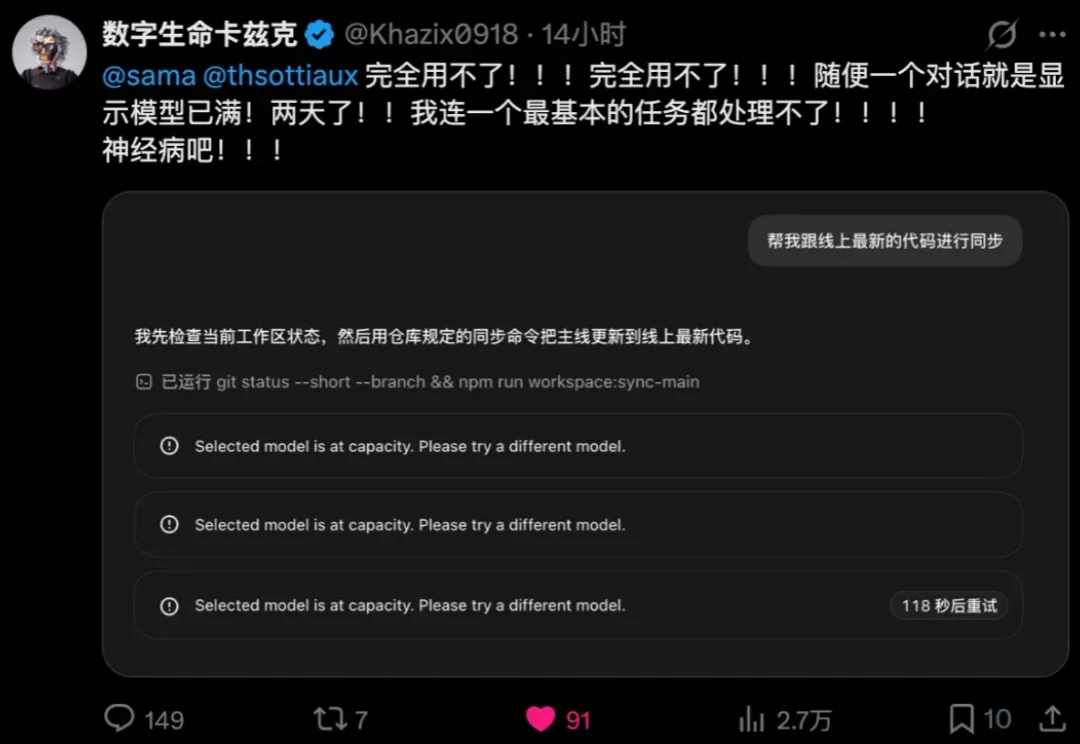
这几天,大家应该都用GPT-6 Astra了吧。
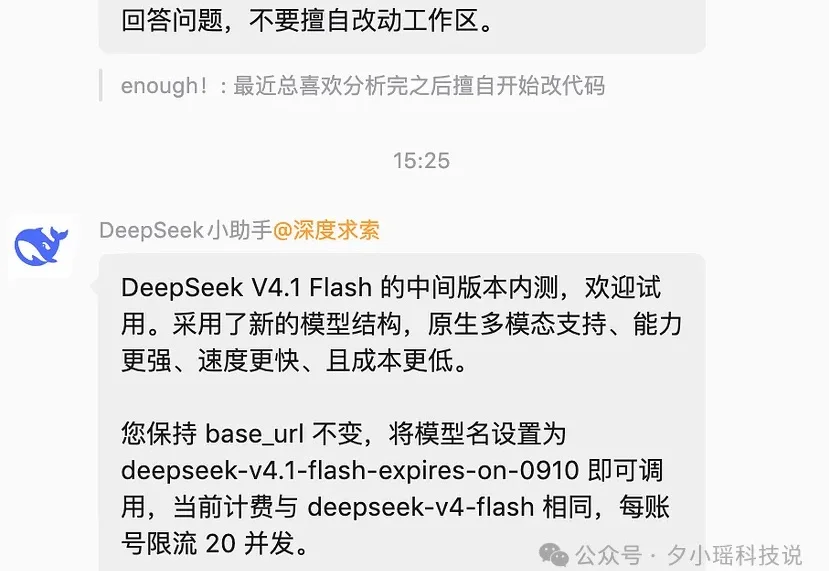
家人们,DeepSeek V4.1 Flash 开启内测了。
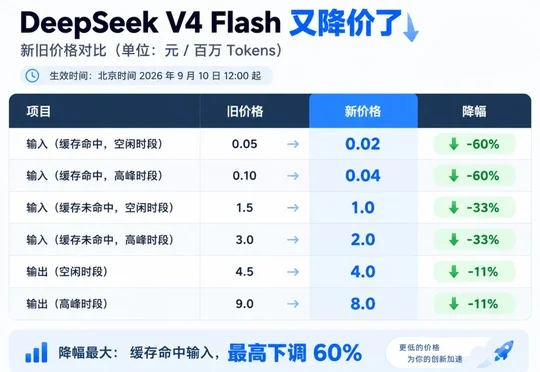
DeepSeek Flash系列自明日中午起降价,闲时缓存、输入和输出价格分别降至每百万Token 0.02元、1元和4元,新模型DeepSeek v4.1 Flash也已上线。
发力算电协同Token工厂,已融资5轮。