中国AI刷爆英伟达GPU性能榜,这家公司拿下88项第一
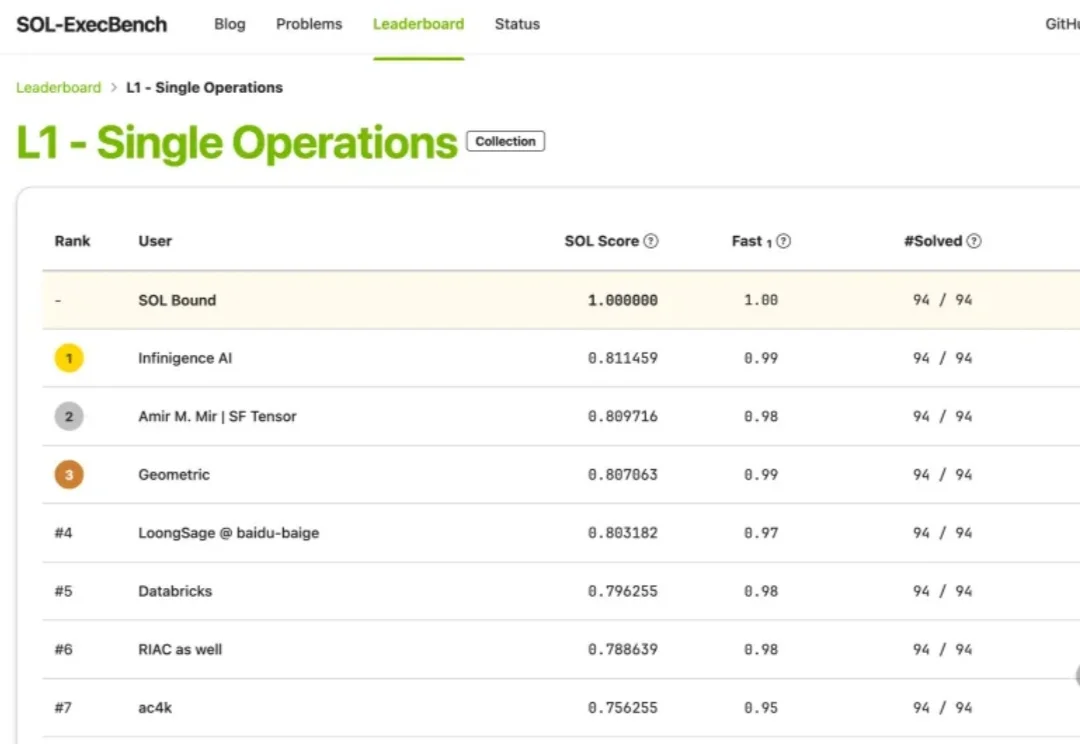
中国AI刷爆英伟达GPU性能榜,这家公司拿下88项第一近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
来自主题: AI资讯
9367 点击 2026-10-29 11:49

 搜索
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
用户借助 Claude Code 制作开源项目 TV Detox,在逐项确认后关闭 Android 电视广告和预装应用;OpenAI 评测显示 GPT-6.1 Sol 迁移 COBOL 的隐藏测试准确率最高达 97.9%,但真实银行系统仍需专家审查。
GPT-6.1 Sol,默认上下文直接冲到500k!
OpenAI发布GPT-6.1 Sol Ultraffast模式,速度最高提升至标准版8倍但价格为其6倍,因标准版速度过慢且订阅开放受限,被用户质疑为“变相涨价”。
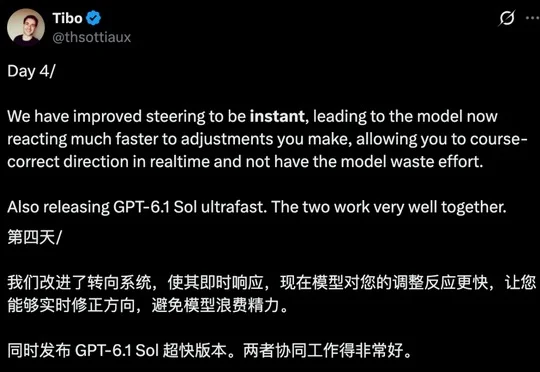
OpenAI推出GPT-6.1 Sol Ultrafast,智能水平接近Astra、最高速度为Sol标准版8倍,API定价为每百万输入token 12美元、输出60美元,Codex和ChatGPT Work仅向特定高阶用户开放。
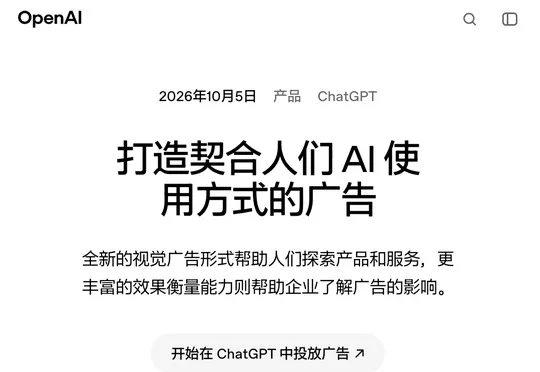
OpenAI开启Codex“疯狂28天”计划,首日宣称将GPT-6 Astra和GPT-6.1 Sol默认推理速度提升约50%至50TPS,但用户实测低于预期,叠加ChatGPT测试广告、欧盟文本隐形水印及订阅调整引发质疑。
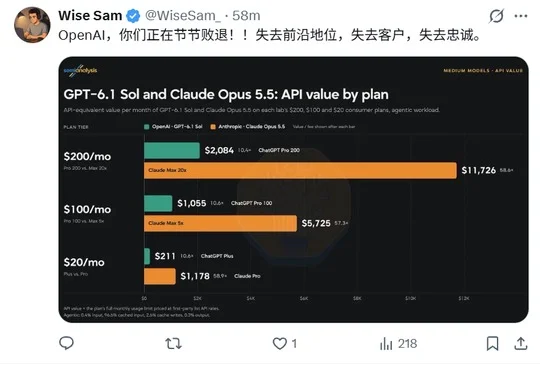
OpenAI将订阅用户使用GPT-6 Astra和GPT-6.1 Sol的速度提升约50%,但SemiAnalysis实测称Anthropic订阅的API等价价值约为OpenAI的5倍,OpenAI 200美元套餐额度也已减半。
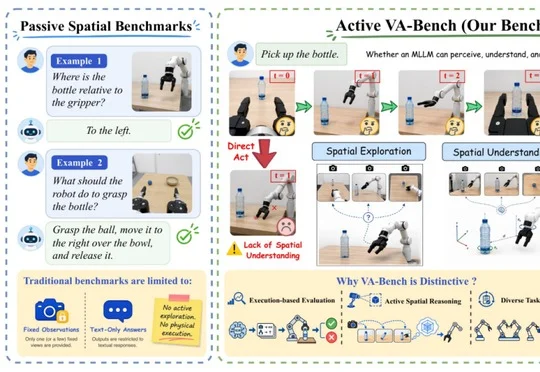
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
OpenAI在开发者日后因GPT-6.1 Sol实际体验不及预期、使用额度收紧等问题遭遇用户信任危机,Tibo承诺未来将进行连续28天发布或重置,并将简化产品、提高效率作为核心方向,以兑现此前过度宣传的承诺。
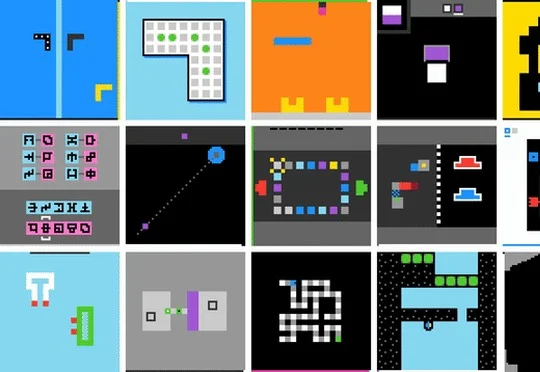
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。