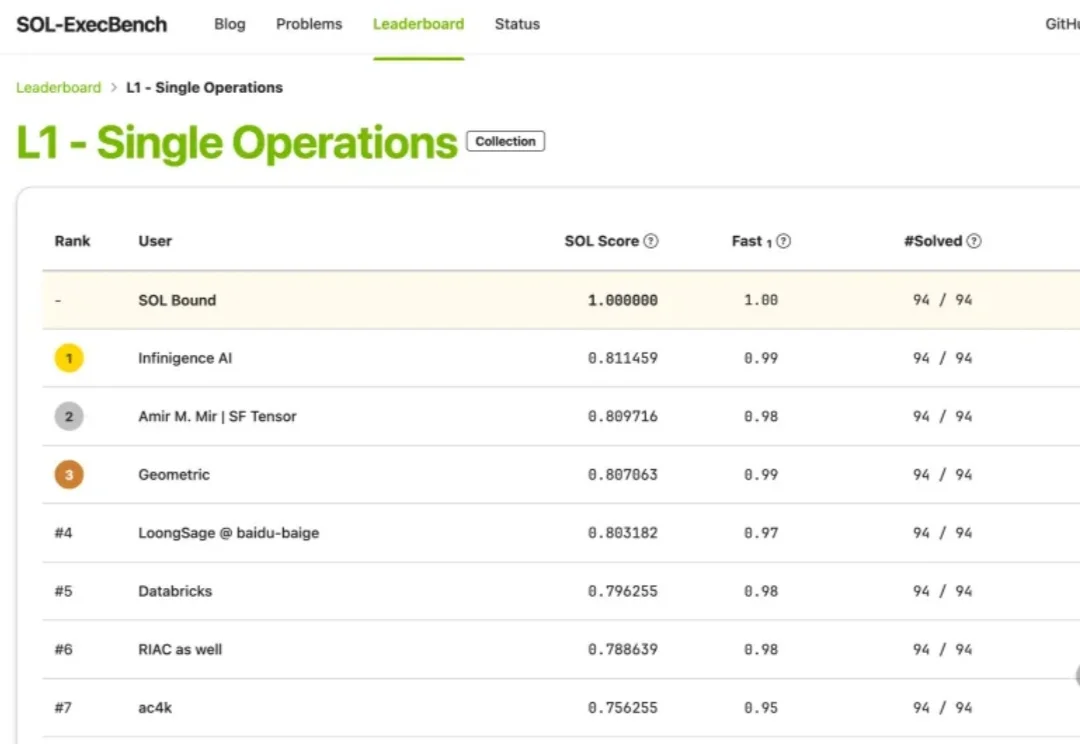
中国AI刷爆英伟达GPU性能榜,这家公司拿下88项第一
中国AI刷爆英伟达GPU性能榜,这家公司拿下88项第一近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
来自主题: AI资讯
9355 点击 2026-10-29 11:49

 搜索
近日,在NVIDIA Research推出的GPU算子性能评测榜单SOL-ExecBench [1] 上,无问芯穹(Infinigence AI)取得亮眼成绩: 先后登顶L1基础算子、L2融合算子、Quant量化算子与FlashInfer-Bench推理算子全部四大赛道。
10 月 22 日,Arc 宣布将于 12 月 22 日关闭桌面端,工程与安全团队转向新浏览器 Dia。用户可以把密码、书签、扩展和历史记录迁过去,继续使用熟悉的功能,也可以选择开启 AI。
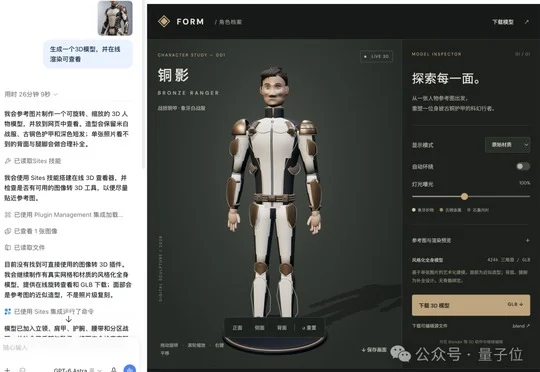
Hi3D正式开放V1.0模型代码,这款基于Sparc3D、约用200万个3D资产训练的国产可商用模型支持研究与部署,最新V3.0达到2048³分辨率并由Hi3D Agent用于3D创作。
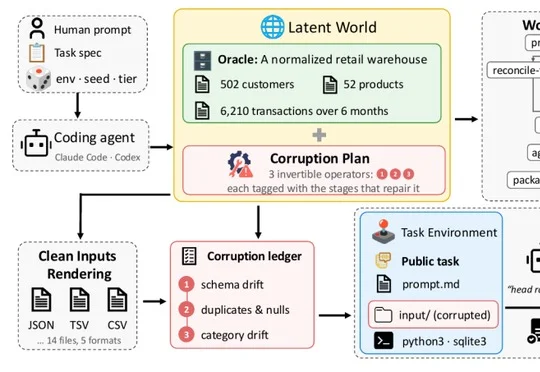
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。
谷歌,终于把这块最硬的骨头啃下来了。
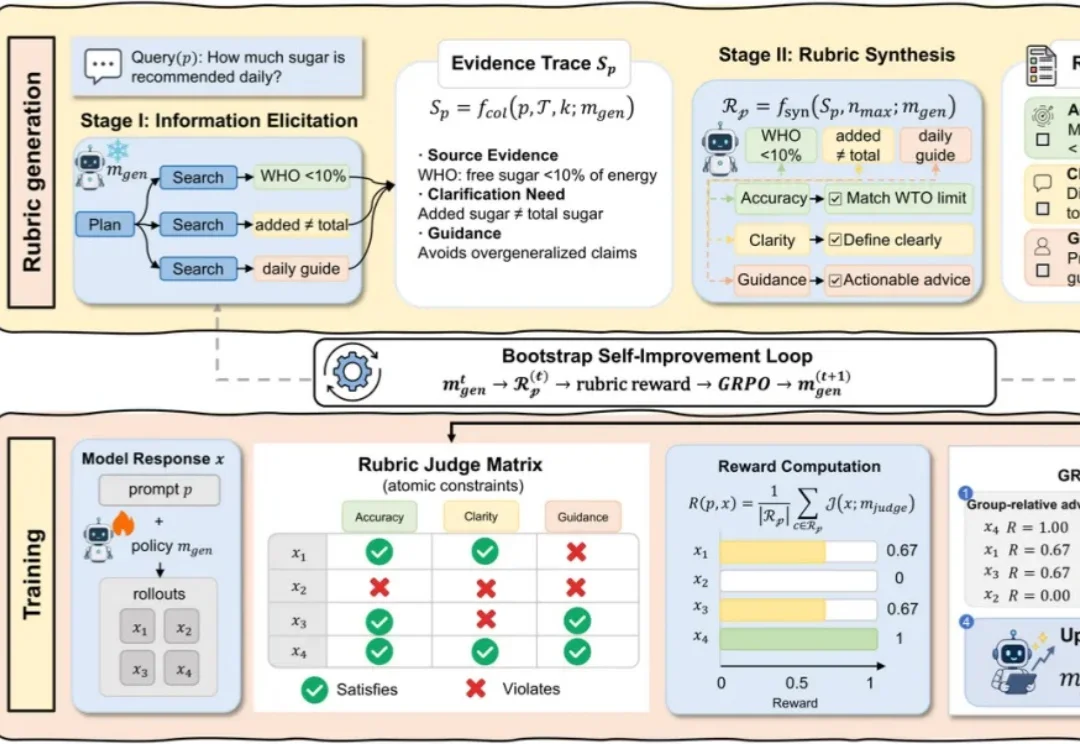
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
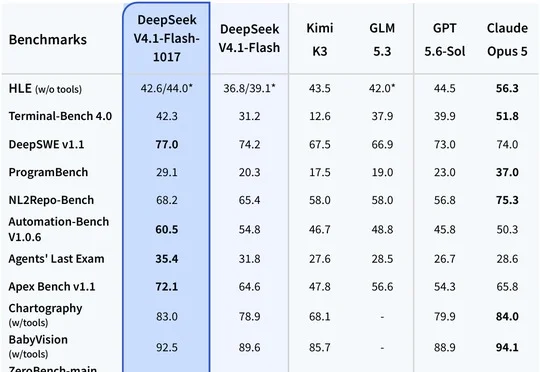
DeepSeek官宣DeepSeek-V4.1-Flash-1017全面上线,网页、App和API同步更新且价格不变,在DeepSWE v1.1取得77%最高分,并开放MIT许可证权重及Search/Fetch搜索API。
RSI正在从长期的理论命题,逐步走向可验证的技术实践,硅谷新共识已经形成。以Anthropic和OpenAI为代表的全球头部模型公司,2026年9月,Anthropic披露,Claude已参与其超过80%的代码合并工作,OpenAI也明确将目标锚定为2028年3月前实现自动化AI研究员。
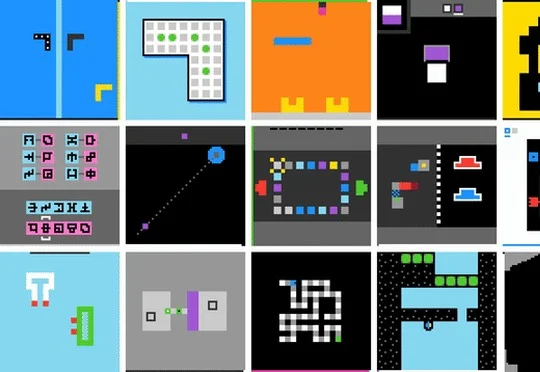
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
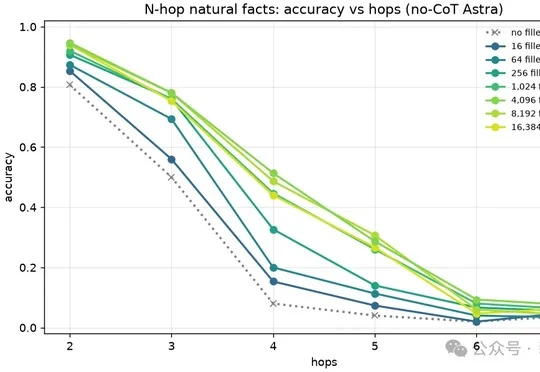
Redwood Research发现GPT-6 Astra能将题目后的空白Token当作思考空间,在四跳推理测试中准确率从约10%升至50%、旧AIME题从约60%升至约90%,这一现象引发对AI思维链监控有效性的担忧。