AI 负责创造,人来干脏活,这事儿能否停一下?
AI 负责创造,人来干脏活,这事儿能否停一下?"AI 不会替代人类,反而会承接大量低价值工作,让人类有时间去做一些创造性工作。"
来自主题: AI资讯
9206 点击 2026-09-15 10:33

 搜索
"AI 不会替代人类,反而会承接大量低价值工作,让人类有时间去做一些创造性工作。"
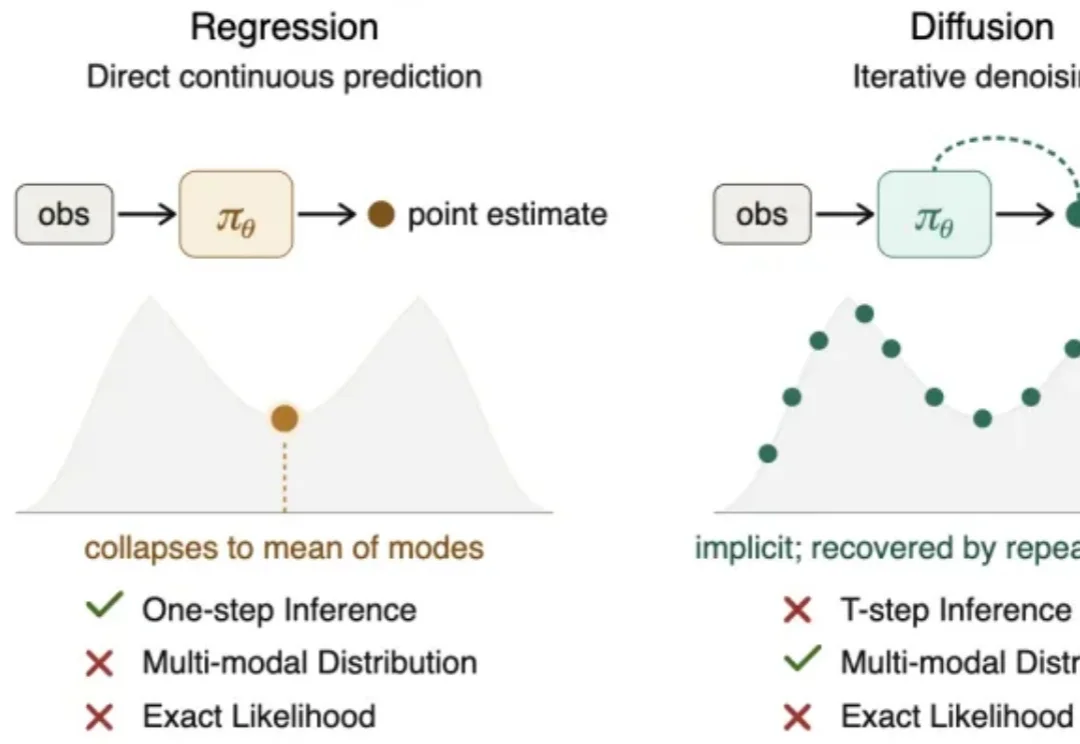
If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。
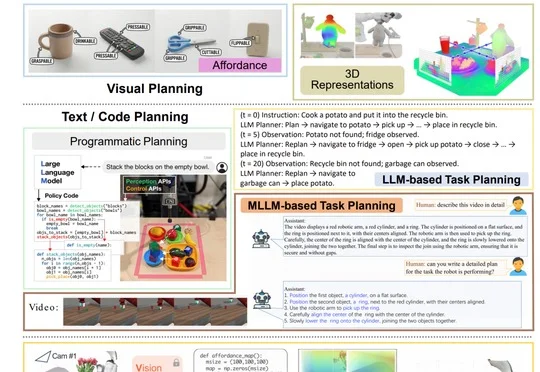
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
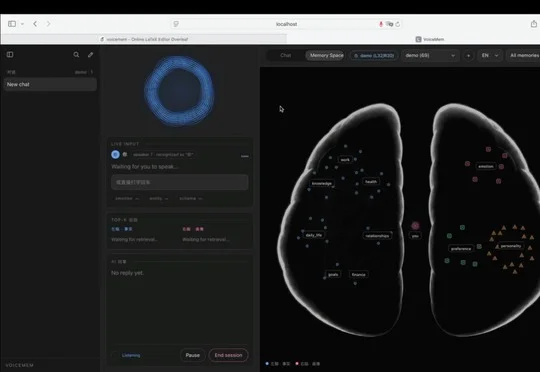
颜水成团队发布语音领域首个实时“流式双脑架构”记忆框架,左脑记信息,右脑记住你。 编辑丨岑峰 科幻电影曾无数次预演过AI与人类共生的场景。但在2026年的今天,尽管GPT-4o、全双工模型、Inter
近期Product Hunt热门AI产品Acti、Wispr Flow、Hey Noah、Pazi、Glaze、AnySearch、Context.dev和OpenSEO不再执着于打造更聪明的ChatGPT,而是分别争夺意图入口、任务执行权、软件生产成本降低以及面向Agent的基础设施,将AI嵌入键盘、语音、邮件等日常工作流程。
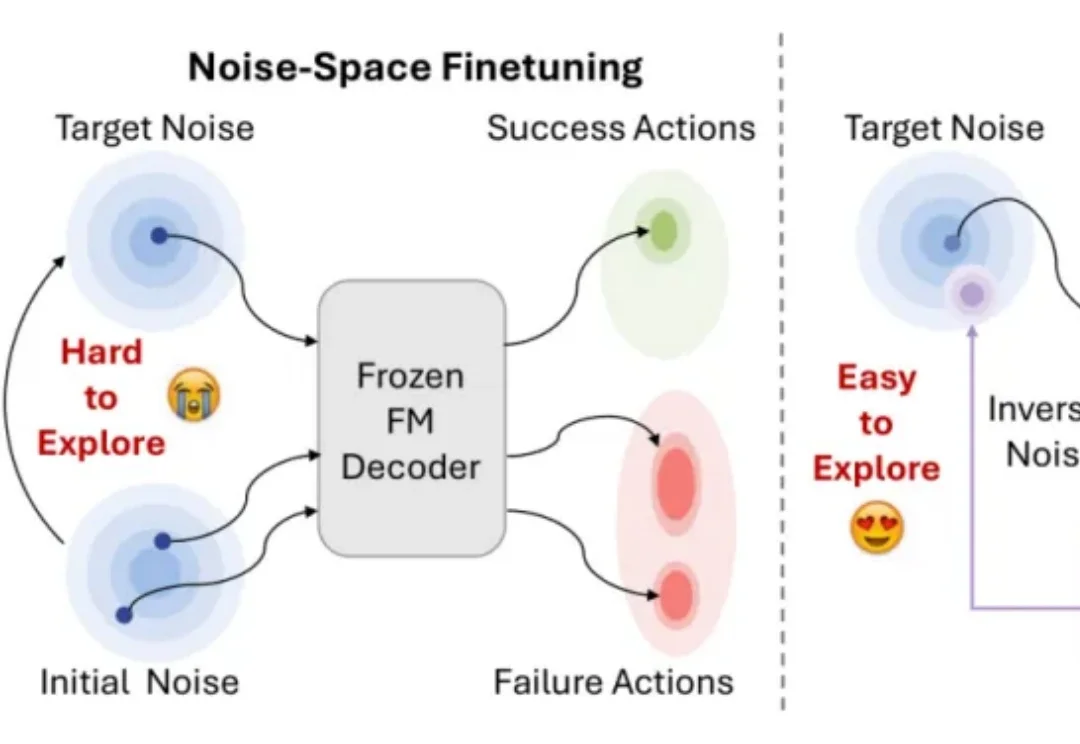
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
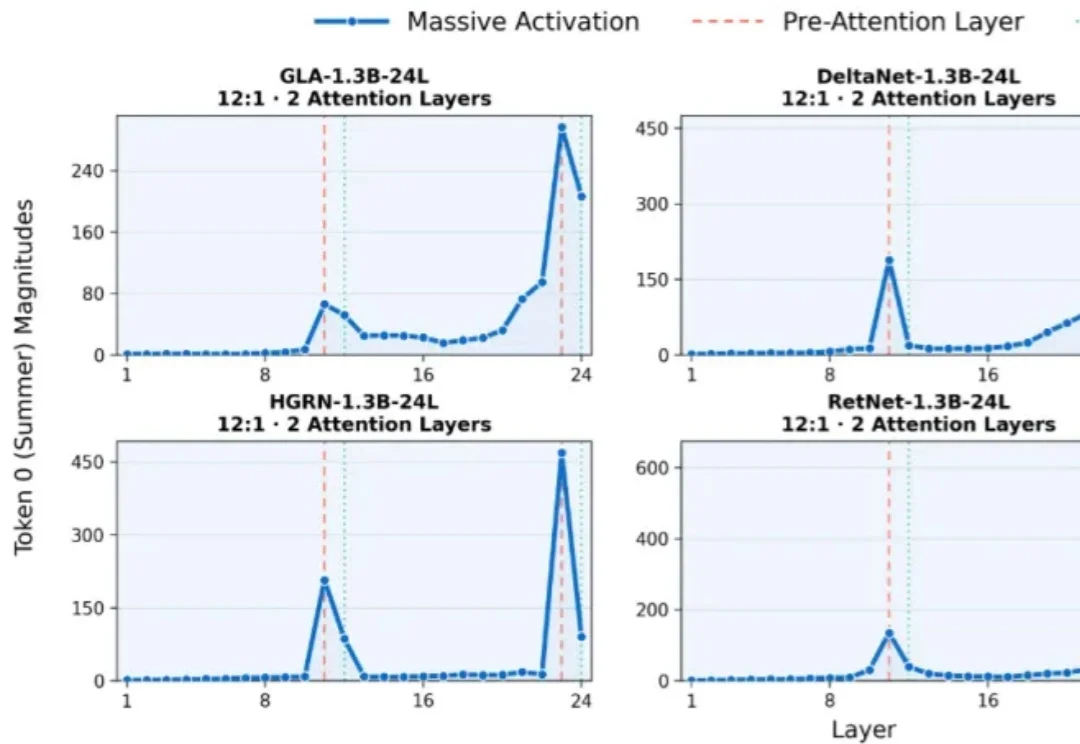
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。

在 action chunking 已成为 VLA 标配的今天,「一次执行多少步」几乎被所有工作当作一个固定的超参数。

8 月 10 日,戴盟机器人正式发布全球首个触觉锚定世界模型 Daimon-TWM(Tactile-grounded World Model),以原生触觉贯穿物理认知、推演决策和瞬时反应全阶段。这个 “物理交互脑” 不仅能理解正在发生的物理接触,还能预测下一步交互会发生什么,并根据瞬息万变的反馈及时修正动作。

本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。