个性化智能体强化学习框架上线,8B模型盲测第一
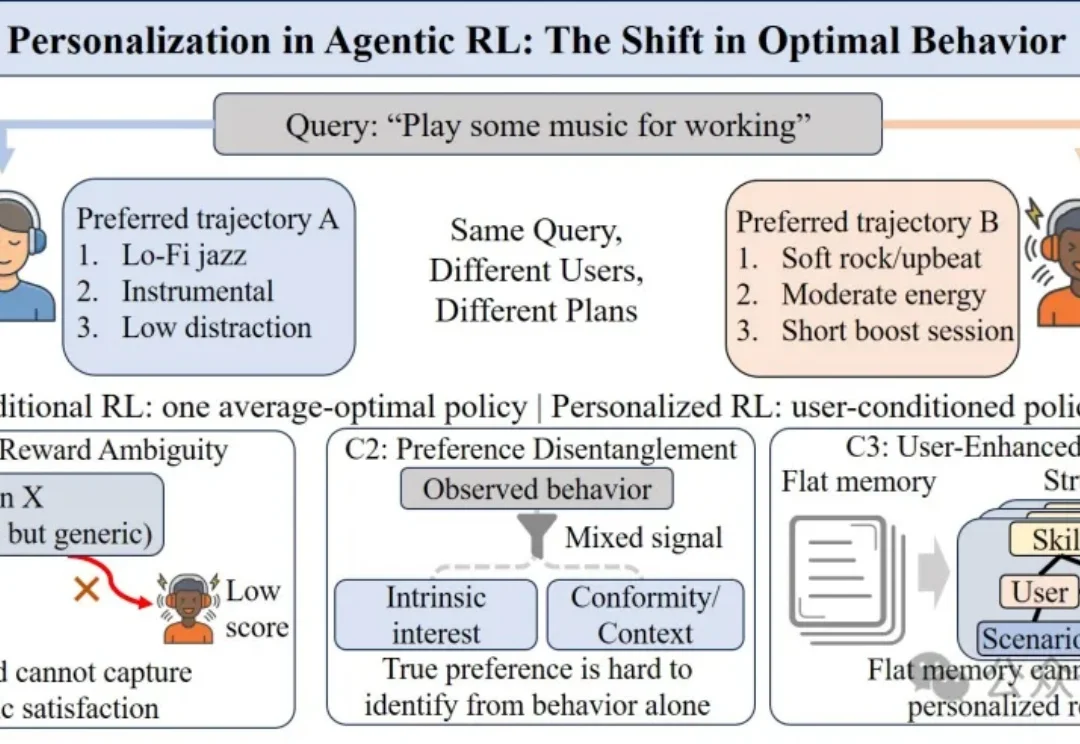
个性化智能体强化学习框架上线,8B模型盲测第一当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。
来自主题: AI技术研报
9014 点击 2026-09-14 09:22

 搜索
当个性化Agentic RL遇上现实用户平台场景时,一直存在一个常见难点:面对同样的query,不同用户往往偏好不同的规划策略、工具调用和最终表达。
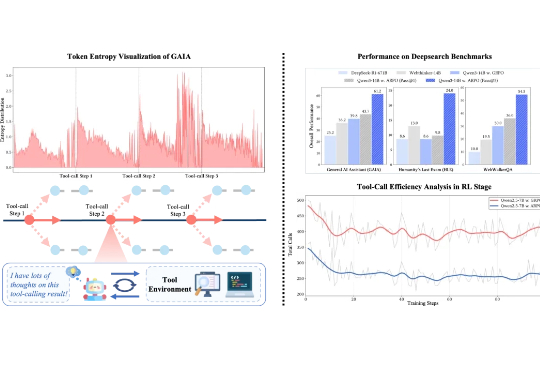
在可验证强化学习(RLVR)的推动下,大语言模型在单轮推理任务中已展现出不俗表现。然而在真实推理场景中,LLM 往往需要结合外部工具进行多轮交互,现有 RL 算法在平衡模型的长程推理与多轮工具交互能力方面仍存在不足。