面壁智能推出AI写的预训练框架ForgeTrain,从此AI开始造自己
面壁智能推出AI写的预训练框架ForgeTrain,从此AI开始造自己造AI这件事,现在的主角变成了AI。
来自主题: AI技术研报
8282 点击 2026-05-26 16:03

 搜索
造AI这件事,现在的主角变成了AI。
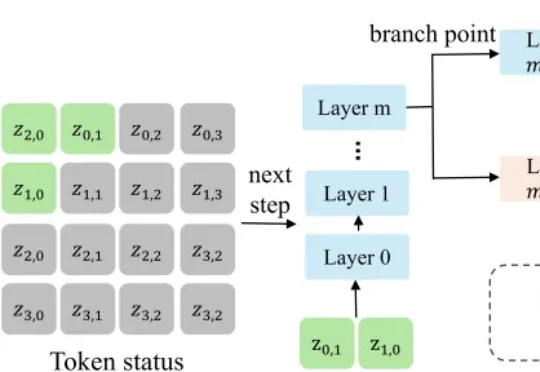
来自浙江大学和阿德莱德大学的研究团队提出了 FlashAR—— 一个轻量级的后训练加速框架。不需要从头训练,在 Emu3.5-Image-34B 模型上,仅用原始训练数据的 0.05%(约 8 万张图片),就能将预训练好的自回归模型改造成高度并行的生成器 Emu3.5-34B-Flash,实现最高 22.9 倍的端到端加速。
姜旭是少数完整参与过 OpenAI 大模型核心技术演进的华人创业者之一。2019 至 2023 年间,他经历了 GPT 系列能力爆发最关键的阶段,工作横跨底层训练 infra、大规模预训练、RLHF 对齐算法与数据构建等核心链路。
5 月 19 日,OpenAI 联合创始人、「Vibe Coding」之父 Andrej Karpathy 宣布加入 Anthropic 预训练团队。他将组建新团队,用 Claude 加速预训练研究。一个做过Hinton和李飞飞学生、奥特曼同事、马斯克直属下属的人,为什么甘愿做 Dario Amodei 的「-2」?Anthropic 又为什么非要招他?
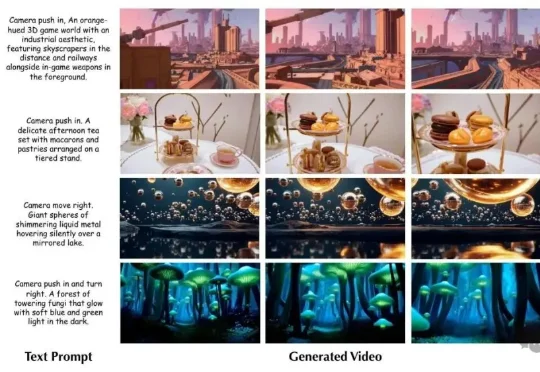
浙大联合微软亚洲研究院最新提出的World-R1,不改架构、不要3D数据,纯靠强化学习就让视频生成模型学会了“理解”三维世界。World-R1 的出发点很简单:预训练的视频模型里面已经有 3D 知识了,只是“沉睡”着。用强化学习把它叫醒就行。
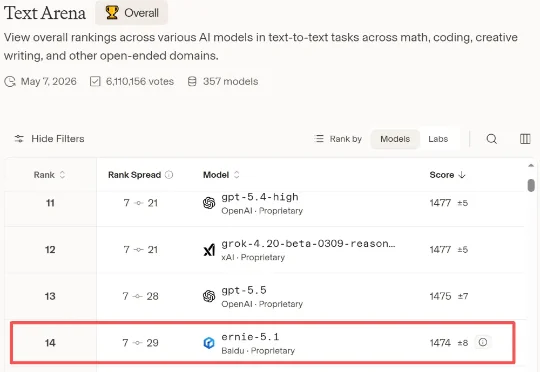
今日,百度推出新一代基础模型文心5.1。百度称,文心5.1将总参数压缩至约1/3、激活参数压缩至约1/2,使用业界同规模模型约6%的预训练成本,实现同级别模型基础效果领先。不过,百度并未明确说明这一“6%成本”的具体对标模型范围与口径。
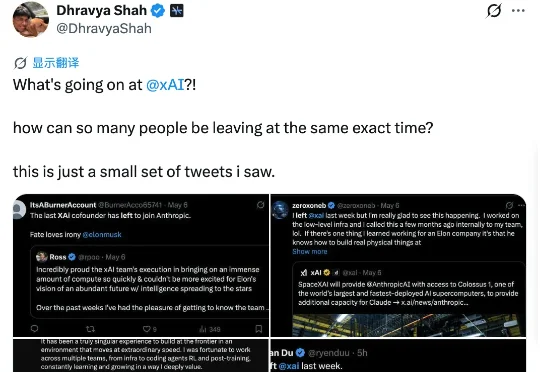
刚刚,xAI再失一名华人大将。就在今天,预训练负责人庄钧堂官宣了自己的离职消息。此前,庄钧堂已经在xAI工作了两年。这期间,他主导了从Grok 2到Grok 5的全系列预训练,同时负责Grok在X和Tesla上的语音模型及xAI企业API模型。
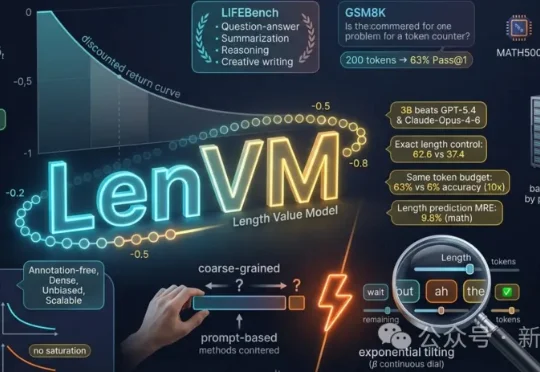
LenVM将长度建模提升到token级别,开辟可扩展价值预训练的新维度——3B开源模型精确长度控制全面击败GPT-5.4、Claude-Opus-4-6等顶级闭源模型;相同token预算下推理准确率提升10倍(63% vs 6%);沿模型规模、数据量、采样数三轴无饱和scaling的value pretraining
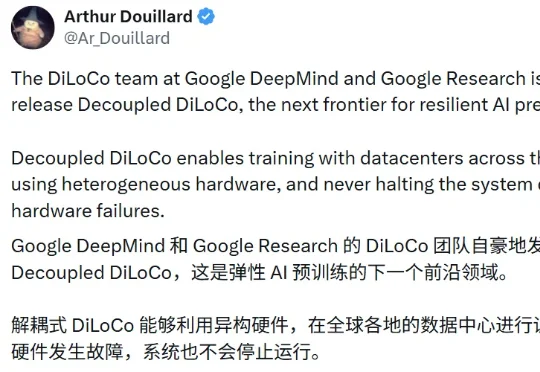
弹性 AI 预训练已经推进到了下一个前沿!没有意外:来自谷歌。据介绍,他们提出的 Decoupled DiLoCo 是一种革命性的分布式训练技术,能够利用全球各地的异构硬件进行训练,并且即使当硬件发生故障时,系统也不会停止运行!
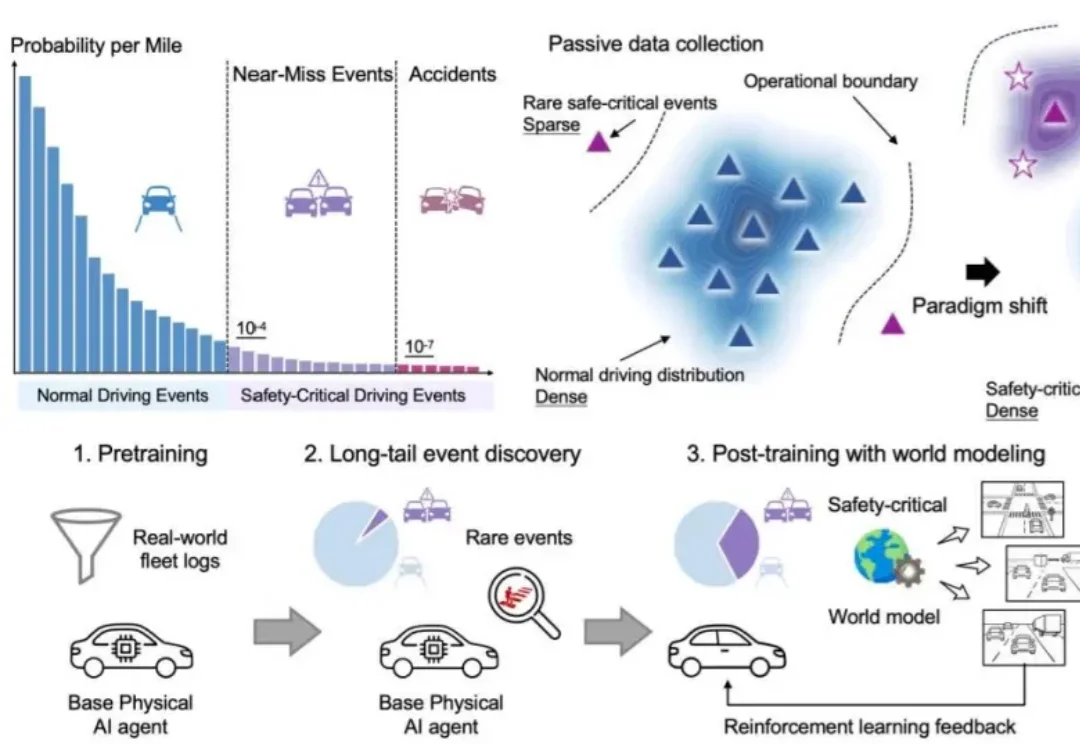
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。