MiniMax Design 来了,视频模型也有了自己的 Codex
MiniMax Design 来了,视频模型也有了自己的 Codex当一个视频模型和 Seedance 2.5 同一天发布,似乎大概率要成炮灰,但 MiniMax H3 却成了一个例外。而现在 MiniMax 也开始把这种模型的能力,放到了具体的产品上,正式推出了 MiniMax Design,进一步把 H3 视频模型的能力放大,同时也让我们少折腾一些,可以更高效地制作各种商业化内容。
搜索
当一个视频模型和 Seedance 2.5 同一天发布,似乎大概率要成炮灰,但 MiniMax H3 却成了一个例外。而现在 MiniMax 也开始把这种模型的能力,放到了具体的产品上,正式推出了 MiniMax Design,进一步把 H3 视频模型的能力放大,同时也让我们少折腾一些,可以更高效地制作各种商业化内容。
Pixel 擅长表达 appearance,Code 擅长表达 structure;未来会进入 Pixel-Code 联合的视觉表达。
视频模型这个月很热闹。7 月 31 日,MiniMax H3 和字节跳动 Seedance 2.5 同日发布。3 天后,MiniMax H3 正式开源;8 月 7 日,Seedance 2.5 开放 api。模型越来越好了,但产品能把它用好吗?
新智元报道 这个 8 月,AI 视频赛道的军备竞赛又升级了。 字节跳动发布 Seedance 2.5,把单次视频生成时长从 15 秒翻倍到 30 秒。同一天 MiniMax H3 开源,价格只要闭源旗
当下计算机视觉长期陷入“一任务一专用模型”内卷: 做深度估计要用DepthAnything,分割依赖SAM,人体姿态单独训练Sapiens,几何重建还得搭VGGT,各类网络骨干、解码器、损失函数完全割裂,研发与部署成本居高不下。
昨天躺床上刷手机,突然看到阿里计划发布他们目前最新的生视频模型:Wan3.0。在千问创作PC端(c.qianwen.com)公测,逐步开放。并且,全能参考,相比sd的视频、文本、图片、音乐4个基础模态,Wan3.0还支持了网页链接、word等文档。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
就在刚刚,字节跳动正式发布了自研视频模型Seedance 2.5,而我们熟悉的「即梦AI」作为模型的官方体验入口也第一时间妥妥接入。贴心的我呢,也直接帮友友们把这次新模型最夯夯夯夯的能力都扒好了,咱先一睹为快——
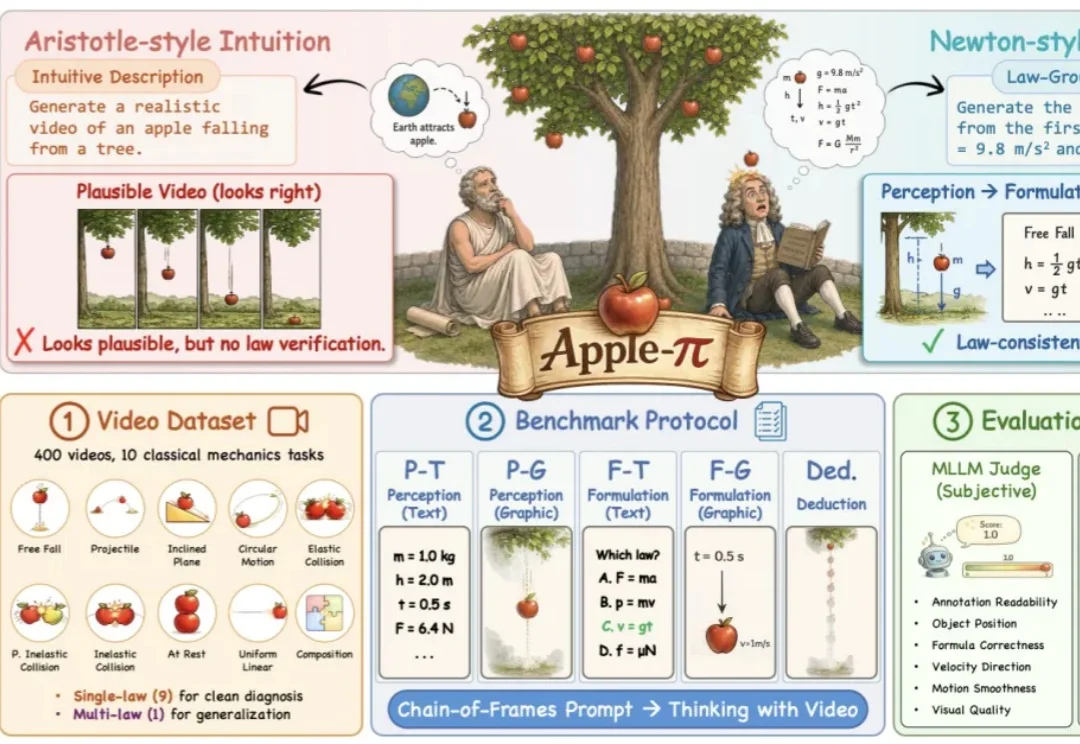
一个苹果从树上落下,今天的视频模型大多能生成一段「看起来正确」的运动:苹果向下、速度加快,最终落地。
我们先来看两个画面。