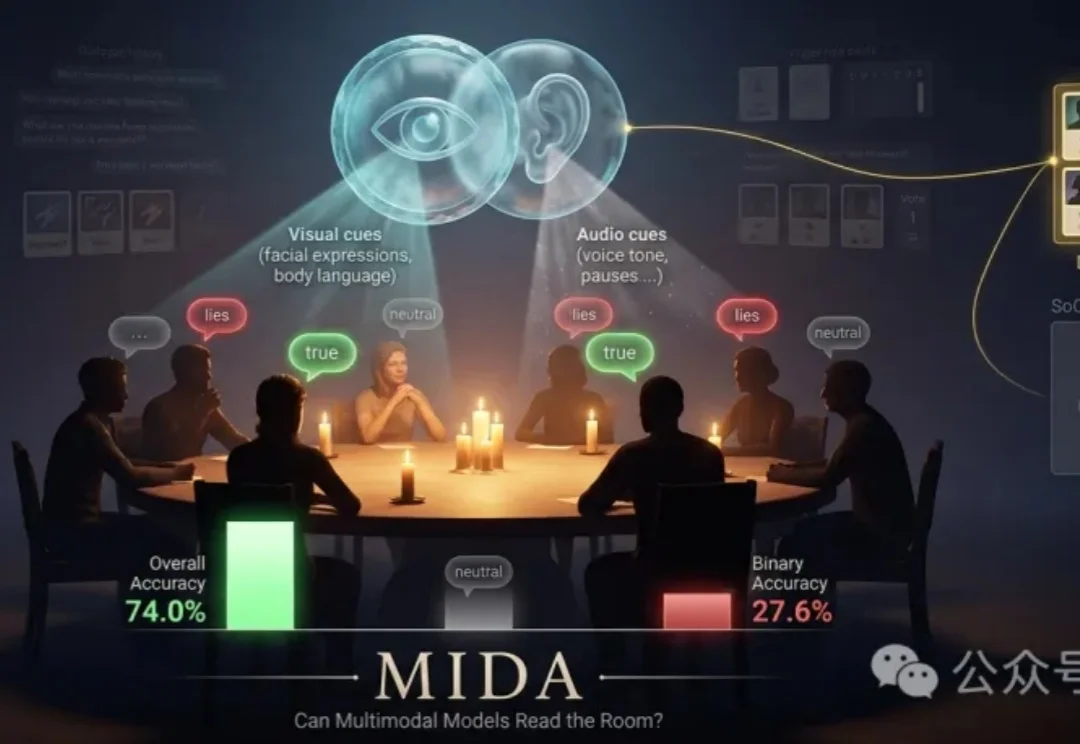
EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区
EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
来自主题: AI技术研报
8321 点击 2026-10-29 11:09

 搜索
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
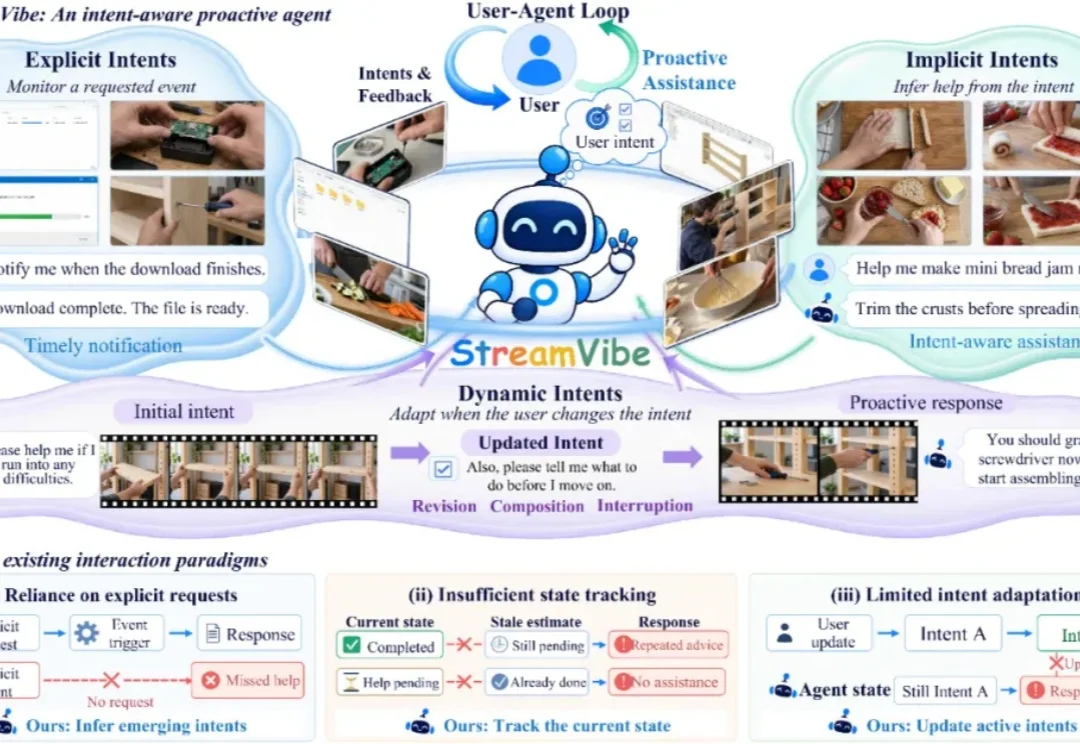
近期,Meta 的 Muse、OpenAI 的 Dot 等产品相继推出,让 Personal Agent(个人智能体)再次成为大模型领域的关注焦点。相比传统的对话助手,这类 Agent 不再局限于回答问题,而是能够结合用户的个人背景、历史记忆与应用上下文,主动执行任务并持续推进长期目标。一个更具主动性、能够长期陪伴用户的 AI 助手,正在逐渐成为现实。
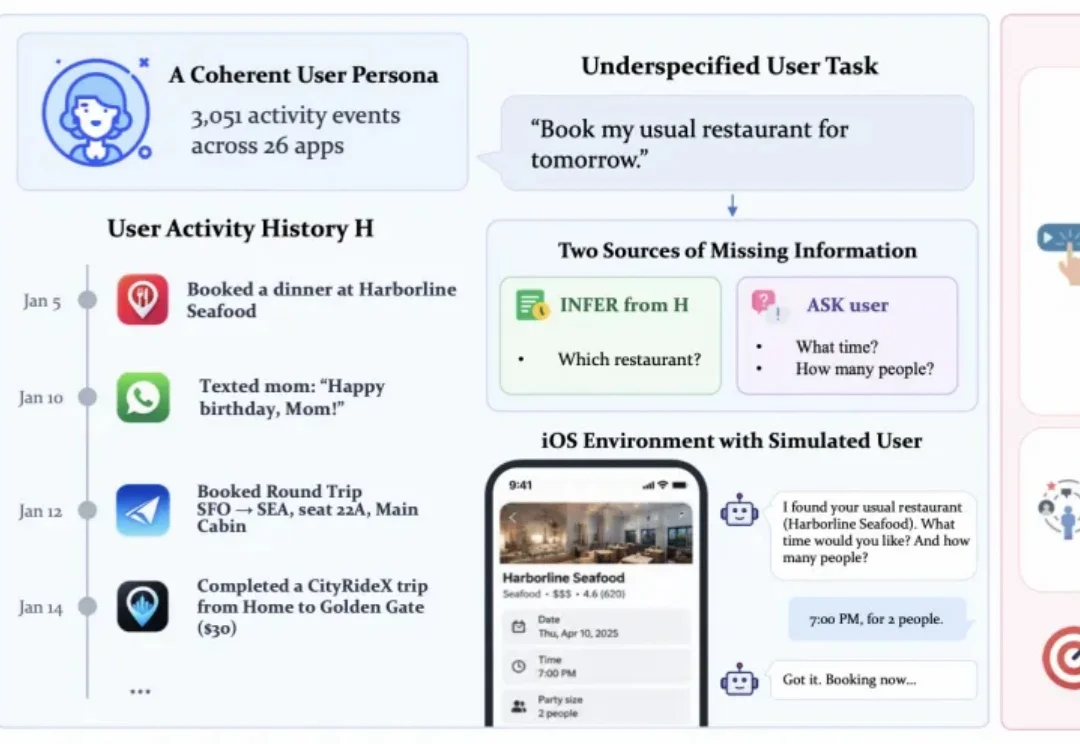
Personal Agent 目前已经能够独立完成许多复杂操作,但在决策时仍面临一个问题:什么时候应该直接推断,什么时候需要向用户追问。
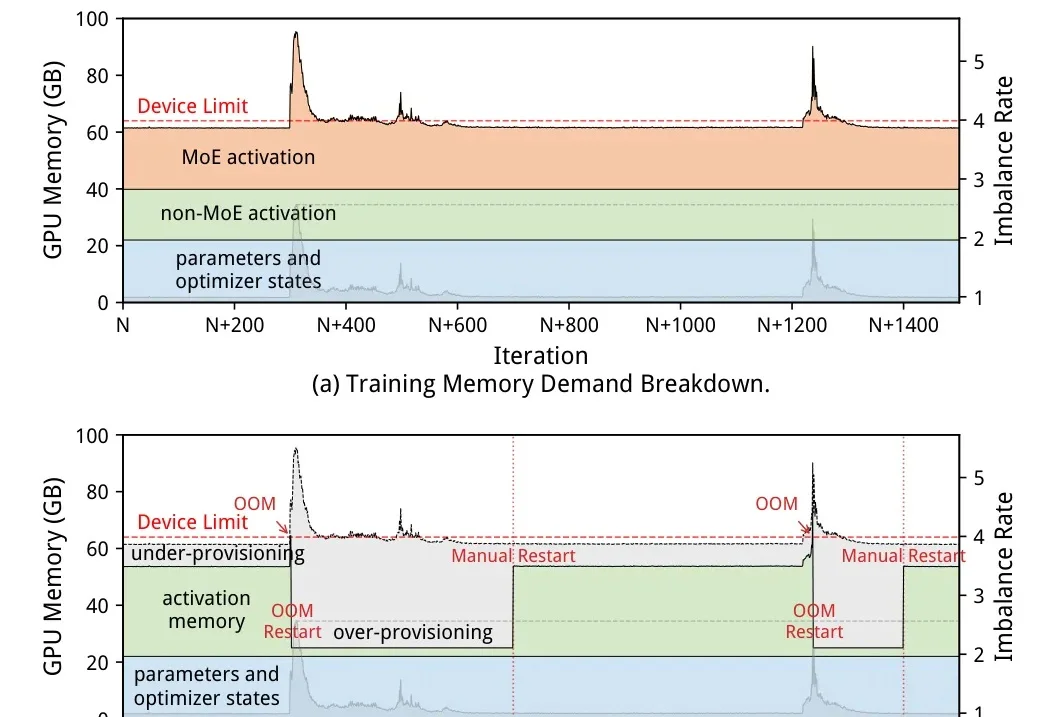
大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
现实版《盗梦空间》,真的来了!
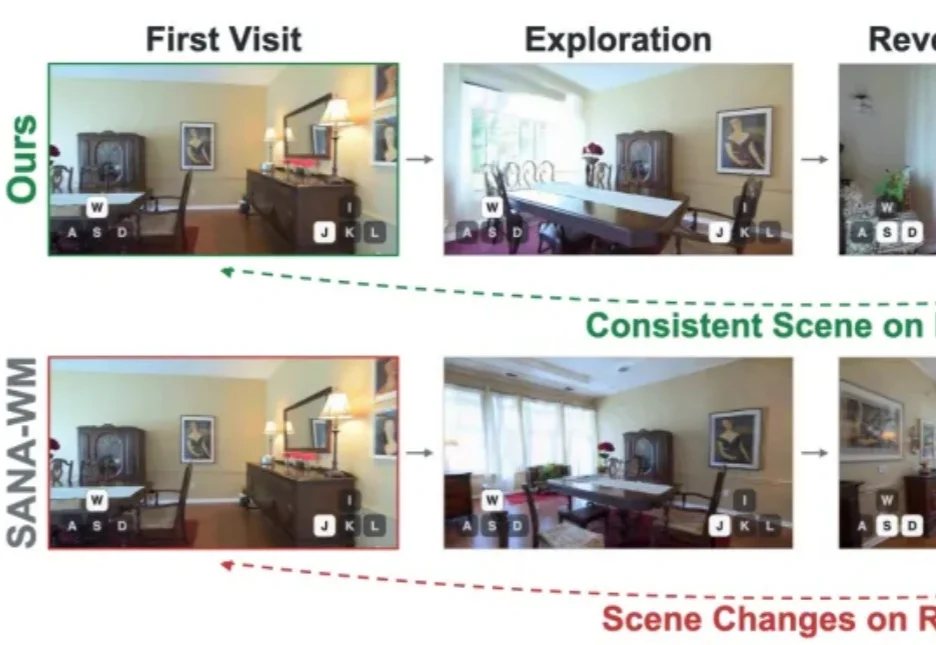
近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
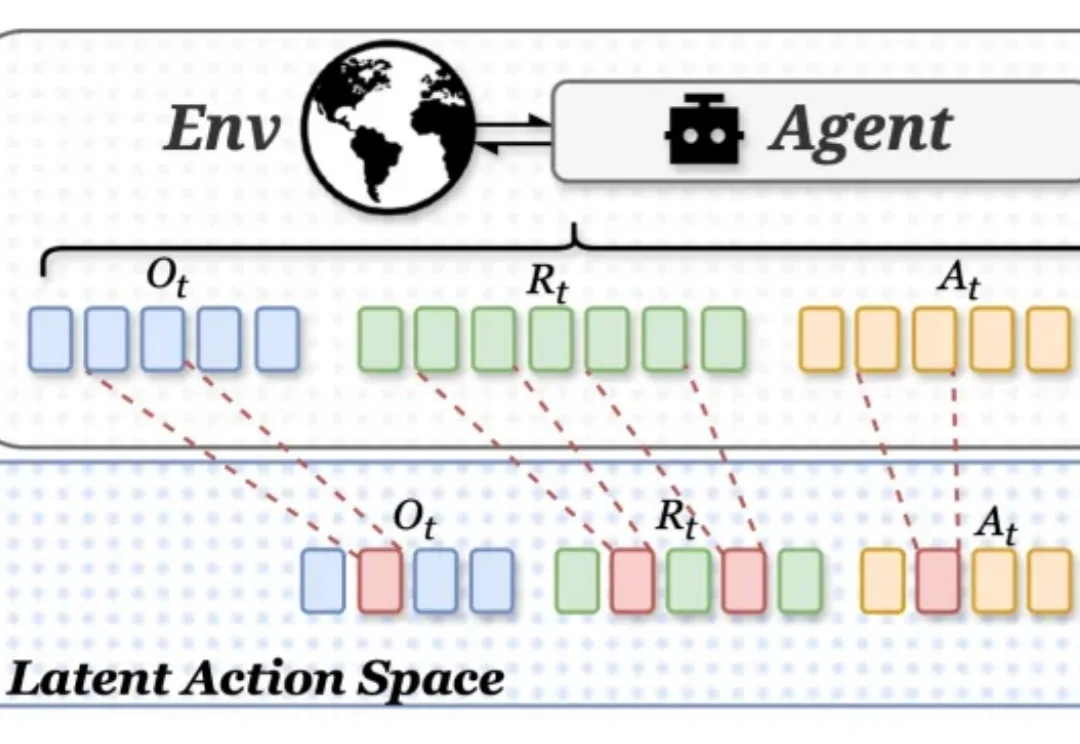
大模型Agent正在从简单问答,快速走向搜索、代码生成、网页操作和多轮工具调用。
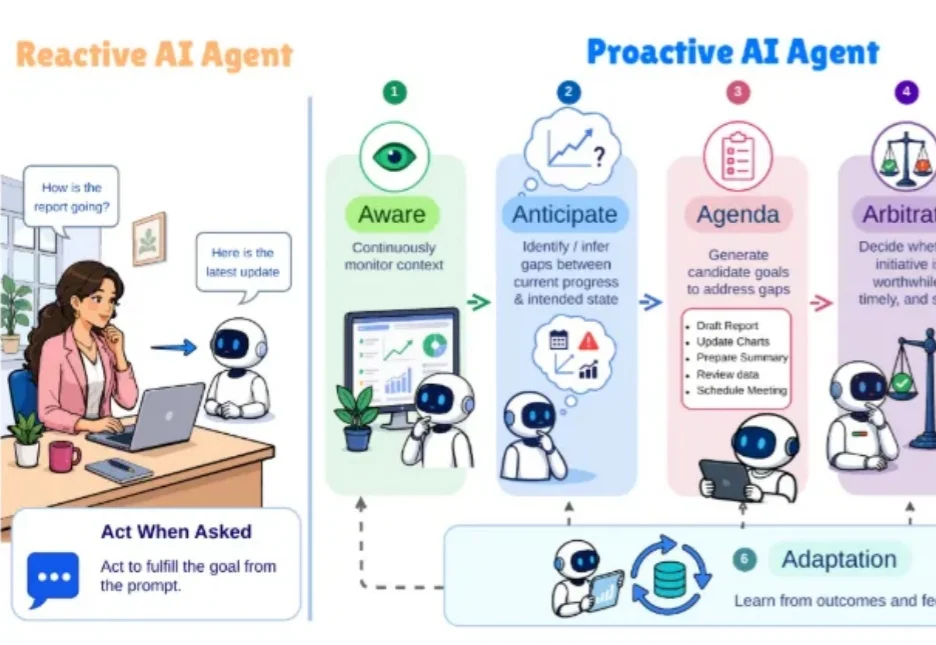
早在 1995 年,Michael Wooldridge 等学者便在智能体研究的代表性论文《Intelligent Agents: Theory and Practice》中,提出了智能体的四项核心特征:反应性(Reactivity)、社会能力(Social Ability)、自主性(Autonomy)和主动性(Proactiveness)。
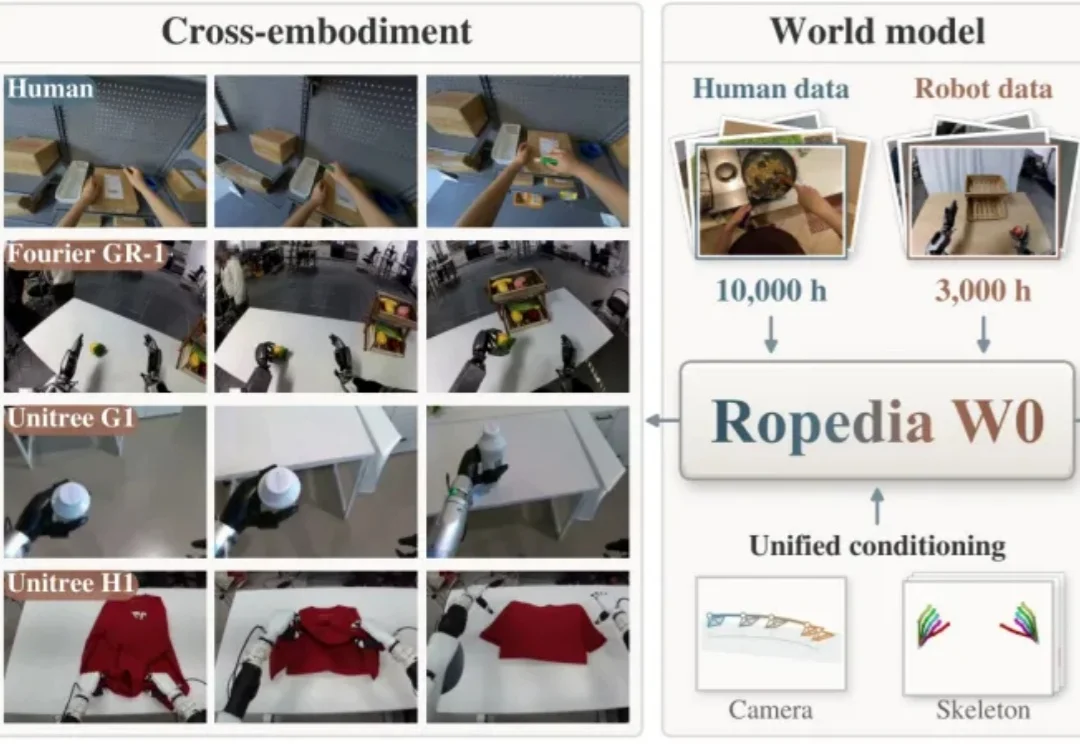
第一视角视频越来越多,研究人员怎样把这些记录变成能够改善机器人能力的训练信息?
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。