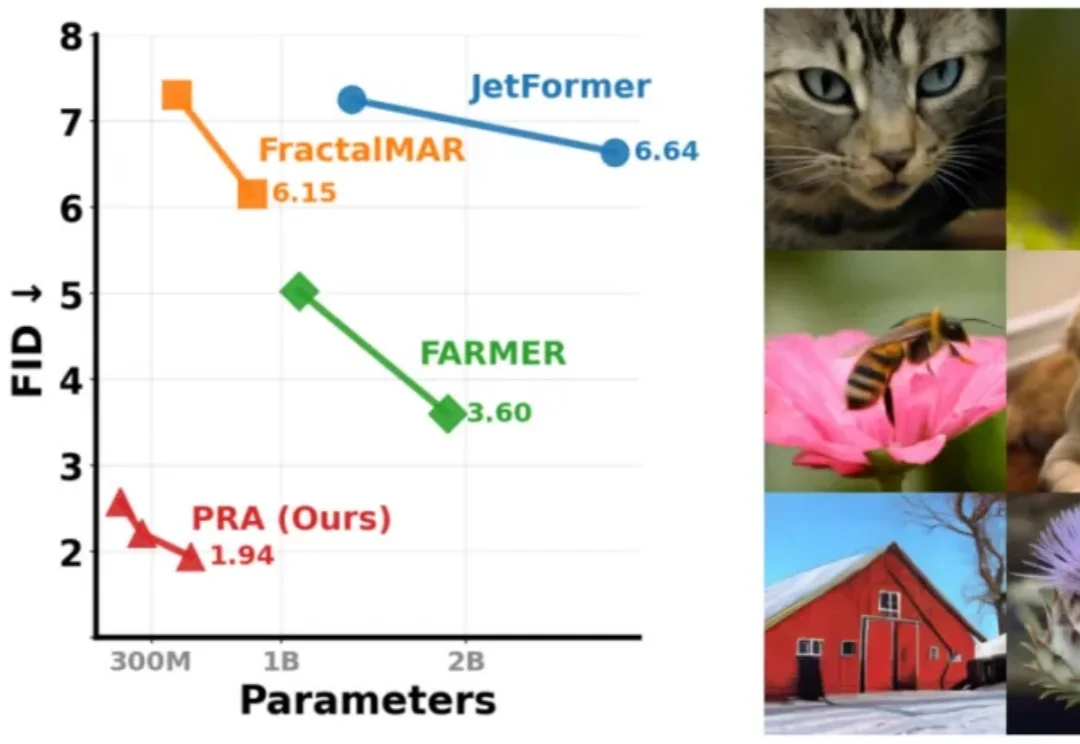
无需视觉 tokenizer,北大PRA解锁自回归图像生成潜力,135M模型性能反超1.9B基线
无需视觉 tokenizer,北大PRA解锁自回归图像生成潜力,135M模型性能反超1.9B基线过去几年,扩散模型几乎定义了高质量图像生成:从随机噪声出发,经过多轮迭代,逐步 “雕刻” 出一张图像。但随着大语言模型席卷人工智能领域,另一条路线正迅速走到舞台中央 —— 图像,能否也像语言一样,通过自回归方式逐步生成?
搜索
过去几年,扩散模型几乎定义了高质量图像生成:从随机噪声出发,经过多轮迭代,逐步 “雕刻” 出一张图像。但随着大语言模型席卷人工智能领域,另一条路线正迅速走到舞台中央 —— 图像,能否也像语言一样,通过自回归方式逐步生成?
7月13日,阶跃星辰在上海正式发布面向智能体时代的大模型原生AI终端品牌STEPX,并同步推出全球首个智能体原生操作系统Step AOS(Step Agentic-native OS)和阶跃新一代个人智能体阶跃Amoo,正式打通了从基座模型、智能体系统到硬件终端的完整链路。
2026年,视频生成赛道正在经历一场从“离线生成”到“实时交互”的范式转移。7月3日全球数字经济大会上——生数科技创始人朱军正式发布Vidu S1实时交互模型,让AI从“视频生成”正式迈入“实时交互”的新阶段。
AI基础设施的核心任务,已经从支撑大模型推理,转向支撑海量智能体的规模化运行与高质量Token的持续生产。
就在今天,阶跃星辰在发布会上一口气抛出三样东西——全球首个大模型原生AI终端品牌STEPX;全球首个智能体原生操作系统Step AOS;全球首款大模型原生智能体手机STEPX Neo。
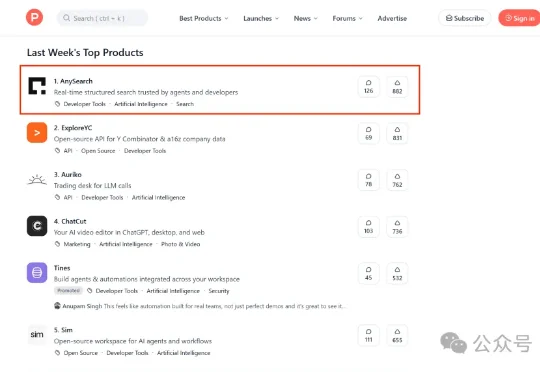
本期Product Hunt周榜Top 1出自中国团队,AnySearch——一款AI搜索产品。过去一年,PH榜一的位置被Agent、AI IDE、大模型轮番占据,几乎没见过搜索类产品的影子。就是因为在全球开发者眼里,普通AI搜索已经很难突围了。
这家名为 PrismML 的初创公司表示,已将 Qwen 3.6 缩减至可在 iPhone 17 Pro 上运行,该模型拥有 270 亿参数(参数大致类似于大脑中的突触,能够帮助决定模型可处理数据的复杂性)。相比之下,大多数在手机上运行的模型一次仅有几十亿个参数处于活动状态。
不教AI认手,而是从视频世界模型里直接「读」出双手:三大基准SOTA,让百万小时野生视频第一次能变成机器人的操作教材。
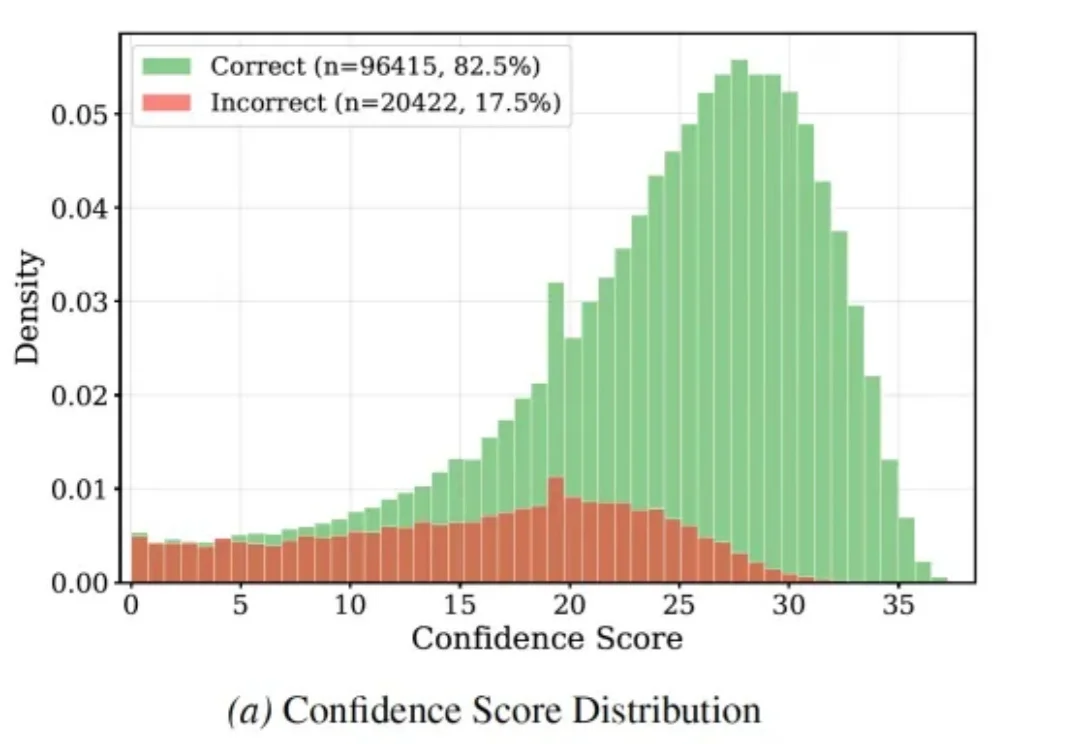
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
近期,围绕「世界模型」的讨论持续升温。机器人、自动驾驶、视频生成、具身智能等多个方向都在频繁使用这一概念,相关系统不断出现,演示形式日益丰富,评价指标也越来越多。伴随这一趋势,一个基础问题变得格外重要:当一个模型被称为「世界模型」时,人们究竟在评价什么?