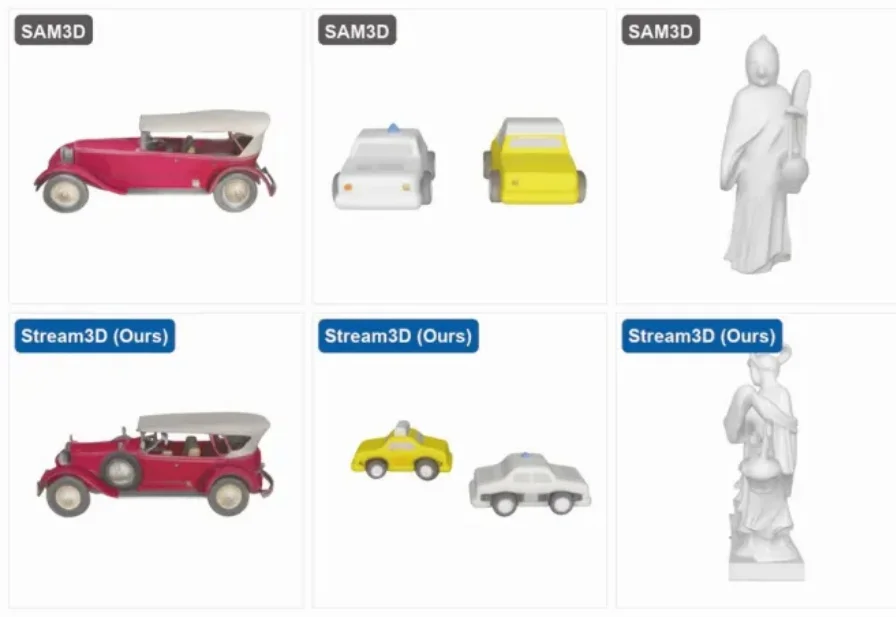
从「看见」到「补全」:哈佛、MIT与港科大Stream3D打通流式3D重建与生成
从「看见」到「补全」:哈佛、MIT与港科大Stream3D打通流式3D重建与生成如何从一段视频中获得完整、稳定的 3D 物体?过去,这个问题大致沿着两条路线发展。
来自主题: AI技术研报
6368 点击 2026-08-03 15:32

 搜索
如何从一段视频中获得完整、稳定的 3D 物体?过去,这个问题大致沿着两条路线发展。
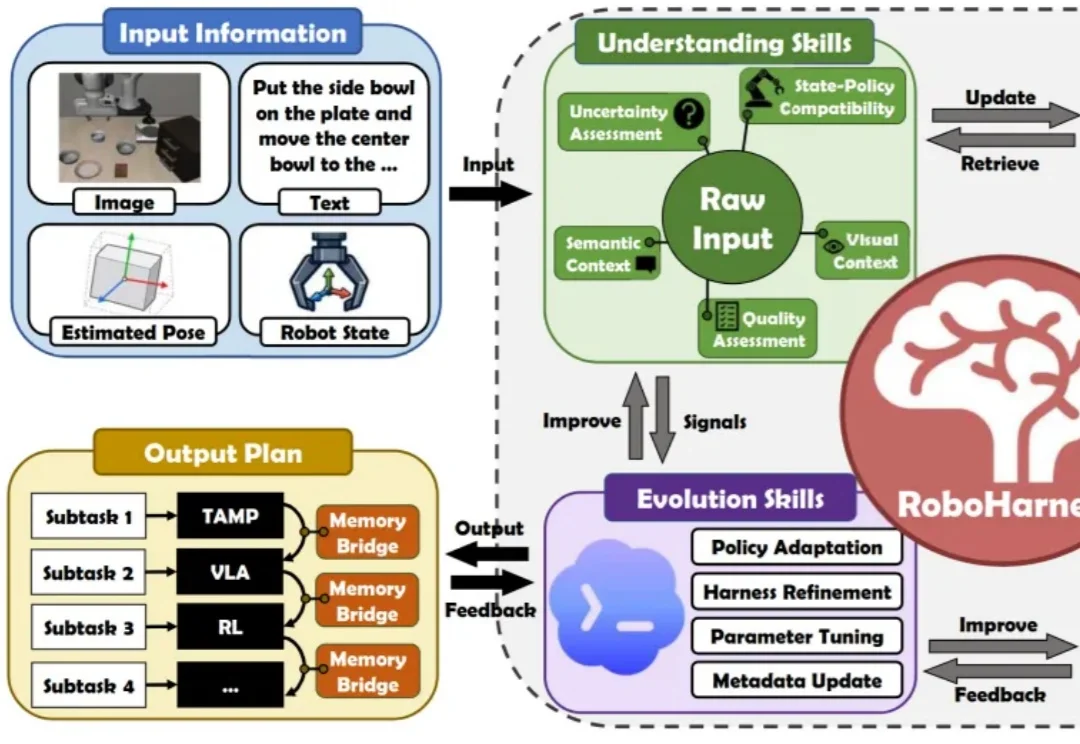
当 VLA、WAM、RL、TAMP、MPC 等机器人控制策略在各自擅长的任务中大放异彩,如何刻画其能力边界,并在正确的时机为不同子任务匹配最合适的策略,正逐渐成为机器人完成复杂长时序任务的关键。
OpenAI内部最新推理模型,一口气发布了十项惊人的数学进展。
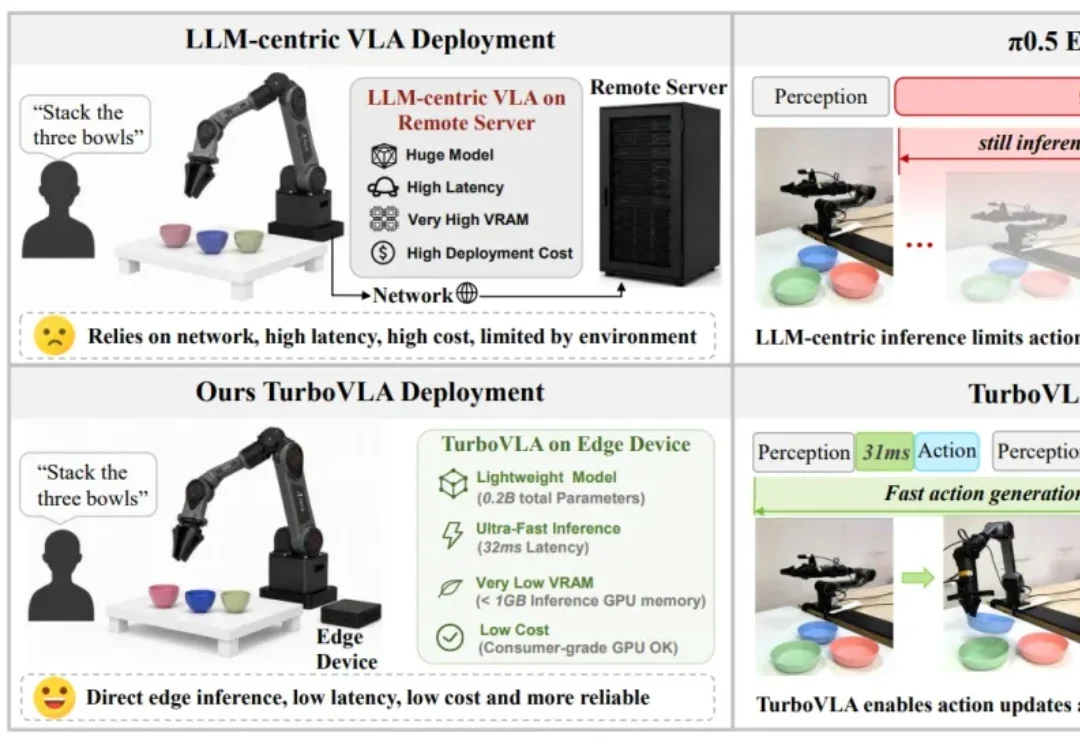
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
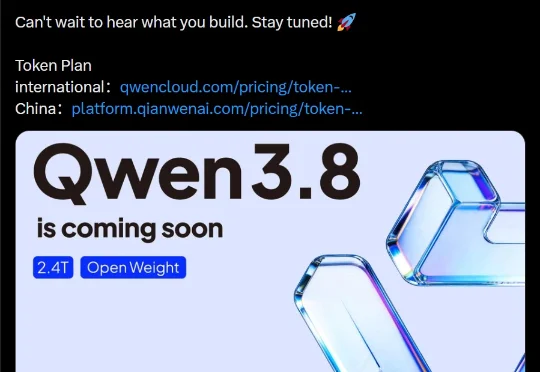
8 月 3 日,阿里巴巴正式发布新一代基座大模型 Qwen3.8,总参数量 2.4 万亿,在编程(Coding)和专业办公(Cowork)方面能力大幅提升。今日放榜的权威三方榜单 Arena 中,阿里 Qwen 模型仅次于 Anthropic 的 Claude 系列,整体性能处于全球大模型第一梯队。。
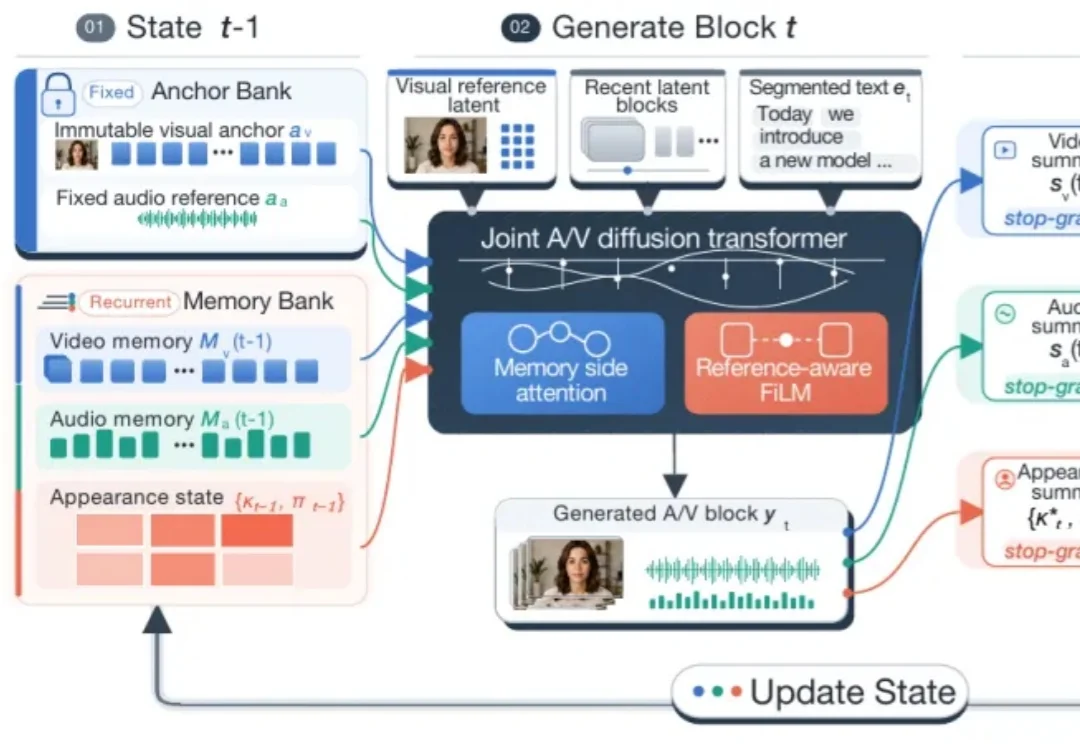
当数字人视频从数秒扩展到数分钟,生成系统面对的核心问题不再只是单帧质量,而是递归生成中的误差累积。
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……
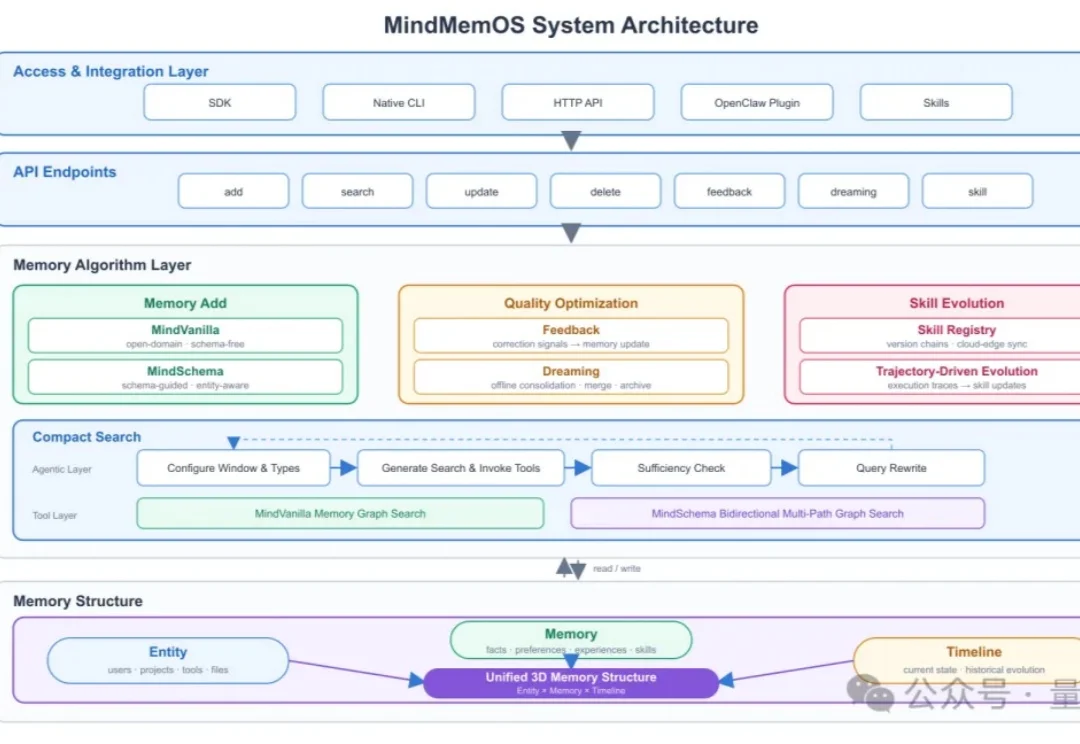
Agent的能力越来越强,但使用体验仍有一个尴尬之处: 每换一个Agent甚至换一个session,就像换了一个完全不了解你的新员工。
一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。
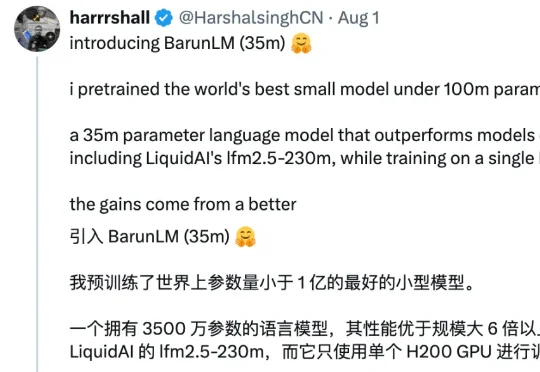
近日,独立开发者 Harshal Singh 公布了一个仅有 3500 万参数的基础语言模型 BarunLM,并声称:「我预训练了世界上参数量小于 100M 的最好模型」。