
至知研究院提出大模型可解释性新路线:直接拆权重,数据成本不到1%
至知研究院提出大模型可解释性新路线:直接拆权重,数据成本不到1%大模型机制可解释性研究中,一直存在一个颇具反差的现实: 为了理解一个已经训练好的模型,研究者往往需要先训练一套新的稀疏表示。
来自主题: AI技术研报
6582 点击 2026-08-19 14:39

 搜索
大模型机制可解释性研究中,一直存在一个颇具反差的现实: 为了理解一个已经训练好的模型,研究者往往需要先训练一套新的稀疏表示。
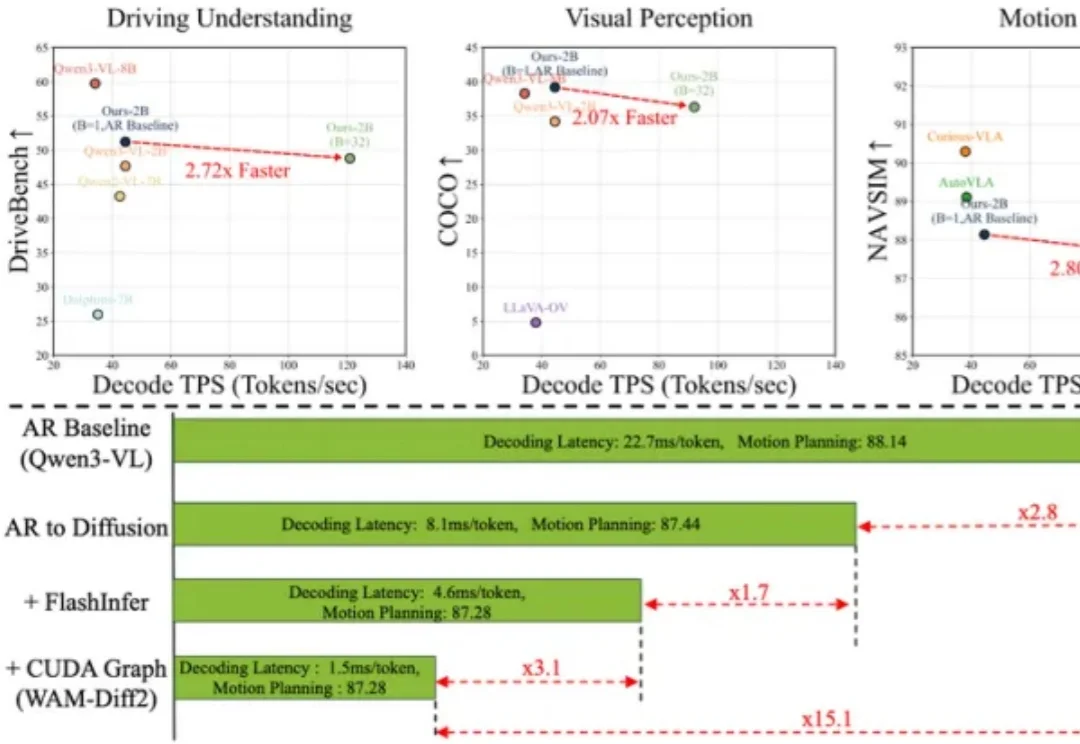
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

图像生成模型正从「会创作」转向「可操作」。

当下,几乎所有人都在押注更大、更聪明的 AI 模型。但 AI 的下一个核心护城河到底是什么?最近,a16z 发布了一篇深度文章——《下一个 AI 护城河并非更优的模型》(The Next AI Moat Isn’t a Better Model)。

史无前例,OpenAI真的停手了!刚刚,奥特曼亲自官宣,「OpenAI暂停下一代旗舰模型的强化学习训练,为期两周」。官方给出停更的原因是:要确保安全、对齐和监控标准,能跟得上眼前这个全新的能力水平。

不太妙。

大模型的版本告一段落,AI应用的新版本已经到来。

最近,第三方视觉评测机构Roboflow,把GPT-5.6 「全家桶」拖进自家VLM基准跑了一圈。测试的内容,都是最实在的活儿:找东西、数东西、认字、抽信息。仅在目标检测这项,上一代GPT-5.5只拿到13.8分。这个分数,在视觉模型圈里基本等于交白卷。

新智元报道 据传,下一代GPT-6本周就要来了! 这不刚在昨天,OpenAI「义父」Tibo亲自爆料,Codex将接入最强Astra模型。 消息一出,全网瞬间沸腾,人们期待值直接拉满。就连Polymarket上,关于OpenAI本周发布下一代Astra的概率,飙涨到了52%。

「套壳」是 Cherry Studio 最大的标签。但这个「壳」,在过去一年成了 GitHub 上增长最快的 AI 桌面应用之一。Cherry Studio 最初的目标很明确,就是帮用户在不同大模型之间自由切换,做一个更好用的聊天客户端。