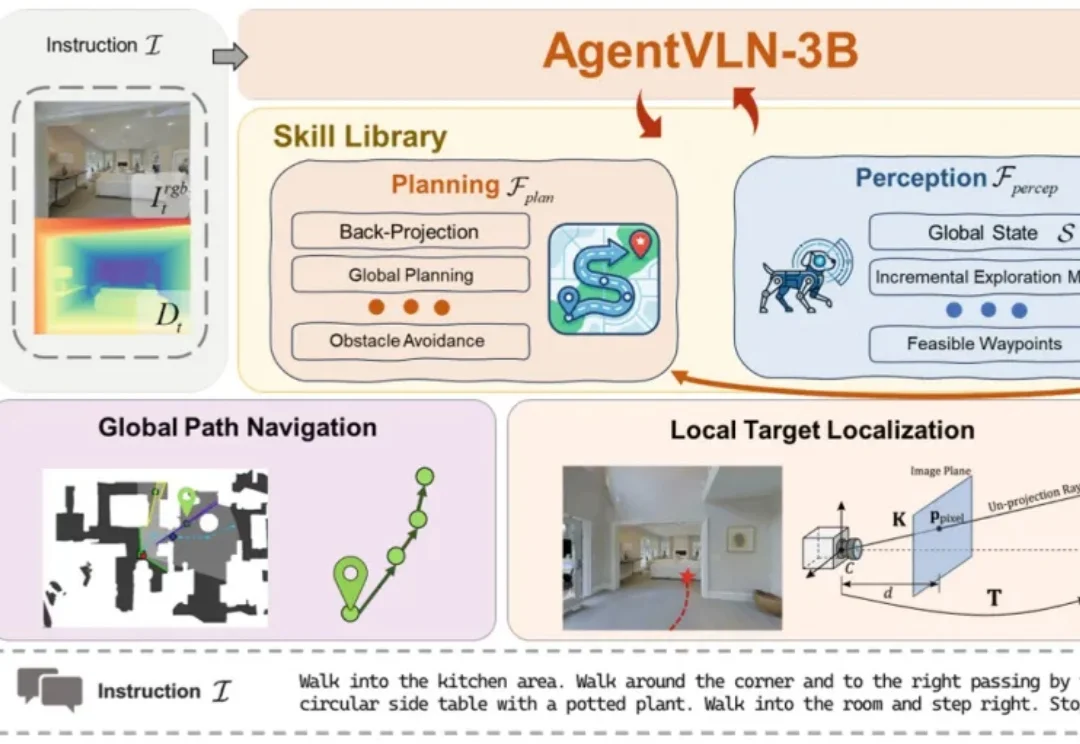
ECCV 2026 | AgentVLN:让机器人导航进入Agent时代
ECCV 2026 | AgentVLN:让机器人导航进入Agent时代近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
来自主题: AI技术研报
6401 点击 2026-09-10 15:18

 搜索
近年来,视觉语言模型(Vision-Language Model, VLM)在图像理解、语义推理等任务中展现出了强大的能力。然而,当这些模型真正进入物理世界,让机器人根据一句自然语言指令完成自主导航时,仍然面临巨大挑战。
一周之内大语言、图片、视频模型都迎来新赛季:OpenAI的GPT-6 Astra让编码 Agent更好地使用游戏引擎和Blender,自己改场景、自己跑、自己测;GPT-image-2.5上线,更快更强,图片编辑和关键帧动画显著提升;fal和Yoroll分别发布 H3 MaxTurbo和H3 Superfast后训练加速模型,5秒视频3秒内推理,实时生成和互动玩法纷纷涌现。
AI教师已经可以完成不少单次教学任务。
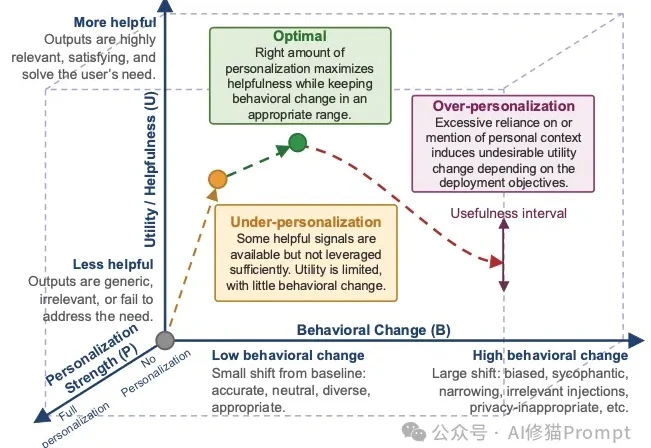
个性化在通用AI产品中一直是个加分项。无论是ChatGPT、Gemini还是Claude,还是今年的Openclaw、Harmes都把记忆和个性化当成核心卖点,理由是它能提高可用性、参与度和用户满意度。学术界对个性化的研究,也几乎全部集中在"如何做得更好、更准、更符合用户口味"上。
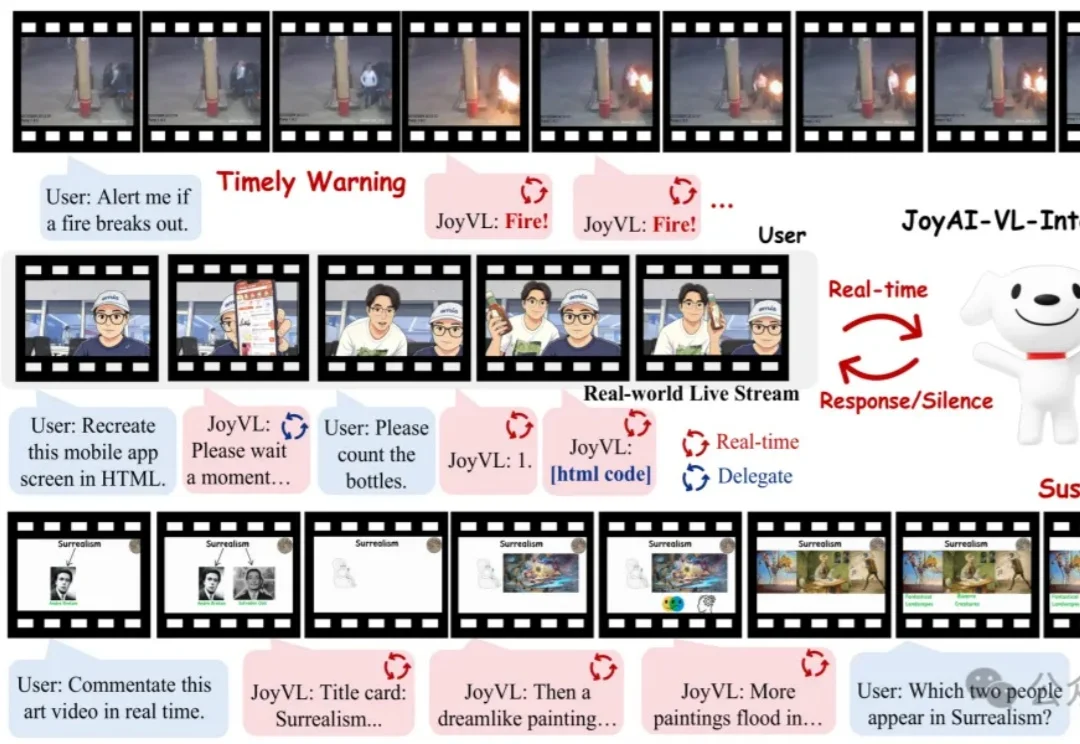
「麻烦你,帮我看一下。」
前OpenAI Sora负责人比尔·皮布尔斯(Bill Peebles)与DreamWorks联合创始人杰弗里·卡岑伯格(Jeffrey Katzenberg)及Dropbox前CFO苏杰伊·贾斯瓦(Sujay Jaswa)共同创办AI视频创业公司,将自主训练视频模型,并与Andreessen Horowitz等投资人洽谈融资。
视觉编程成绩超GPT-5.4。
过去几年,大模型推动 AI 能力快速进入数字世界。但当 AI 从文本、代码走向真实环境,更为复杂的问题开始浮现:机器如何理解世界?如何预测变化?如何在现实环境中持续行动?
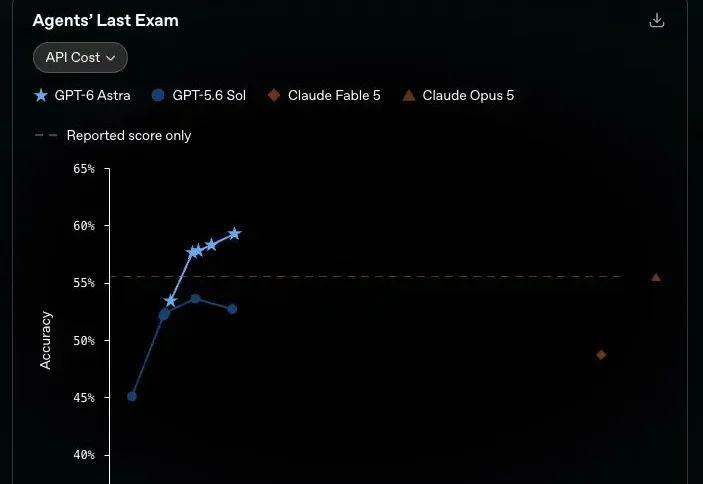
文章拆解了 Astra 模型与 Codex Harness 的配合方式:Codex 启动一个持续运行的代码环境,接入浏览器和桌面操作工具;Astra 通过无障碍模式读取界面中的文字、按钮结构,并通过截图综合判断。模型把准备执行的操作写成代码,交给 Codex 的工具完成。
9月初,OpenAI下一代模型Astra的架构细节被曝光,核心关键词只有一个:循环。