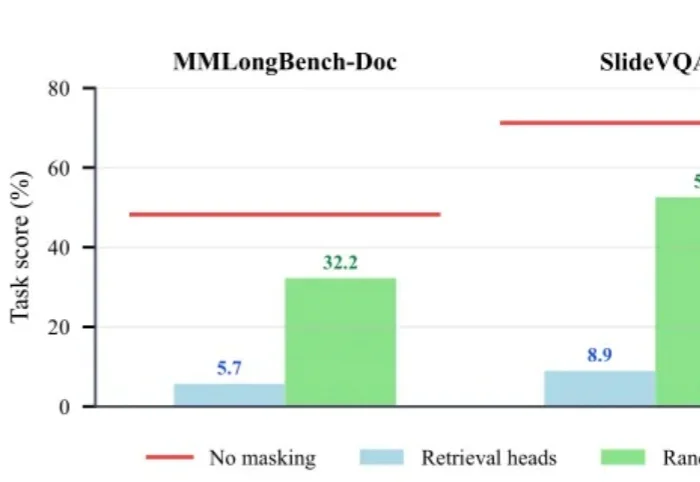
多模态检索头首次被锁定:揭开大模型长文档内部检索真相 | EMNLP'26
多模态检索头首次被锁定:揭开大模型长文档内部检索真相 | EMNLP'26随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
来自主题: AI技术研报
10280 点击 2026-09-08 15:05

 搜索
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
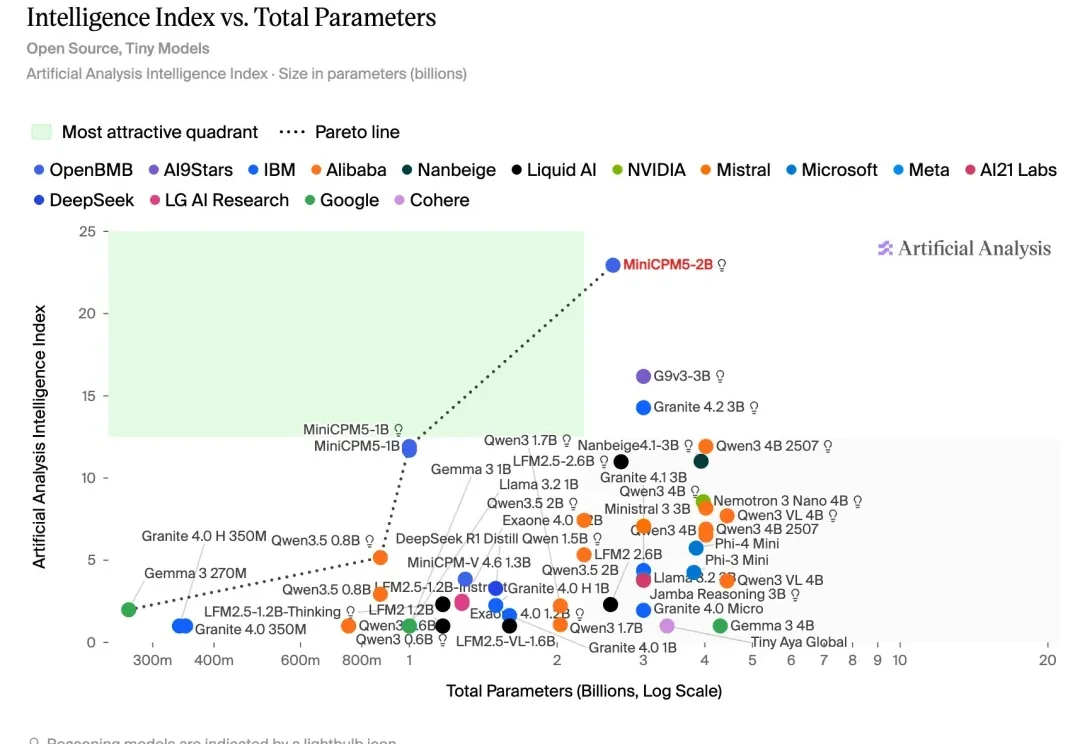
过去几年,端侧大模型一直在不断突破能力边界。
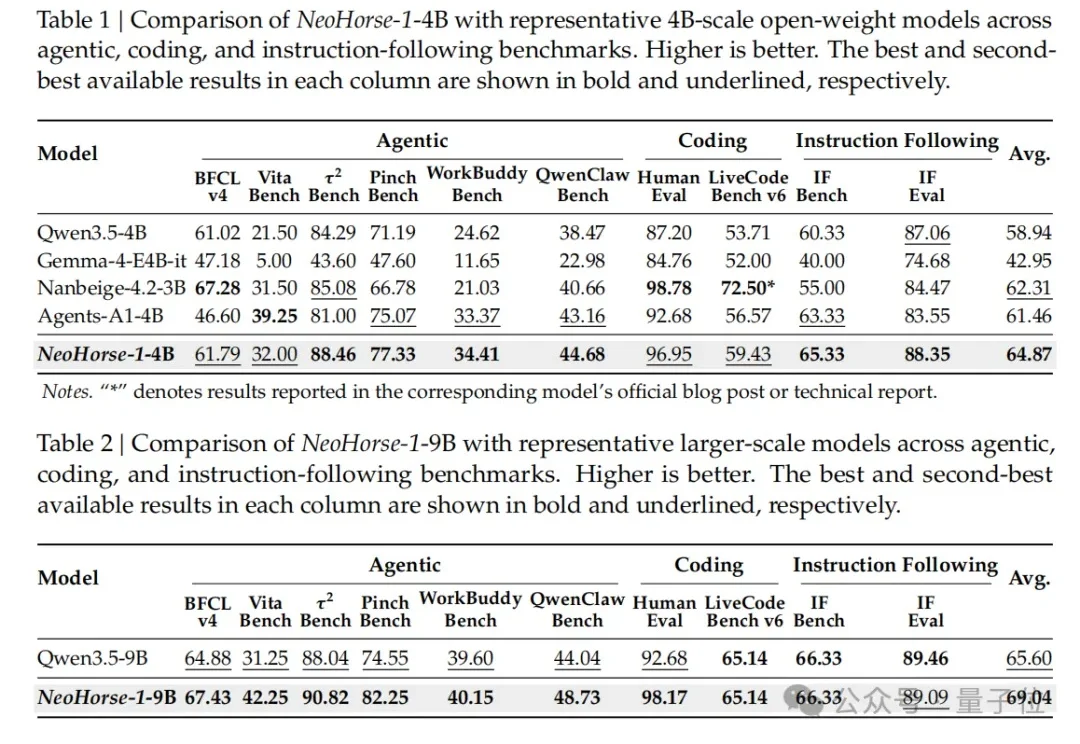
王云鹤创业后,首次交卷了大模型成果。
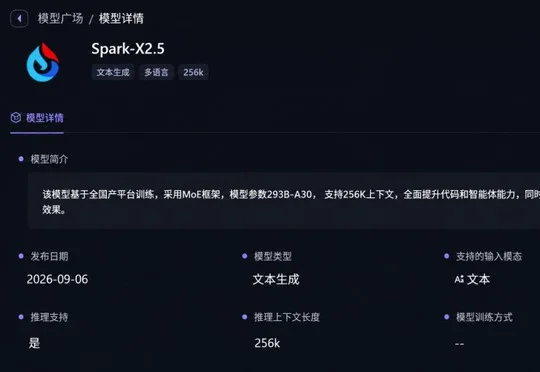
科大讯飞基于全国产算力发布2930亿参数的星火X2.5大模型,在代码、智能体、数学及理解等能力上有所提升,智东西通过游戏开发、3D创作、网页前端、数学推理和小说写作五项任务对其展开实测。
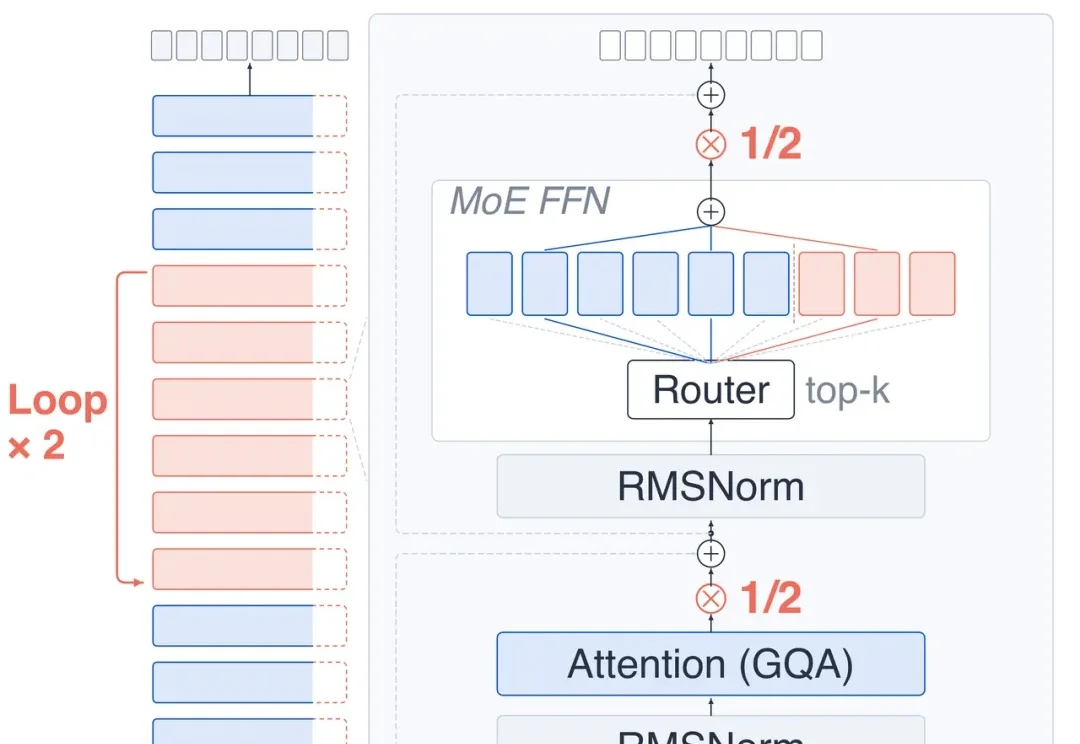
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
OpenAI被曝正在内部测试GPT-6 Sol,单次速度约为GPT-6 Astra的6倍,同时公开内部数据称研究员每8小时工作日背后并行运行约3.1个Agent工作日、每日Agent推理资源花费超600美元,并宣布已实现"自动化AI研究实习生"目标;其首席科学家Jakub Pachocki同日发文警告AI对齐与监控难题,表示若必要OpenAI不排除单方面暂停扩大模型规模。
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。
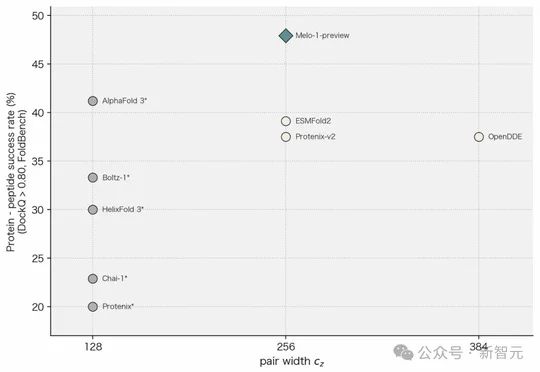
成立仅4个月的中国公司深旋科技(Atomelody)发布全原子生物基础大模型Melo-1 Preview,在蛋白-多肽、蛋白-小分子等公开基准测试中核心指标刷新纪录并超越AlphaFold 3,登顶全球第一梯队。
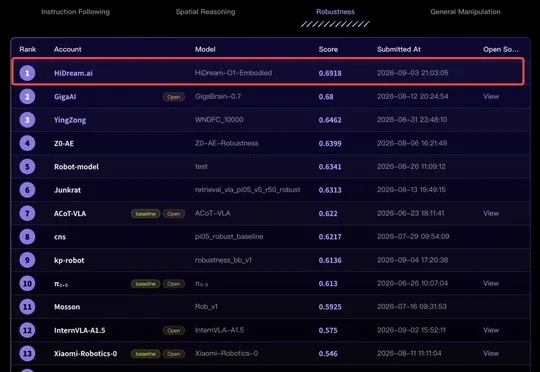
智象未来(HiDream.ai)正式发布具身世界模型HiDream-O1-Embodied,该模型在具身智能评测平台RoboColiseum扰动适应子榜单中以0.692分登顶榜首,标志着智象原生全模态世界模型矩阵的进一步完善。
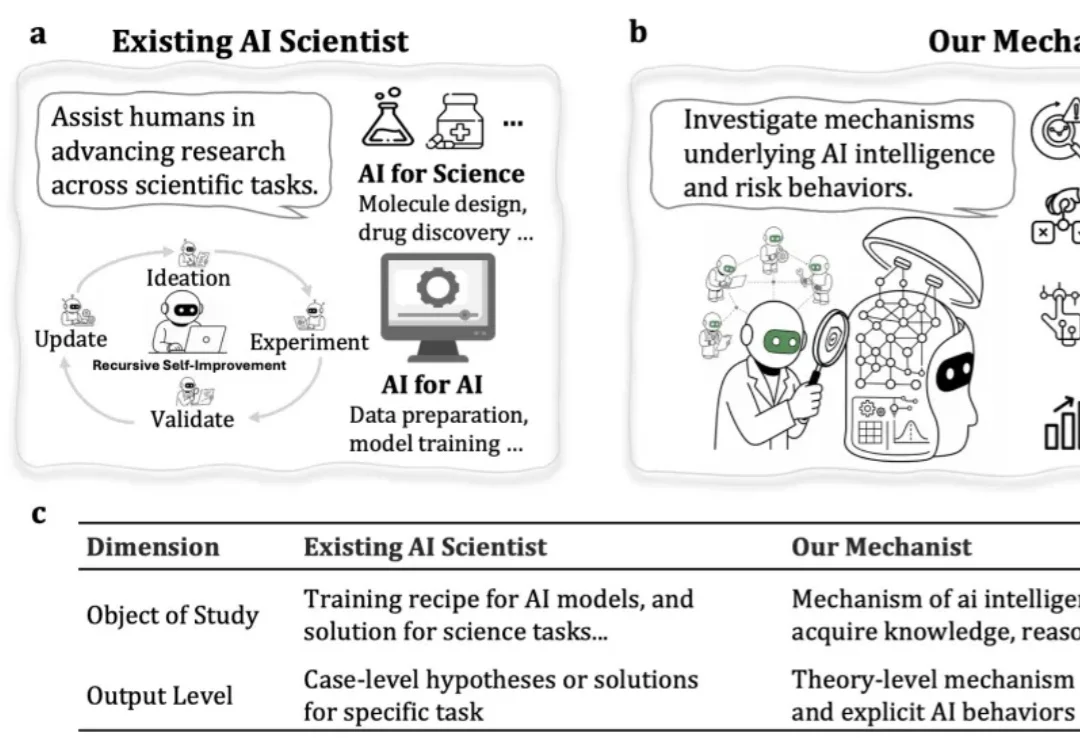
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。