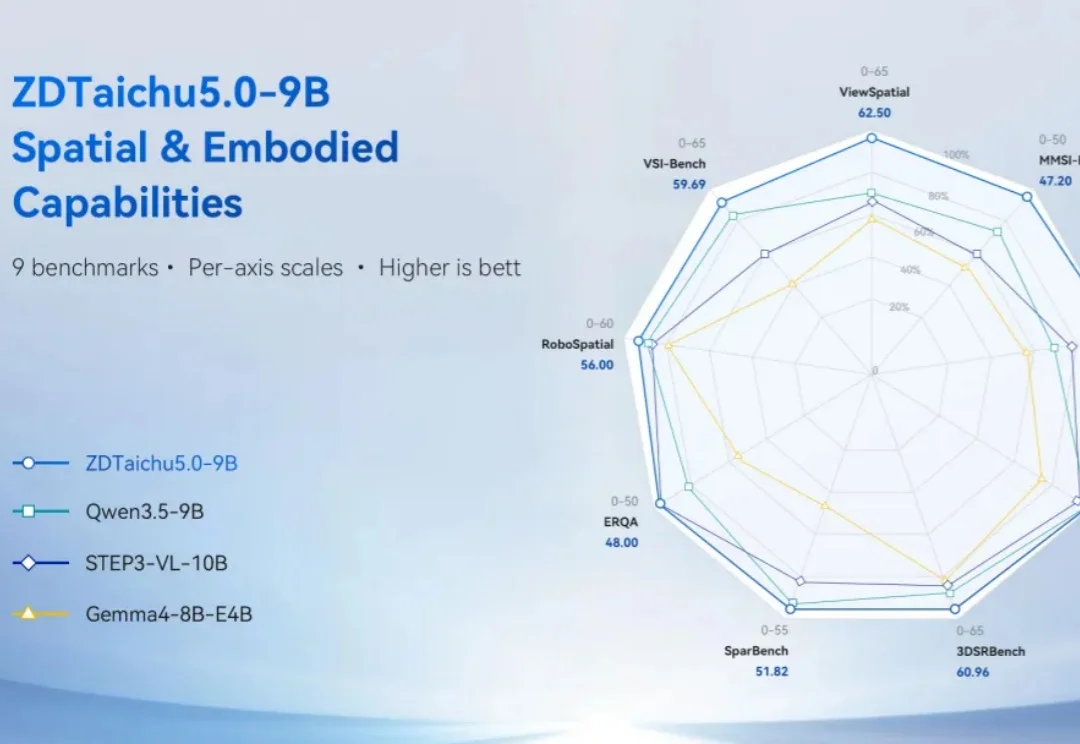
开源模型夯爆了!ZDTaichu5.0-9B,10B以内空间具身智能卷出通用类第一
开源模型夯爆了!ZDTaichu5.0-9B,10B以内空间具身智能卷出通用类第一紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
来自主题: AI技术研报
8905 点击 2026-09-18 10:00

 搜索
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
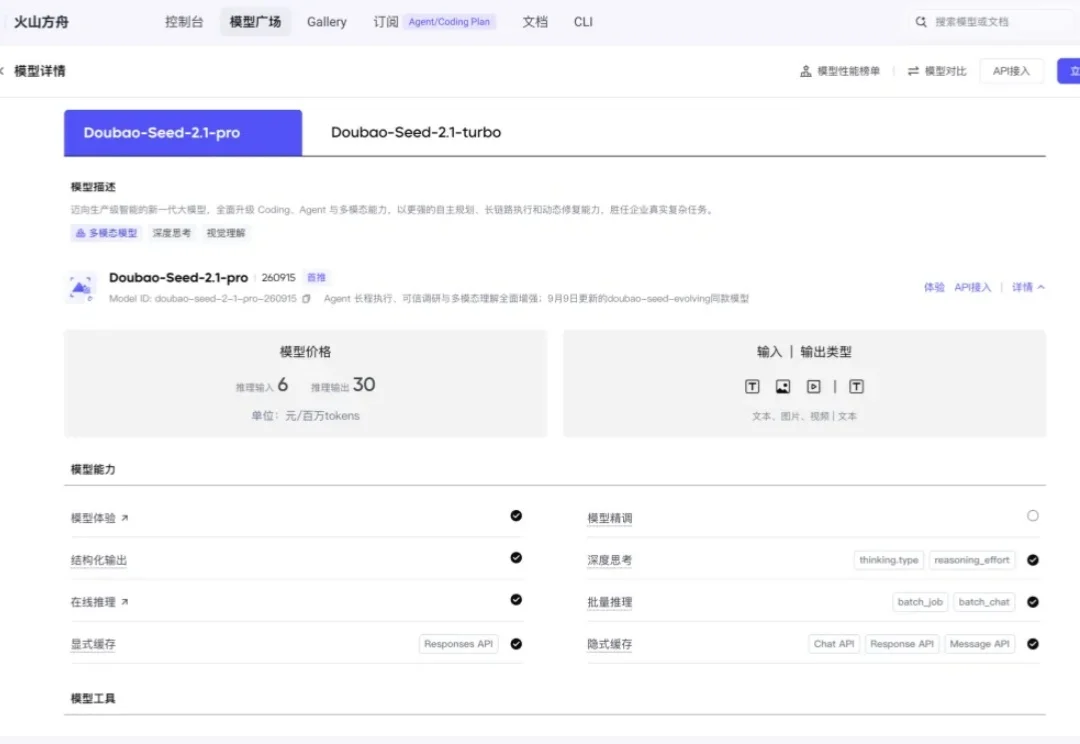
最近Seed-2.1-pro又更新了。
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!
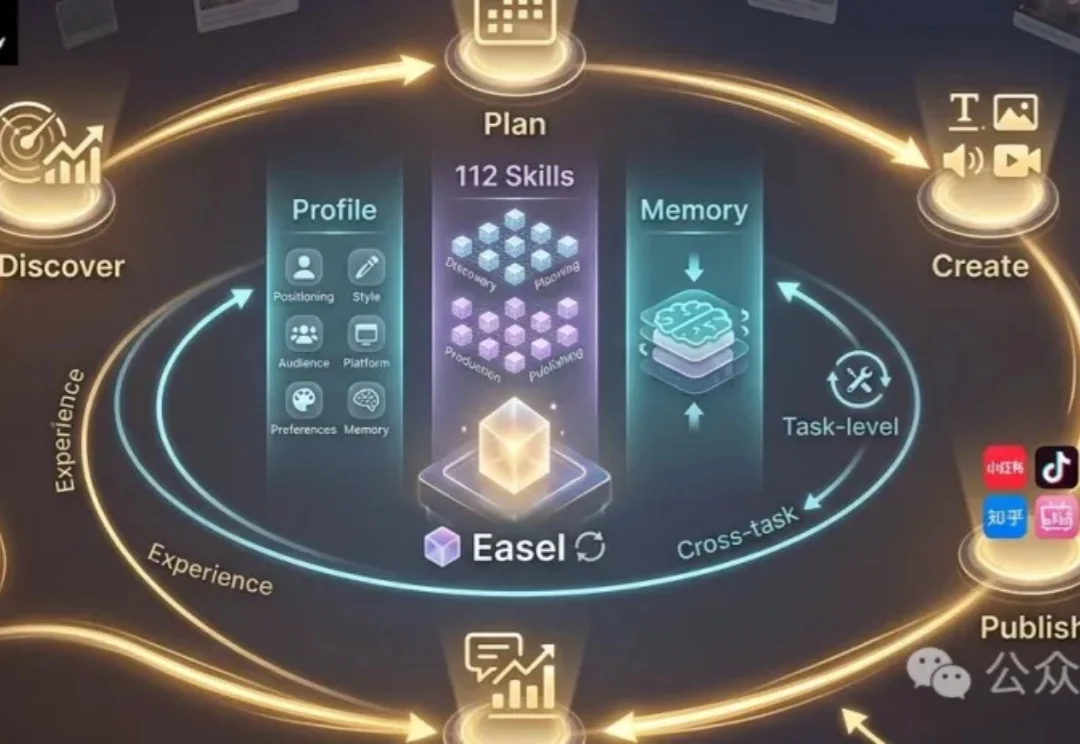
当大模型已经能够快速生成文案、图片和视频,一个更进一步的问题是:Agent 能否从执行过的任务中积累经验,并在持续交互中改进后续行为?
OpenAI计划以3亿美金收购由前苹果工程师创立的AI影像公司Glass Imaging,以补充端侧视觉能力,布局多模态AI硬件。
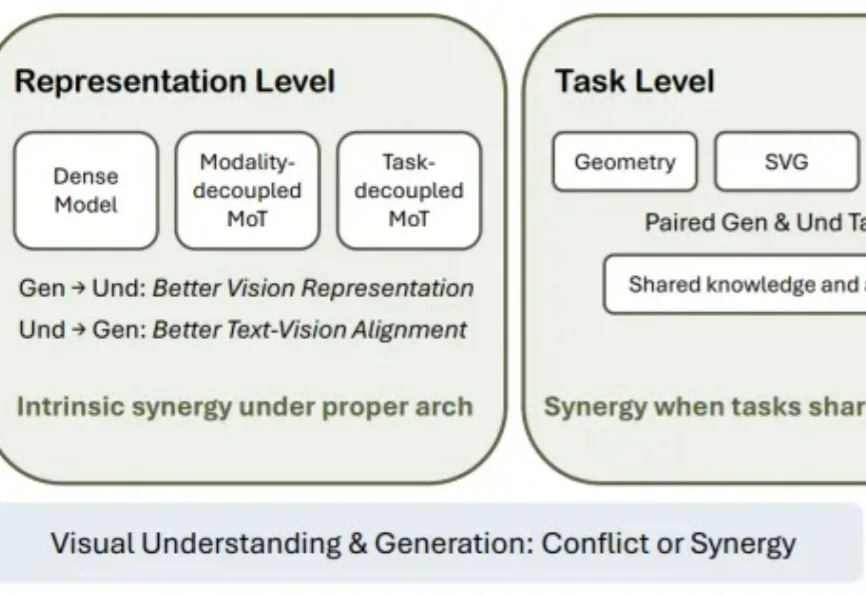
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
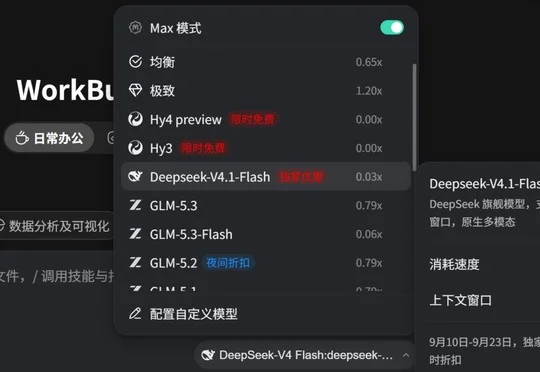
DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
视觉编程成绩超GPT-5.4。
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
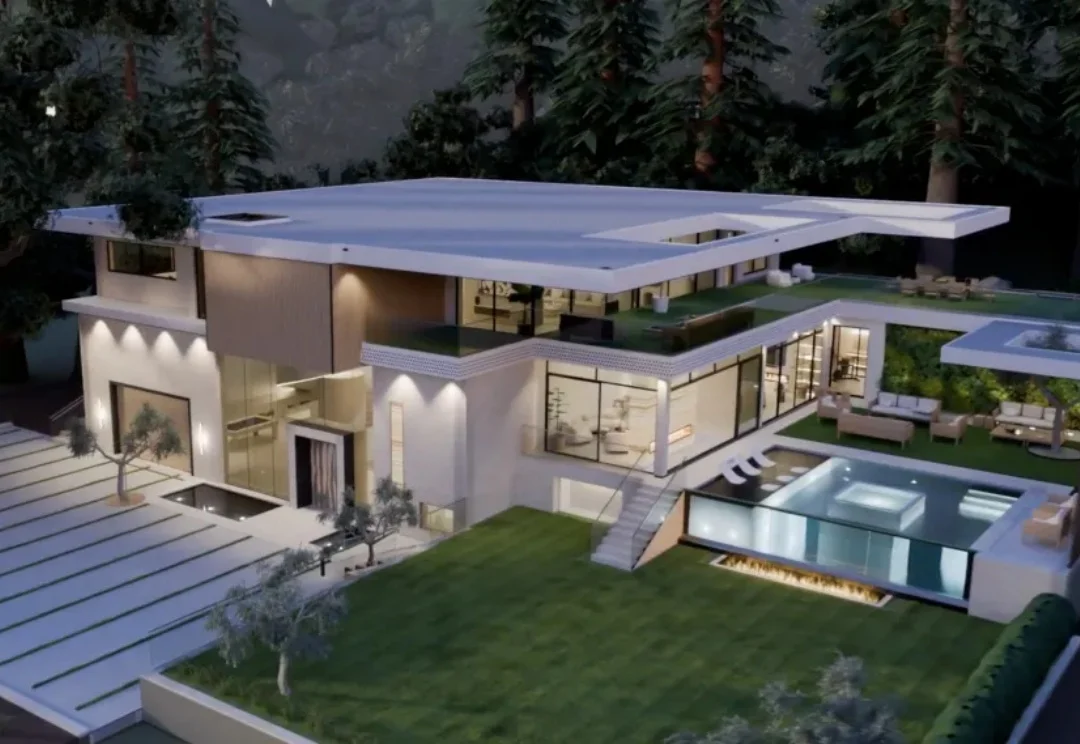
最近,GPT-6 Astra 的三维建模与空间理解 demo 引发关注。它能在 Blender 中搭建带家具和庭院的住宅,再将场景转入 Unreal Engine 5,让人能走进房间、打开柜门,甚至操作咖啡机。