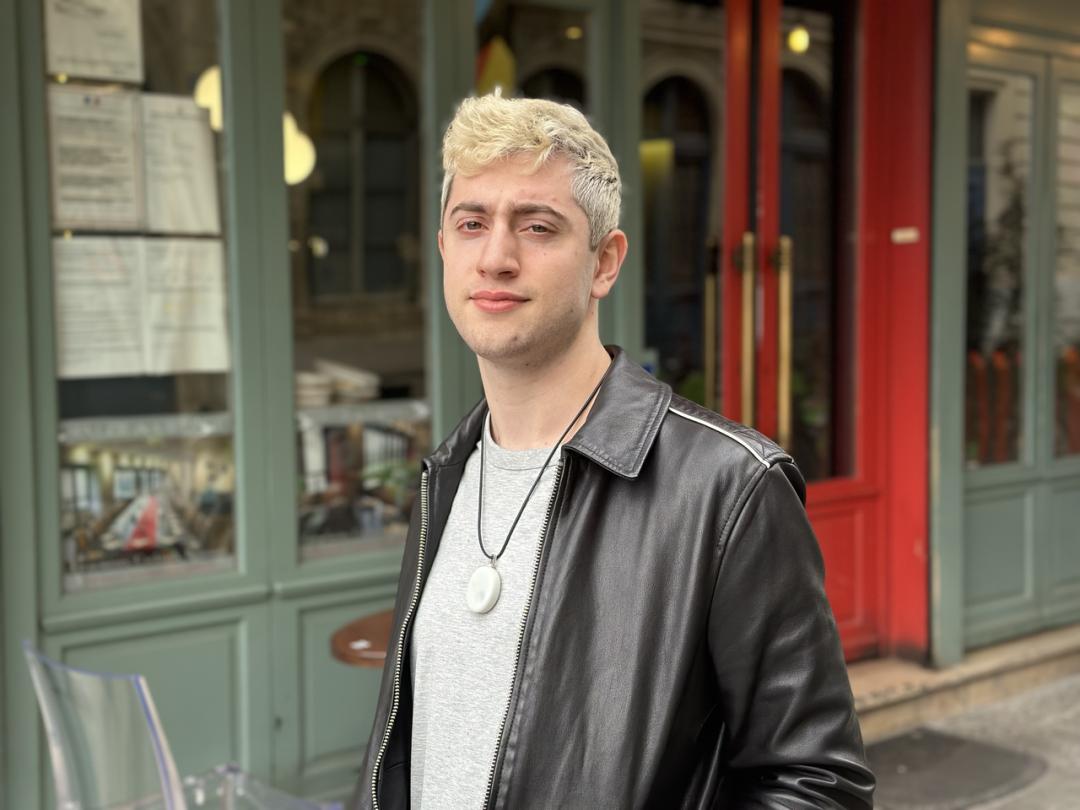
00后哈佛辍学生创业AI吊坠:不要生产力,我们只要AI朋友 | New Things
00后哈佛辍学生创业AI吊坠:不要生产力,我们只要AI朋友 | New Things情感陪伴是人类的永恒需求,也能在AI赛道上玩出花。
来自主题: AI资讯
10091 点击 2024-08-06 12:00

 搜索
情感陪伴是人类的永恒需求,也能在AI赛道上玩出花。
“中美AI差距究竟有几年?”这个问题困扰了不少只要根深蒂固,任尔东西南北风人,也有很多声音尝试将中美AI实力进行比较。其中,算法,一定是评判的首要标准。
从前两年的百模大战到大语言模型 LLM(Large Language Model)的逐步落地应用,端侧AI始终是人工智能技术发展中至关重要的一环。 所谓的端侧AI,即用户在使用过程中不依赖云服务器,直接在终端设备本地使用AI服务。相比于ChatGPT4.0和最新推出的Llama3.1等依赖于云端接口的主流大语言模型,设备端边缘应用的紧凑模型有较强的私密性,也具有个性化操作和节省成本等诸多优势。
Llama 3.1刚发布不久,Llama 4已完全投入训练中。 这几天,小扎在二季度财报会上称,Meta将用Llama 3的十倍计算量,训练下一代多模态Llama 4,预计在2025年发布。
检查内容是否用了ChatGPT,准确率高达99.9%!
英伟达最强芯片B200被迫推迟三个月,传闻闹的沸沸扬扬。
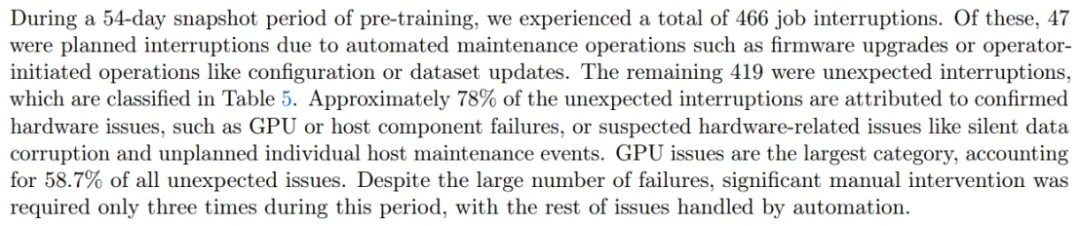
大模型作为当下 AI 工业界和学术界当之无愧的「流量之王」,吸引了大批学者和企业投入资源去研究与训练。随着规模越做越大,系统和工程问题已经成了大模型训练中绕不开的难题。例如在 Llama3.1 54 天的训练里,系统会崩溃 466 次,平均 2.78 小时一次!
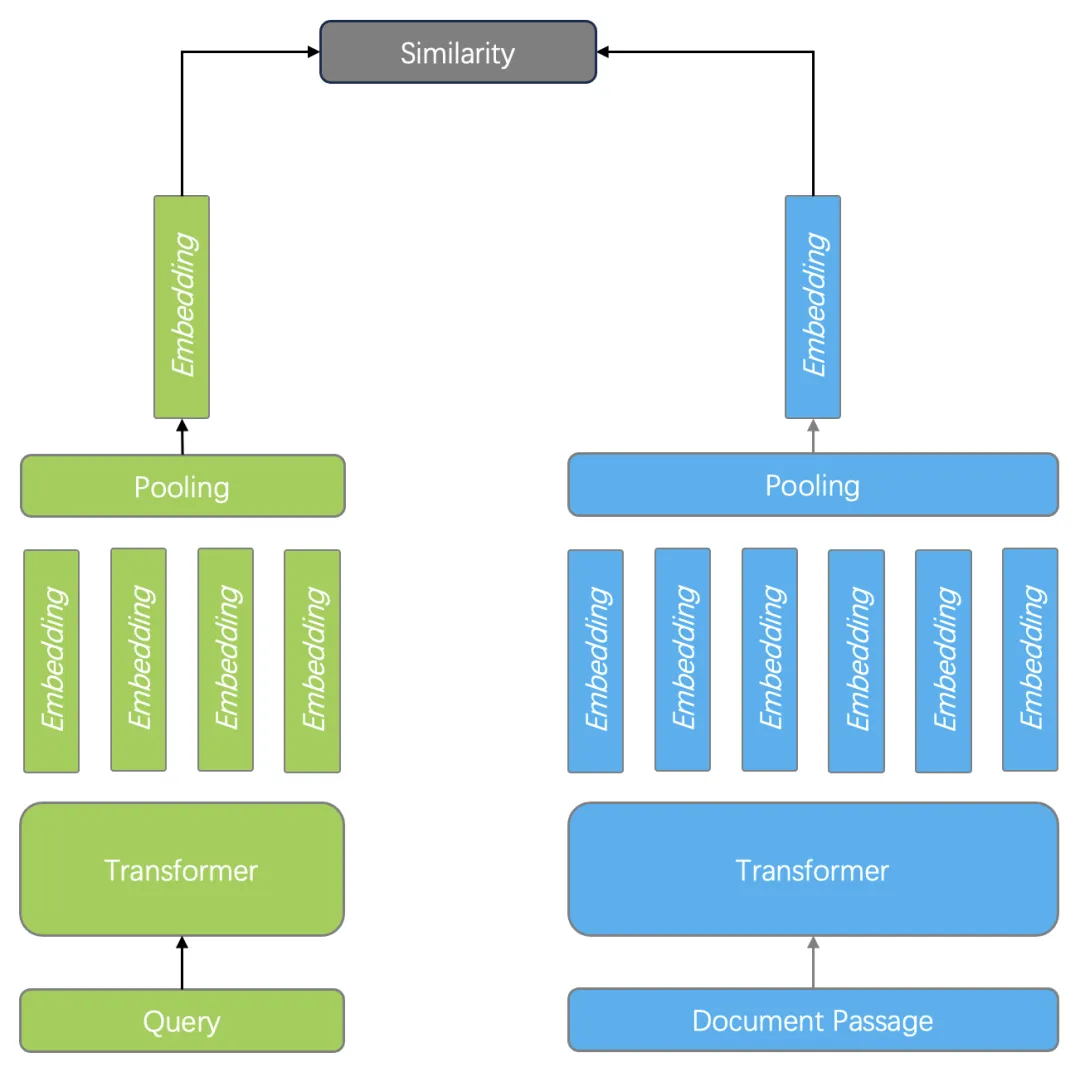
在 RAG 系统开发中,良好的 Reranker 模型处于必不可少的环节,也总是被拿来放到各类评测当中,这是因为以向量搜索为代表的查询,会面临命中率低的问题,因此需要高级的 Reranker 模型来补救,这样就构成了以向量搜索为粗筛,以 Reranker 模型作精排的两阶段排序架构。
如今一场席卷人工智能圈的“石油危机”已经出现,几乎每一家AI厂商都在竭力寻求新的语料来源,但再多的数据似乎也填不满AI大模型的胃口。更何况越来越多的内容平台意识到了手中数据的价值,纷纷开始敝帚自珍。为此,“合成数据”也成为了整个AI行业探索的新方向。
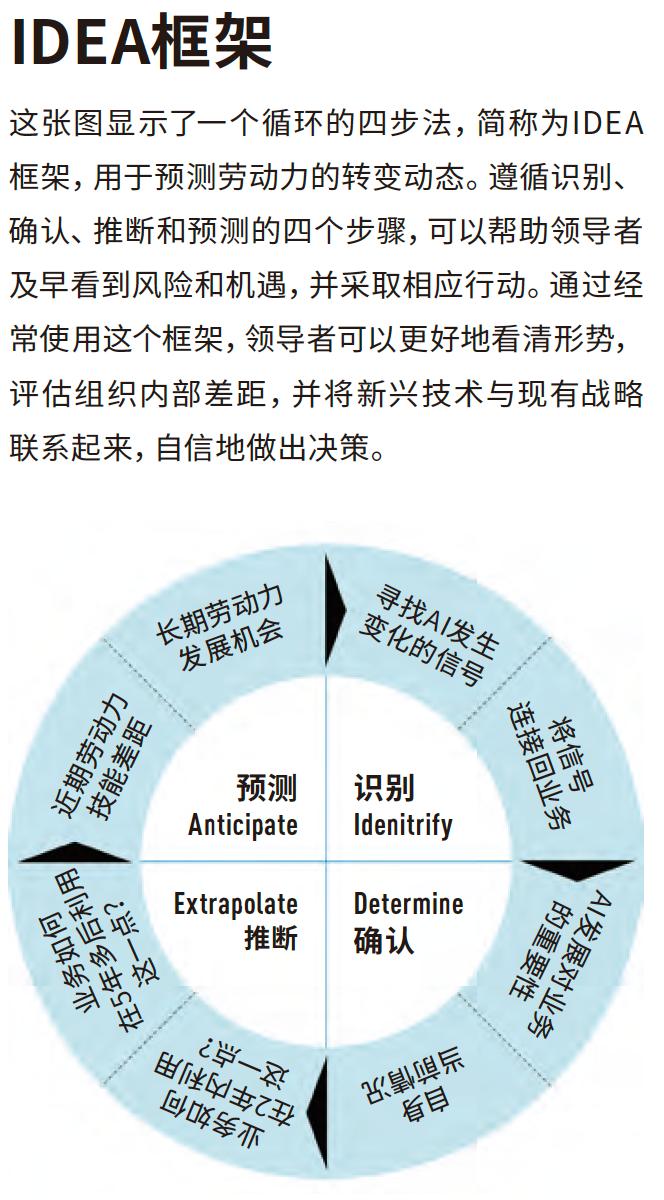
最近,一家知名银行的CEO给我打电话,讨论了生成式AI的前景。我们最初会通过各种场景改善欺诈检测和客户服务,但随着最近一系列新闻的不断发布,很明显他有更大野心。和许多行业一样,银行业也存在劳动力问题:对熟练员工的需求,与愿意回到办公室并遵守疫情前规则的工人供应之间存在着差距。