智谱认领“牛来”:匿名六天,让全球开发者用掉数十万亿Token
智谱认领“牛来”:匿名六天,让全球开发者用掉数十万亿Token8月26日,据彭博社报道,智谱AI确认,近期匿名上线的Ox Alpha由其开发,是GLM系列的新一代模型。Ox意为“牛”,恰逢电影《牛来》走红,因此中文开发者社区把Ox Alpha叫作“牛来大模型”。
来自主题: AI资讯
9678 点击 2026-08-27 09:28

 搜索
8月26日,据彭博社报道,智谱AI确认,近期匿名上线的Ox Alpha由其开发,是GLM系列的新一代模型。Ox意为“牛”,恰逢电影《牛来》走红,因此中文开发者社区把Ox Alpha叫作“牛来大模型”。
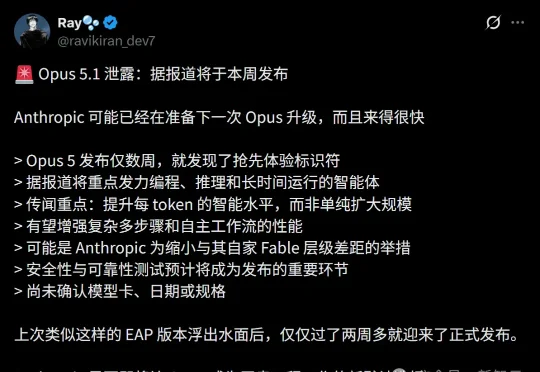
今天,又有消息曝出:全新Opus 5.1模型,据传将在本周突袭发布。 从此,智能体赛道又要大洗牌了。 它有碾压级的编程能力、复杂的逻辑推理和长时间运行的AI Agent能力。单Token的智能水平,将再次被推到极限!
就在刚刚,OpenAI首颗自研芯片Jalapeño「墨西哥辣椒」,交出了首批实测成绩单——AI推理性能,全面反超英伟达GB200和GB300。实测速度直接起飞!Jalapeño一秒能狂吐1459个Token,英伟达GB200只有535个,连一半都不到。
“你以为你买的是 DeepSeek Flash,实际上可能是个 1.5 bit 的 DeepSeek,或者里面掺了 Opus 用于训练。”这是 Pi 核心贡献者 Armin Ronacher 的一个比喻。他形容现在的 token 市场像一种成分不明的商品——量化程度、实际版本、是否掺了别的东西、计费方式,全是黑洞。
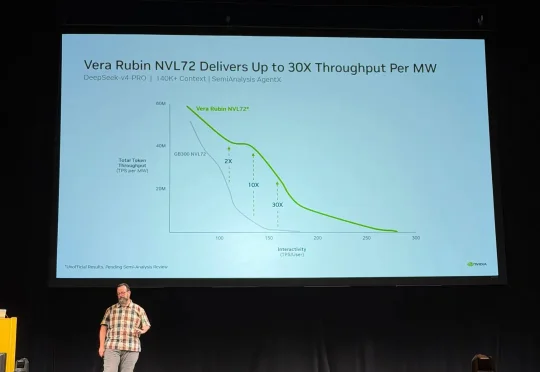
就在刚刚,英伟达史上首次公布了下一代旗舰级机柜 Vera Rubin NVL72 的首次片上实测数据。而且,这次实测直接拉来了DeepSeek-V4-Pro,跑最真实的「智能体编码」任务!结果令人吃惊:对比当前的主力机皇GB300 NVL72,Vera Rubin的每兆瓦吞吐量最高飙升了30倍、Token成本最高暴降了35倍!
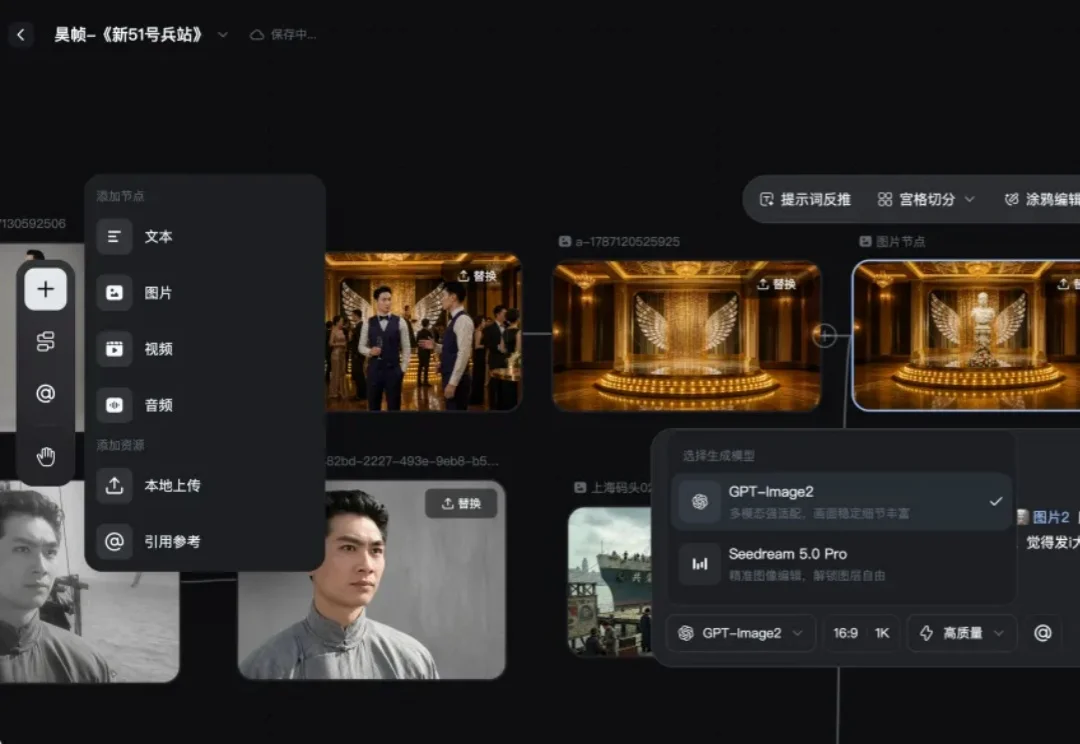
全球 AI 视频创作的注意力,全都被模型厂商以及少数 C 端产品所霸占。
当算力真正成为稀缺资源时,人们会发现,在任何一个机构里,往往只有几十名研究者贡献了大约80%的成果。真正昂贵的不是研究者本人,而是与他配套的算力。因此,如果拥有一定的Token预算,你要把它分配给谁,为什么。
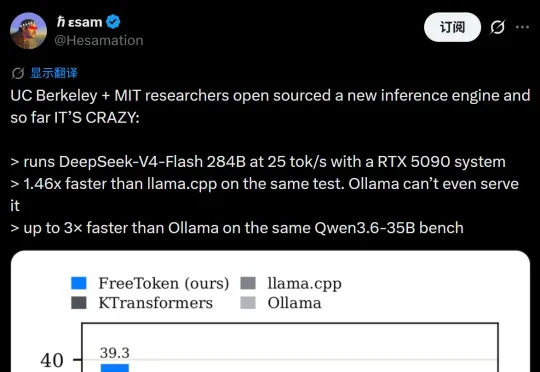
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
这期节目的嘉宾黄东旭,就是Token Maxing热潮的亲历者。他曾经只用最前沿的模型,每天账单三四百美元。让他转变的,是前沿模型的智力碾压和中国开源模型们的崛起——Fable 5可以一句话终结Agent群的讨论,同时大量的日常任务可以做到“只烧电费,不烧Token”。他的结论是:不是前沿模型用不起,而是本地开源模型底座+前沿模型的搭配,成本可控,更具性价比。

8 月 19 日,WRC 2026 期间,由跨维智能主办的「物理 AI 引领者论坛」在北京举行。