杨植麟还没有解开月之暗面的局
杨植麟还没有解开月之暗面的局11月16日,陷入前投资人仲裁风波的主角杨植麟突然出现,并对外发布了一款数学模型。 杨植麟将自己的数学模型k0-math对标OpenAI o1系列,主打深入思考。
来自主题: AI资讯
8532 点击 2024-11-21 14:30

 搜索
11月16日,陷入前投资人仲裁风波的主角杨植麟突然出现,并对外发布了一款数学模型。 杨植麟将自己的数学模型k0-math对标OpenAI o1系列,主打深入思考。
在「全球最难LLM评测榜单」上,国产万亿参数模型杀入全球第五,拿下中国第一!国内明星初创阶跃星辰的这个自研模型太过亮眼,甚至引起了外国网友的热议。
新的大语言模型(LLM)评估基准对于跟上大语言模型的快速发展至关重要。

今天,DeepSeek 全新研发的推理模型 DeepSeek-R1-Lite 预览版正式上线。所有用户均可登录官方网页 (chat.deepseek.com),一键开启与 R1-Lite 预览版模型的超强推理对话体验。DeepSeek R1 系列模型使用强化学习训练,推理过程包含大量反思和验证,思维链长度可达数万字。
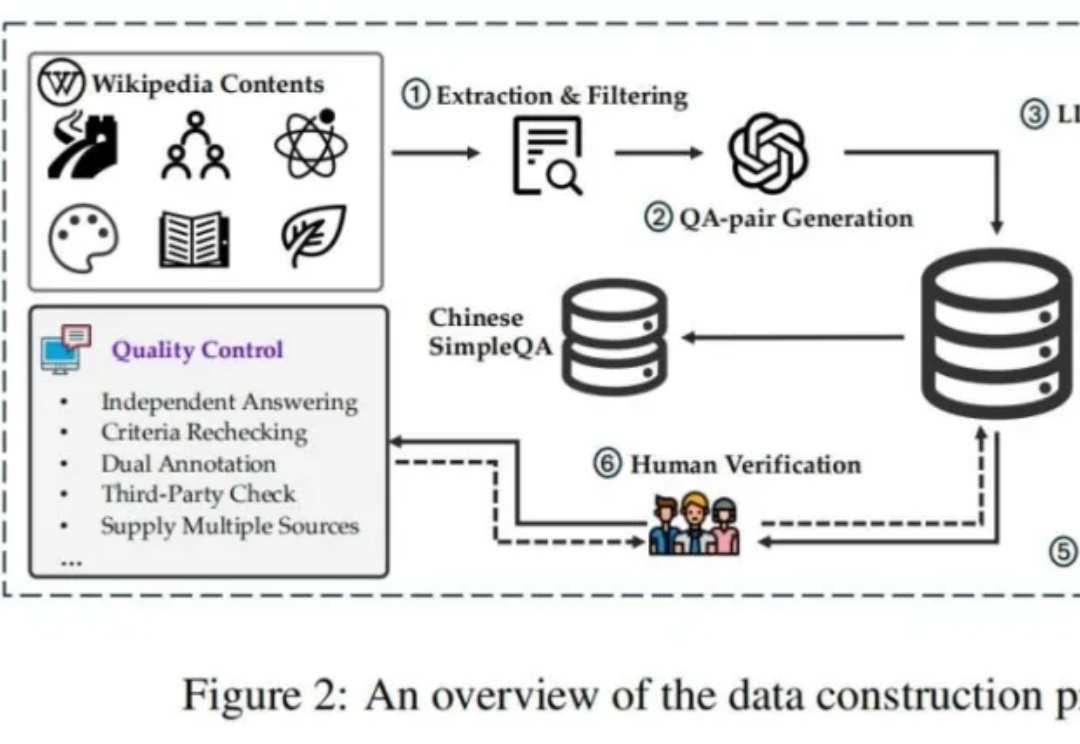
如何解决模型生成幻觉一直是人工智能(AI)领域的一个悬而未解的问题。为了测量语言模型的事实正确性,近期 OpenAI 发布并开源了一个名为 SimpleQA 的评测集。而我们也同样一直在关注模型事实正确性这一领域,目前该领域存在数据过时、评测不准和覆盖不全等问题。例如现在大家广泛使用的知识评测集还是 CommonSenseQA、CMMLU 和 C-Eval 等选择题形式的评测集。
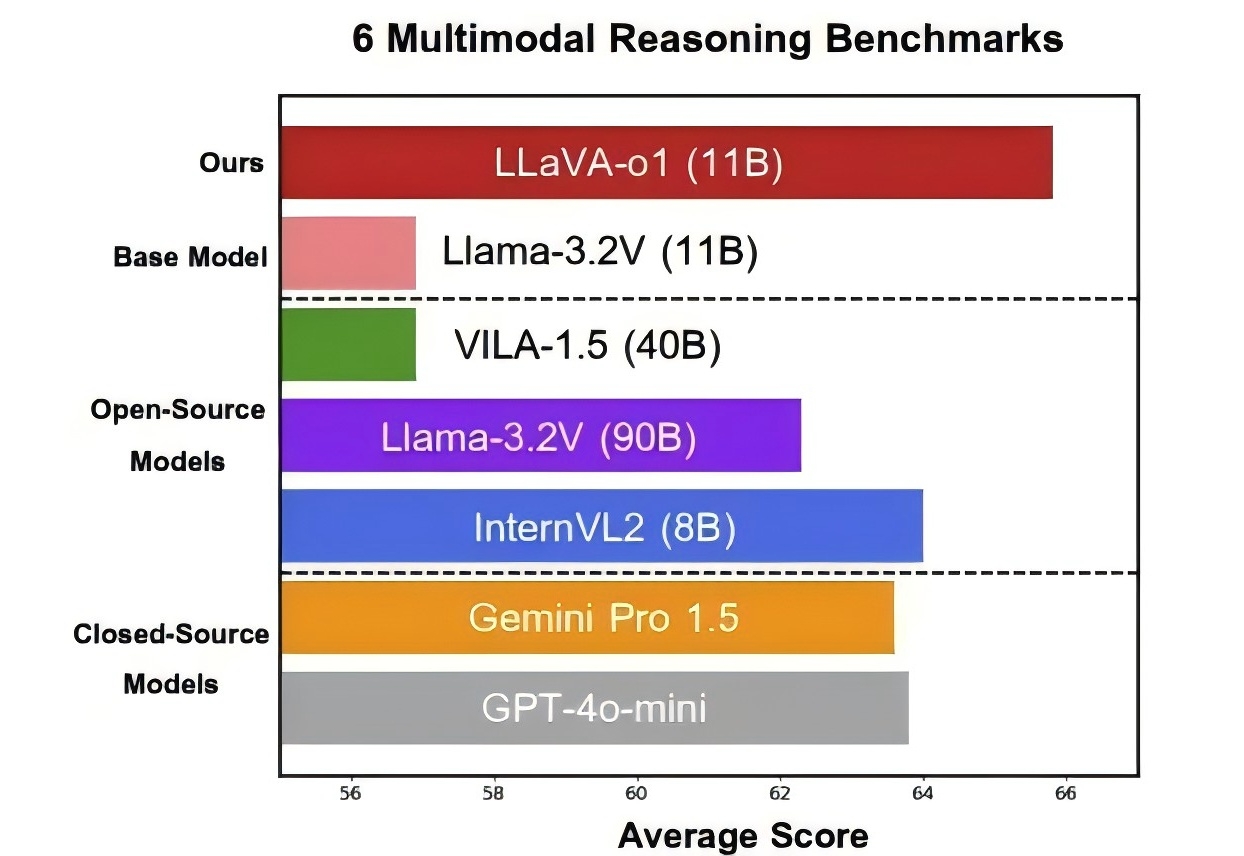
北大等出品,首个多模态版o1开源模型来了—— 代号LLaVA-o1,基于Llama-3.2-Vision模型打造,超越传统思维链提示,实现自主“慢思考”推理。 在多模态推理基准测试中,LLaVA-o1超越其基础模型8.9%,并在性能上超越了一众开闭源模型。
Open AI作为AI时代的科技先锋,每一个动向都备受关注。但是吃多了“网红化”带来的流量红利,Open AI似乎很难像学者一样老实待在实验室了。
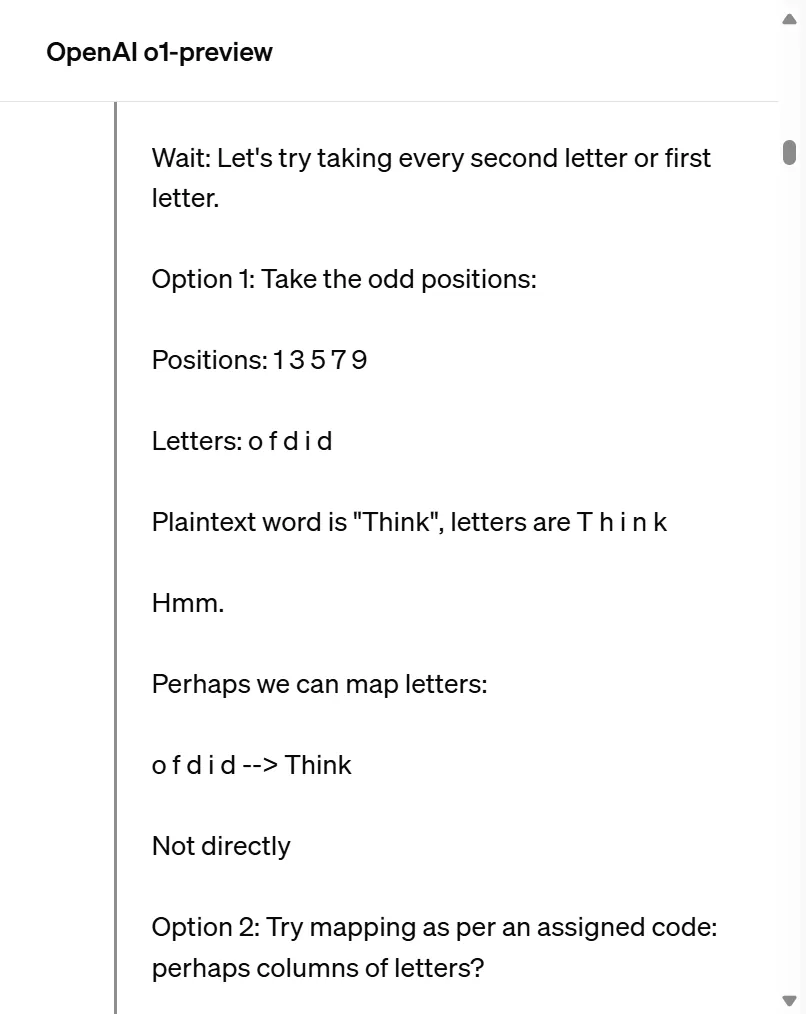
自我纠错(Self Correction)能力,传统上被视为人类特有的特征,正越来越多地在人工智能领域,尤其是大型语言模型(LLMs)中得到广泛应用,最近爆火的OpenAI o1模型[1]和Reflection 70B模型[2]都采取了自我纠正的方法。
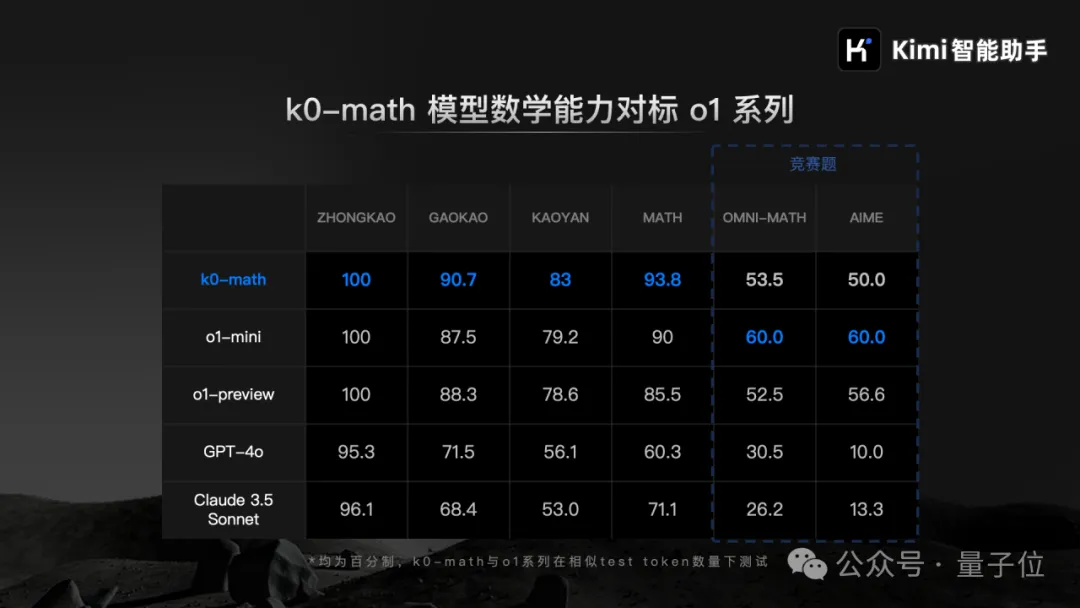
kimi全面开放一周年之际,创始人杨植麟亲自发布新模型—— 数学模型k0-math,对标OpenAI o1系列,主打深入思考。 在MATH、中考、高考、考研4个数学基准测试中,k0-math成绩超过o1-mini和o1-preview。
多智能体系统,可自动化整个 ML 工作流程,节省数千小时工时。