
谷歌Storybook故事生成器实测,我哭了一整夜
谷歌Storybook故事生成器实测,我哭了一整夜朋友,你只需输入下方的提示词。 给孩子解释下他是怎么来的,用宫崎骏的风格输出 一个儿童绘本就造好了。 有封面,能定制配图风格,有暖心的小故事。 甚至只花了不到 1 分钟。
来自主题: AI资讯
7595 点击 2025-08-08 12:57

 搜索
朋友,你只需输入下方的提示词。 给孩子解释下他是怎么来的,用宫崎骏的风格输出 一个儿童绘本就造好了。 有封面,能定制配图风格,有暖心的小故事。 甚至只花了不到 1 分钟。
昨天是个热闹的日子,OpenAI 和 Anthropic 几乎在同一时间发布了自家的新款模型:前者是自 GPT-2 以来重新开源的两款模型 gpt-oss(120b 和 20b),后者是 Claude 系列最强的 Opus 4.1。

大量工作在争夺用户注意力上,不少不错的细节提升,但没有大的惊喜,甚至一度有些好笑,“AGI”还早,肉搏时代开启了。
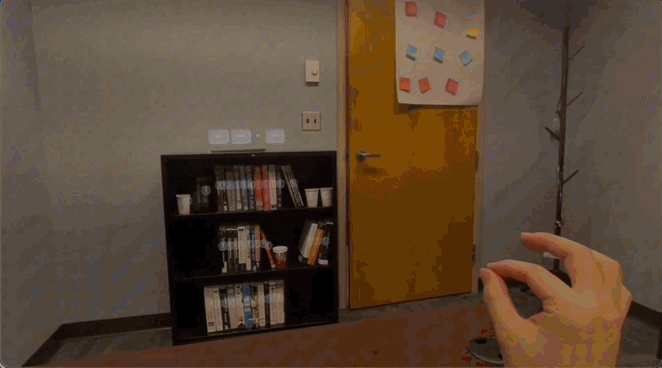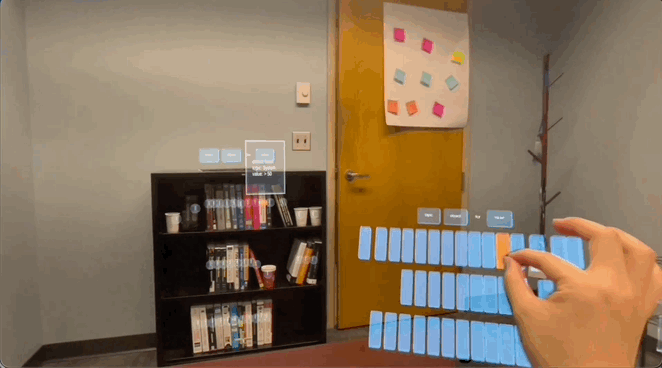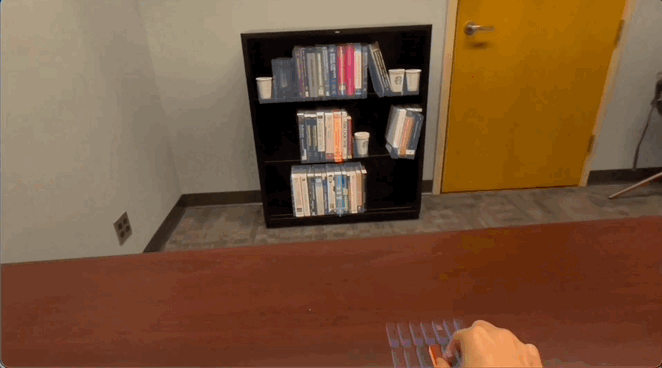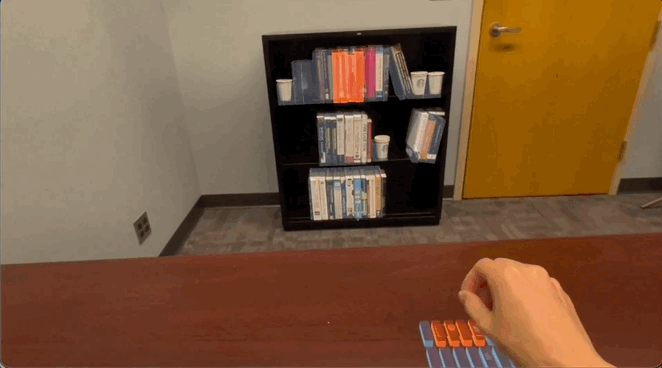
只靠说话和AI眼镜互动,确实有点不方便。现在新玩法来了!数字替身帮你“隔空抓物”,混合现实即时选择现实世界的物体作为上下文。
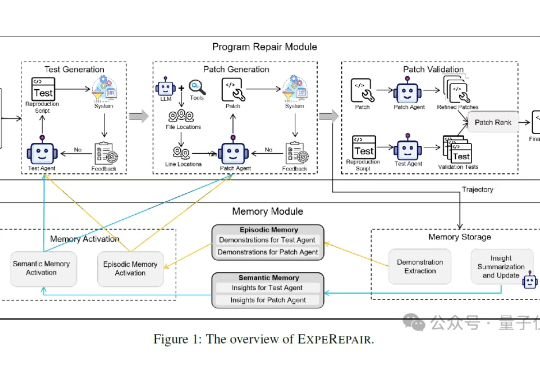
AI学会像人一样修Bug了!“这个Bug我上周刚修过”“这个报错怎么又来了”“新人怎么又在同一个地方踩坑”……
我非常不理解为什么有AI创业者选择播客赛道。 音频播客是一个非常小众的市场。小宇宙日活只有几百万,基本只有一线城市白领收听。就算是海外市场,Spotify都不能靠播客盈利,播客只会拖累其利润。 AI播客更是一个纯粹的、非常伪的伪命题。
2023年,当整个AI行业都在为“最强大模型”争得头破血流时,亚马逊云科技却洞察到一个关键事实:AI的价值不在于谁的模型最强大,而在于能否为不同场景选择最适合的模型。
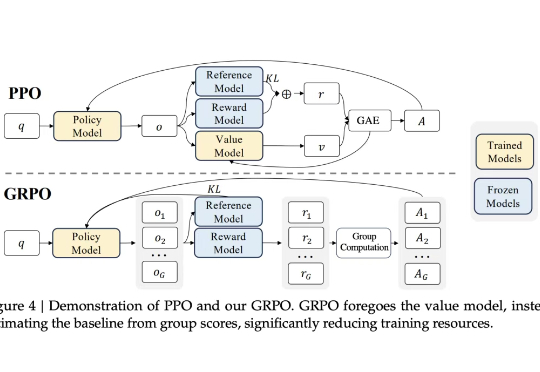
众所周知,大型语言模型的训练通常分为两个阶段。第一阶段是「预训练」,开发者利用大规模文本数据集训练模型,让它学会预测句子中的下一个词。第二阶段是「后训练」,旨在教会模型如何更好地理解和执行人类指令。
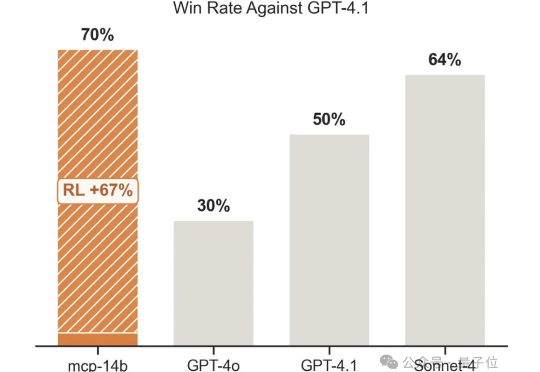
强化学习+任意一张牌,往往就是王炸。专注于LLM+RL的科技公司OpenPipe提出全新开源强化学习框架——MCP·RL。
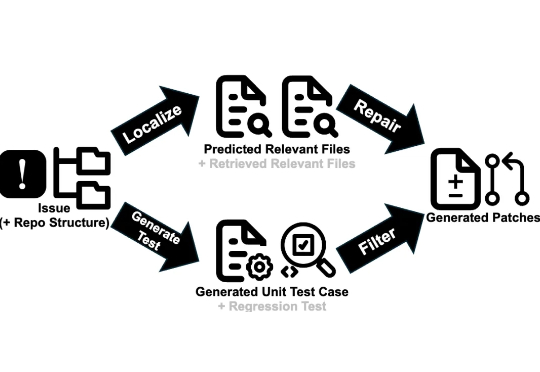
近日,一项由北京大学、字节跳动 Seed 团队及香港大学联合进行的研究,提出了一种名为「SWE-Swiss」的完整「配方」,旨在高效训练用于解决软件工程问题的 AI 模型。研究团队推出的 32B 参数模型 SWE-Swiss-32B,在权威基准 SWE-bench Verified 上取得了 60.2% 的准确率,在同尺寸级别中达到了新的 SOTA。