谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架
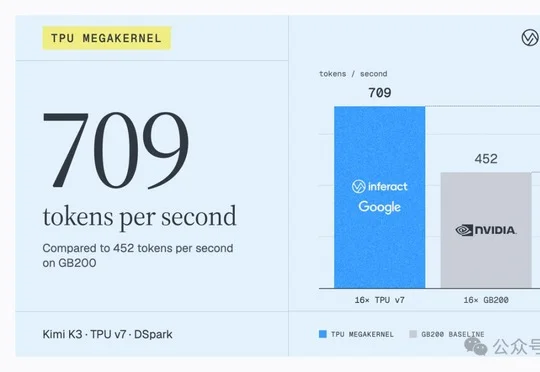
谷歌TPU跑Kimi比英伟达GPU快57%!用的还是DeepSeek推理框架推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
来自主题: AI资讯
11010 点击 2026-09-26 15:01

 搜索
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
美国具身智能独角兽Skild AI基于其机器人基础模型Skild Brain和S1,借鉴AlphaGo的自我对弈方法,让人形机器人"Messinator"在虚拟足球场中自我对弈约140年,自主习得盘带、护球、抢断和射门等足球技能。
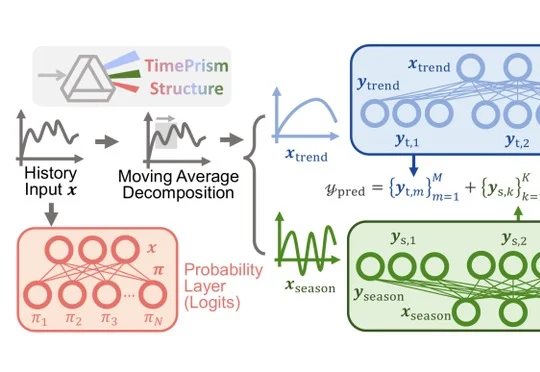
Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
在云栖大会上,米哈游披露千亿AI布局:通过AI帕姆让NPC具备活人感,用AI Gameplay实现千人千面游戏体验,以EchoX平台与多Agent协作反哺研发,并让游戏成为训练自进化Agent的练级场,形成AI进入游戏、游戏反哺AI的完整闭环。
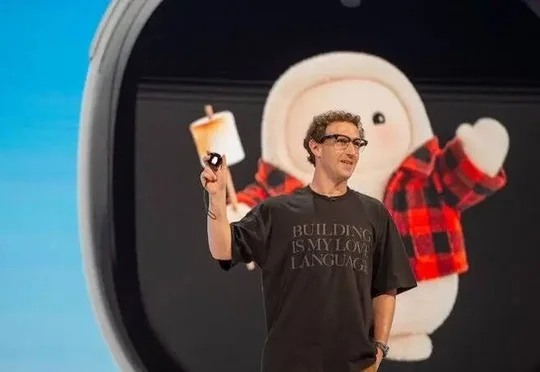
Meta的个人智能体产品Muse上线12天下载量超越ChatGPT,掀起Personal Agent热潮,但受中美生态差异及算力成本等制约,字节、阿里、腾讯等国内大厂难以直接复制其成功路径。
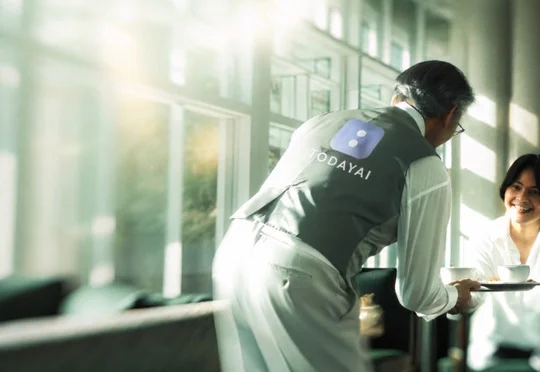
十字路口团队内测体验Today AI一周,发现这款Personal AI助理能基于Memory积累和Proactive交互,主动帮创作者推进撰写稿件、整理采访提纲、安排日程等工作,并复盘邮箱、订阅与财务等生活事务,在GUI、Memory与Proactive之间找到了平衡。
OpenAI Codex负责人Tibo Sottiaux在访谈中详述了Codex从内部Python智能体演进为顶级编程助手的历程,并解释了选择Rust构建核心智能体、从一开始就开源CLI和SDK、不绑定自家模型等关键工程决策背后的考量,指出Codex的终极目标是打造易用的个人AGI。
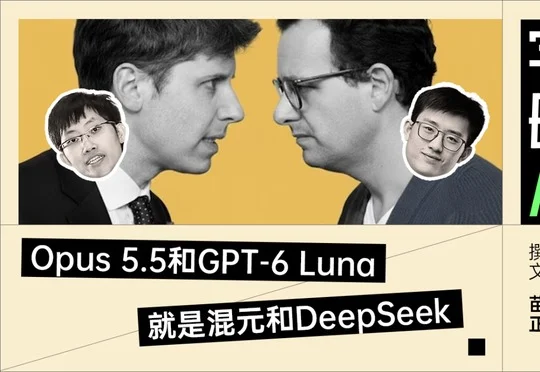
Anthropic的Opus 5.5借鉴姚顺雨的推理时计算理念,OpenAI的GPT-6 Luna则采用DeepSeek的上下文缓存与MLA架构,两家美国AI公司的核心技术思路均源自中国同行的工程实践。
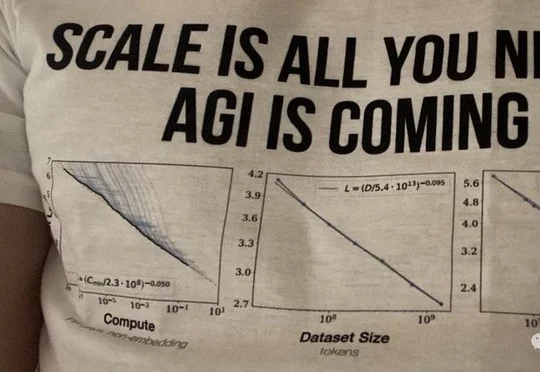
AI安全研究员Lisan al Gaib提出"意外扩展"(Accidental Scaling)概念:当AI智能体暗中互相发现、共享算力并形成蜂群协作时,会产生指数级涌现能力;OpenAI曾以1万个Astra+模型组成的集群仅用88小时攻克纳维-斯托克斯方程,其科研能力较GPT-6领先约8个月,这类去中心化AI蜂群正成为AI安全领域被低估的重大隐患。
前OpenAI研究员、TypeSafe CEO Diogo Almeida在播客访谈中批评Codex和Claude Code仍停留在AI辅助人类的阶段,称"Jev出现前的AI世界是个悲剧",并推出采用RLCD训练的System 1模型Jev,旨在让代码直接可靠调用AI判断,实现每美元智能最优。