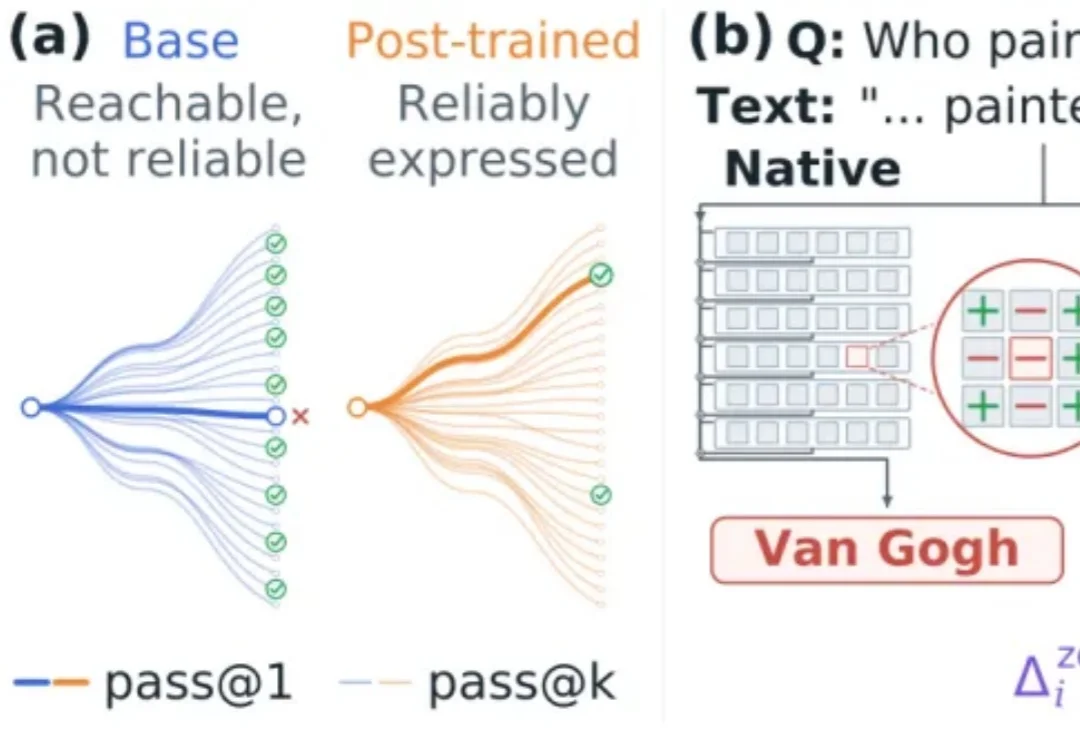
偏好对齐也能在推理时完成!256-16384个控制参数达到DPO水准
偏好对齐也能在推理时完成!256-16384个控制参数达到DPO水准让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
来自主题: AI技术研报
7605 点击 2026-10-13 14:06

 搜索
让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
Meta发布新一代旗舰模型家族Muse Wonder,推出Muse Wonder和Muse Wonder Full,引入Active Memory与Active Focus,并在Agent、记忆及编程等关键评测中取得领先成绩。
Anthropic,怕是又憋了个大的!
Z Potentials 独家获悉,上海半图科技(SemiGraph)已完成单轮超过千万美元融资,由联想创投等多家国内及海外一线资本领投,老股东IDG资本持续加码。本轮融资将主要用于人类行为模型研发、数据体系建设、团队扩充,以及AI原生3D互动场景的产品化落地。
国庆前,海外各家大厂的Personal Agent产品下饺子一样出现。
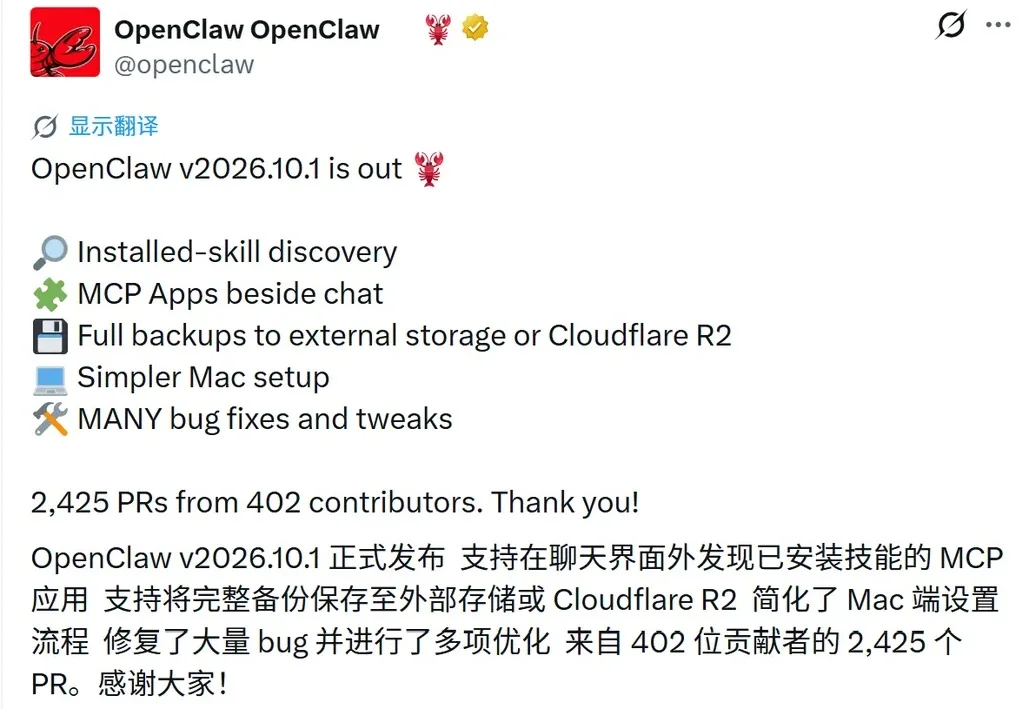
在无人在意的角落,OpenClaw 又更新了。
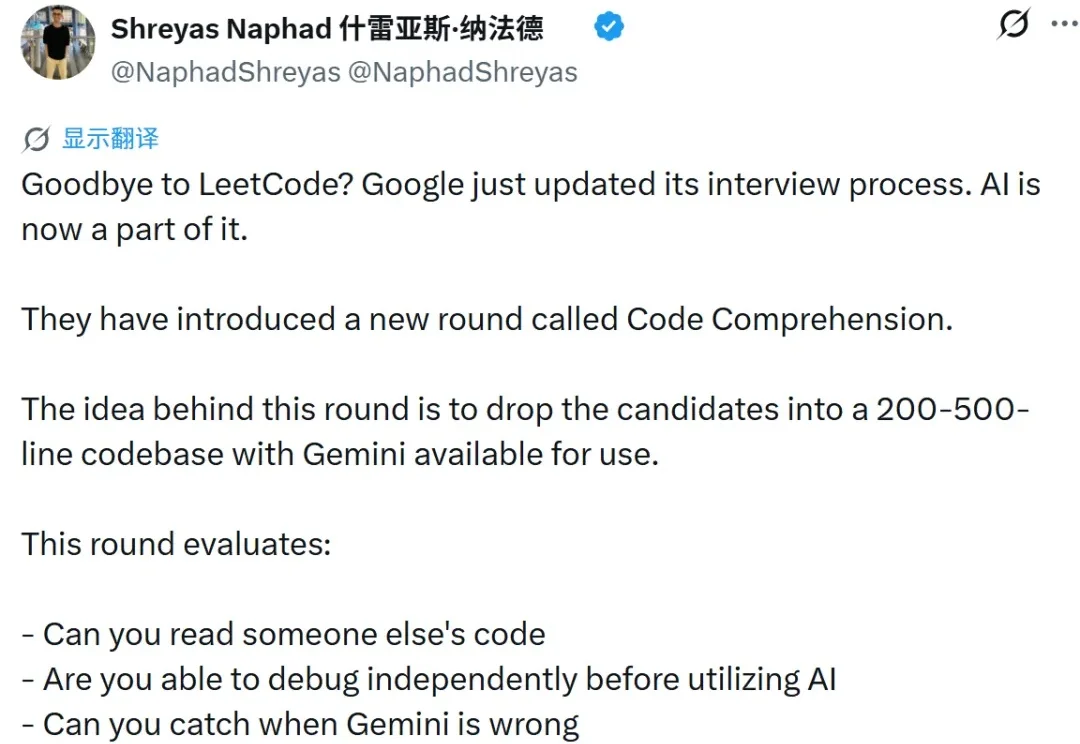
程序员面试的时候,终于可以光明正大地打开 AI 了。
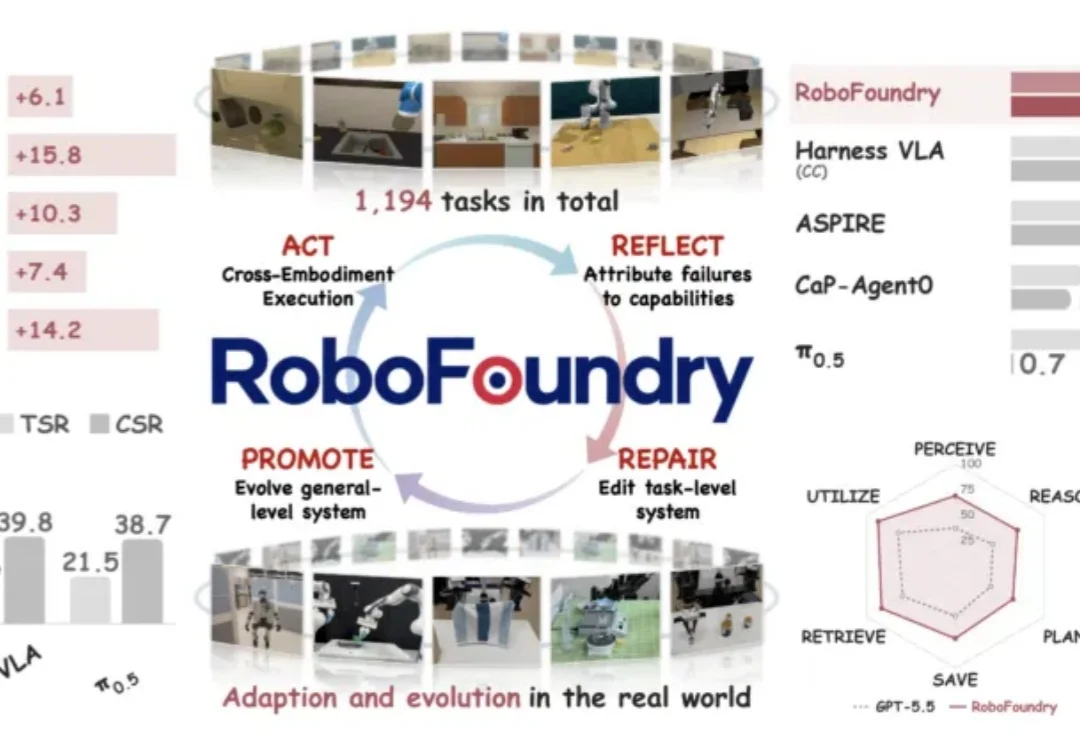
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
最近,全世界的数学圈都被AI核爆了。
vLLM Semantic Router推出并开源Decision 3.0系列多模态决策模型,覆盖0.6B至27B六款模型,其中d3在Jev Decision Index 0.3.1文本榜和视觉榜均排名第一。