通往通用人工智能的关键一步?DeepMind放大招,3D世界最强AI智能体SIMA 2
通往通用人工智能的关键一步?DeepMind放大招,3D世界最强AI智能体SIMA 2您的 AI 伙伴「游戏陪玩」版已上线。
来自主题: AI技术研报
8368 点击 2025-11-20 14:54

 搜索
您的 AI 伙伴「游戏陪玩」版已上线。
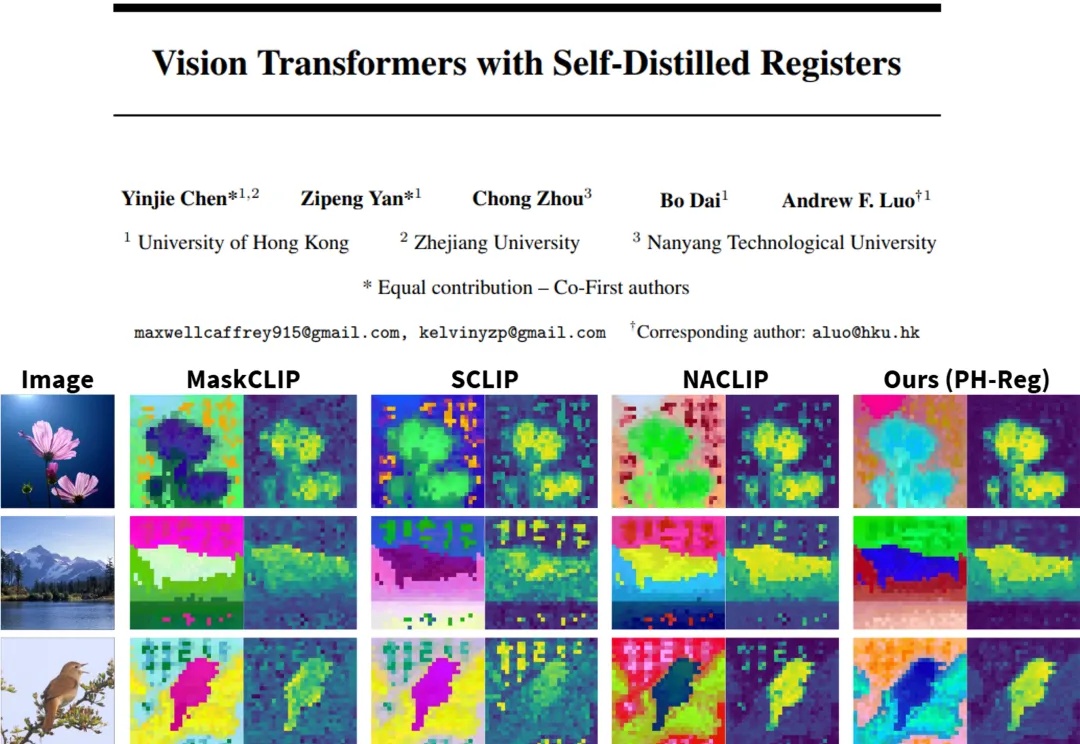
在视觉处理任务中,Vision Transformers(ViTs)已发展成为主流架构。然而,近期研究表明,ViT 模型的密集特征中会出现部分与局部语义不一致的伪影(artifact),进而削弱模型在精细定位类任务中的性能表现。因此,如何在不耗费大量计算资源的前提下,保留 ViT 模型预训练核心信息并消除密集特征中的伪影?

2024年以来,从苹果Vision Pro将「空间计算」推向巅峰,到Peloton Guide、Nex Playground等「AI摄像头」硬件开始在小规模市场中验证可行性,风口已然初现。
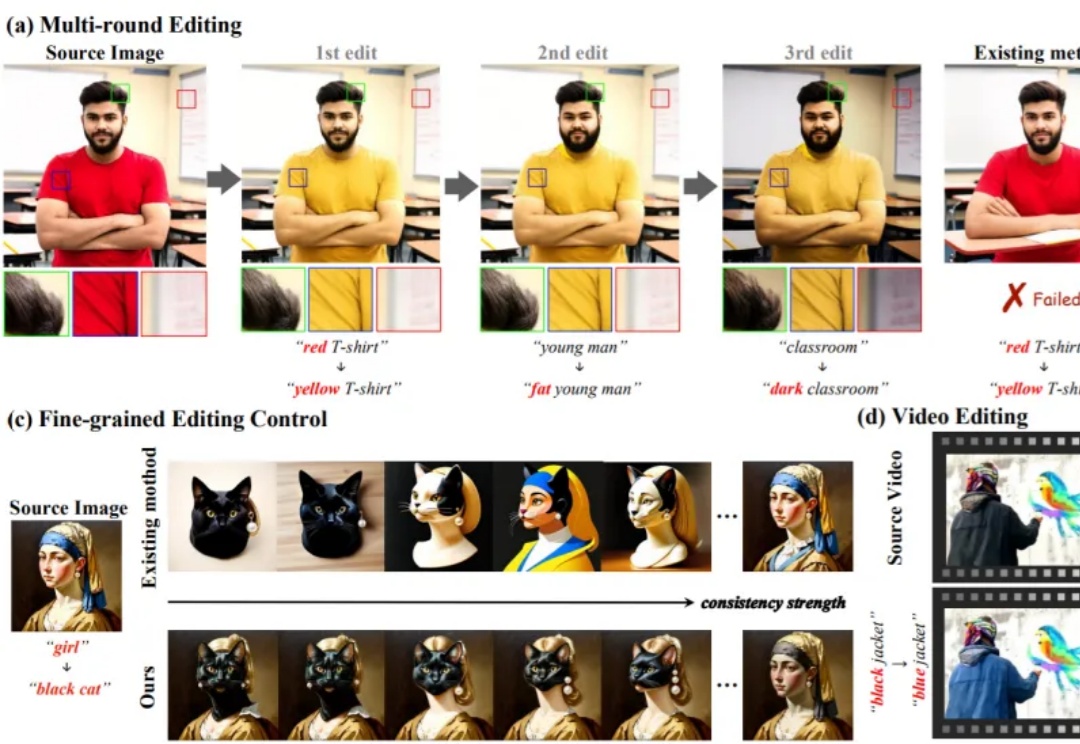
无需额外训练即可适配预训练生成模型的编辑方法,凭借灵活、高效的特性,已成为视觉生成领域的研究热点。这类方法通过操控 Attention 机制(如 Prompt-to-Prompt、MasaCtrl)实现文本引导编辑,但当前技术存在两大核心痛点,严重限制其在复杂场景的应用
2025年11月13日,创新医疗技术公司 Beacon Biosignals 宣布完成 8600 万美元(约合人民币6.1亿) B 轮融资,由 GV(Google Ventures)、Takeda、Catalio 等跨科技与生命科学领域的重磅机构联合投资,使公司累计融资突破 1.21 亿美元。
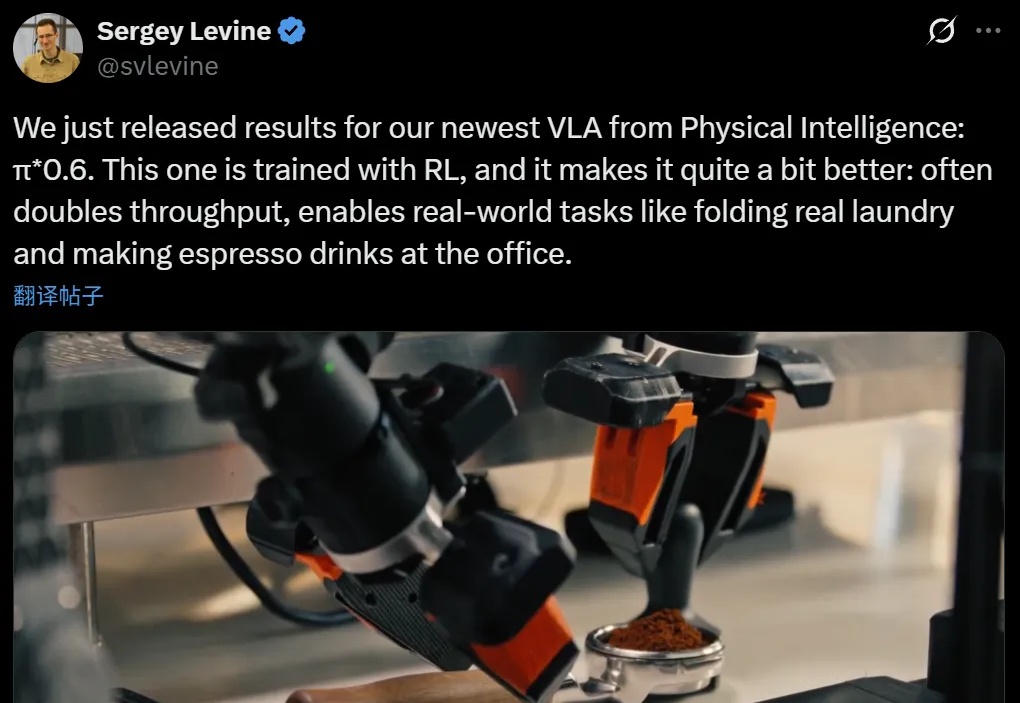
本周,美国具身智能创业公司 Physical Intelligence(简称 PI 或 π)发布了旗下的最新机器人基础模型 π*0.6。PI 是一家总部位于旧金山的机器人与 AI 创业公司,其使命是将通用人工智能从数字世界带入物理世界:他们的首个机器人通用基础模型名为 π₀,让同一套软件控制多种物理平台执行各类任务。
最近,小编注意到一位全栈工程师 Rohith Singh 在Reddit上发表了一篇帖子,介绍他如何对四个模型(Kimi K2 Thinking、Sonnet 4.5、GPT-5 Codex 和 GPT-5.1 Codex)进行了实测。
十年前,我们是国际顶会的仰望者;十年后,SIGGRAPH Asia重返家门,中国已从技术跟跑者变为AI与图形融合新时代的定义者之一,这场盛会不仅是一次技术复盘,更是一次面向全球的实力宣言。
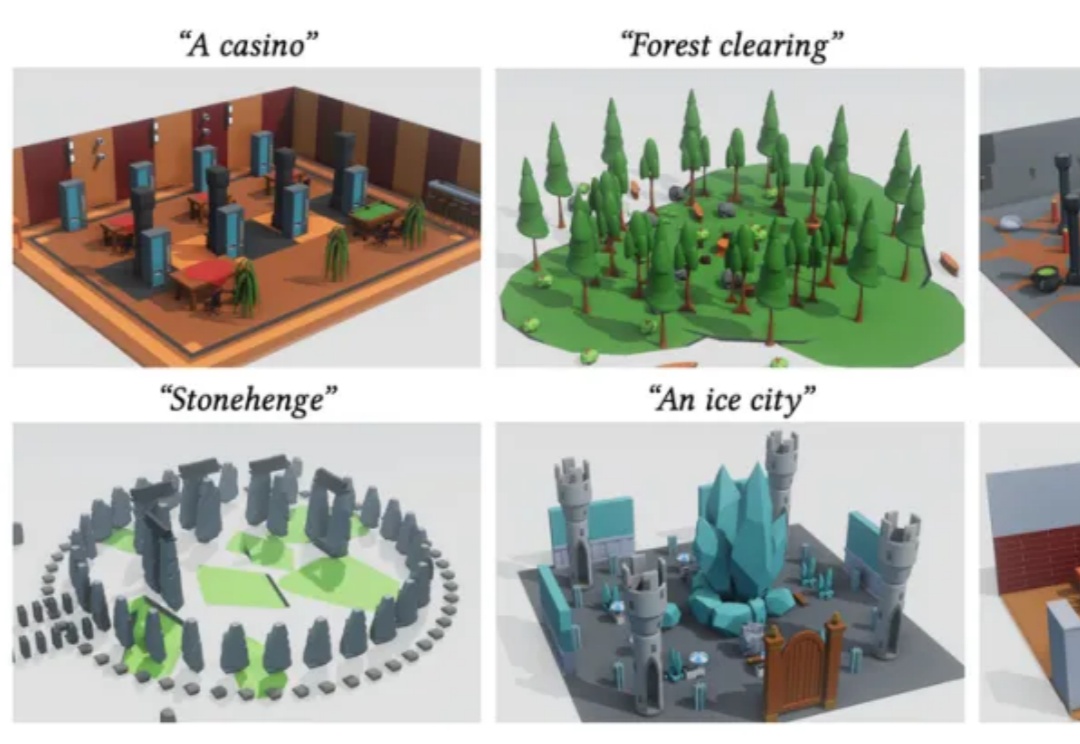
随着生成式 AI 的快速发展,从文本生成图像、视频,到构建完整的三维世界,AI “创造空间” 的能力正以前所未有的速度突破边界。然而,现有 3D 场景生成方法仍存在明显局限:模型往往直接输出每个物体的几何参数(位置、大小、方向等),结果容易出现漂浮、重叠、穿模等问题;场景结构缺乏逻辑一致性,难以编辑或复用,更无法像程序那样精确控制空间关系与生成逻辑。
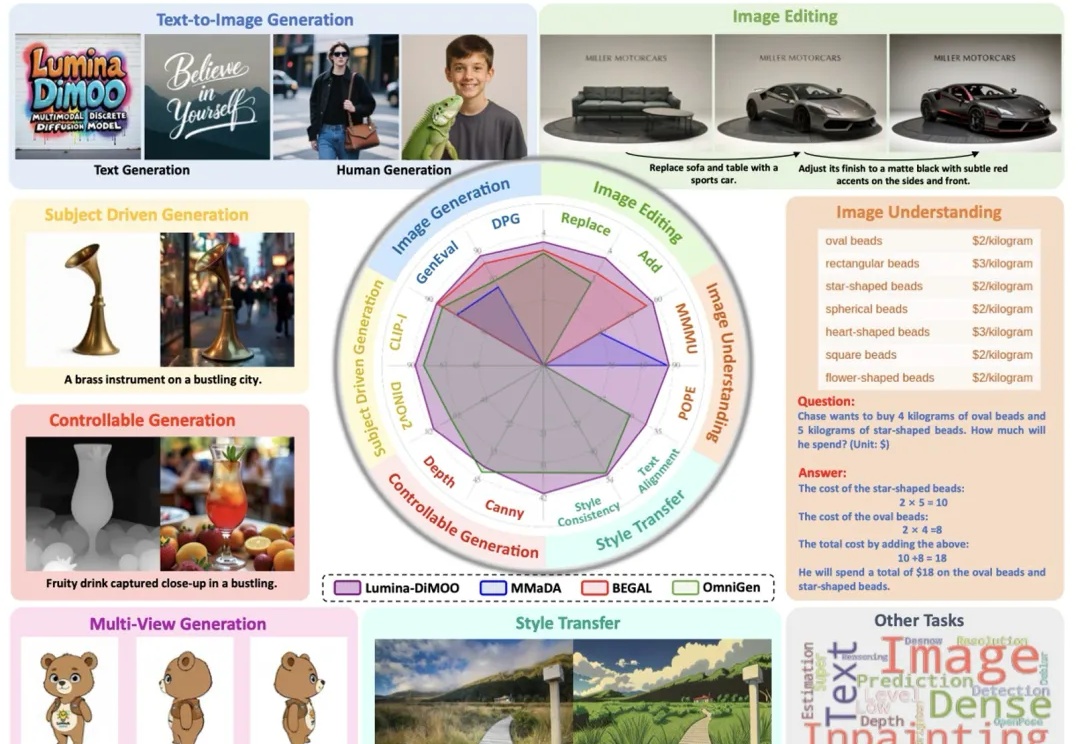
上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。