OpenAI骑脸输出!仅5分钟,把GPT-5.6塞进Claude老家
OpenAI骑脸输出!仅5分钟,把GPT-5.6塞进Claude老家OpenAI高管亲自下场,教开发者5分钟极速「策反」Claude Code,这波贴脸开大太狠了。
来自主题: AI技术研报
7532 点击 2026-07-13 16:02

 搜索
OpenAI高管亲自下场,教开发者5分钟极速「策反」Claude Code,这波贴脸开大太狠了。
过去几年,大语言模型几乎成为了AI的代名词。从ChatGPT到Google DeepMind推出的Gemini,从Anthropic开发的Claude到中国的DeepSeek,人们讨论更多的是聊天机器人、推理能力和生成内容。但如果问Google DeepMind CEO、2024年诺贝尔化学奖得主Demis Hassabis(下简称“哈萨比斯”)
几个月前,马斯克还骂Anthropic「邪恶」,断言它「不可能赢」,如今突然改口称它是「当前AI最强」。 手握22万块GPU的他,为何没有趁机断供对手?

7 月 8 日,韩国知名开发者 remy_notes 在 Threads 上晒出两张 Anthropic 发票截图:第一张 166.9 万美元(约 1130 万元人民币),第二张 1662 万美元(约 1.1 亿元人民币)。两张发票间隔不到 24 小时,金额翻了近 10 倍。
近日,Anthropic官方发了一篇长文专门来讲这件事。 起因是太多人把Claude Code里的两个选项搞混了:一个是模型选择(Model),一个是努力度(Effort)。过去,大家对这两个选项的理解都很简单:换更大的模型,AI就更聪明;把Effort调高,无非是让AI多想一会儿。
NFX 的 Pete Flint 写了篇文章,讲一个我这一个月一直在旁边打转、但没人替我一句话说清的东西。他说,种子轮的创业者,现在开始拿 Tesla、SpaceX 那套「垂直整合」来 pitch 了——不是「给律师做个 AI 工具」,是「一家 AI 原生的律所」;不是「做个软件采购平台」,是「最终要 own 掉整条供应链」。
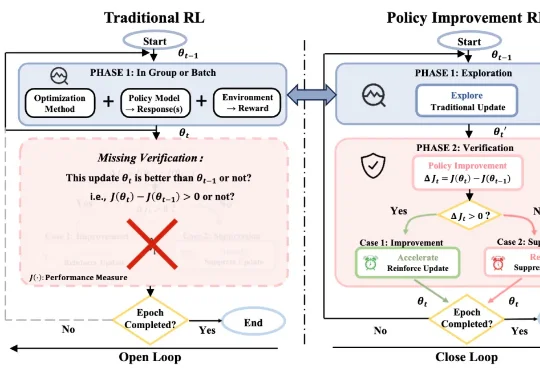
来自北航、北大、美团的研究团队提出了Policy Improvement Reinforcement Learning, PIRL,以及对应的落地算法 PIPO。这项工作关注的是大模型 RL 后训练中一个非常基础、但长期被默认跳过的问题:一次更新在当前数据上看起来优化了学习信号,是否就真的说明模型策略变强了?
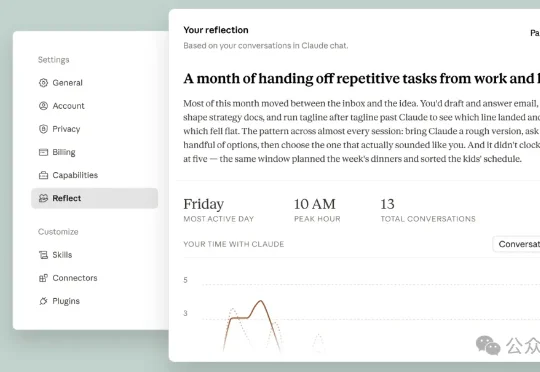
这回,Anthropic要劝你,别太沉迷Claude了。它上线了Reflect功能的Beta测试版,面向Free、Pro、Max用户开放。这个藏在设置里的面板,想帮你搞清楚一件事:什么时候该用Claude,什么时候该关掉它。
微软Copilot & Agents Core总裁Nitin Agrawal说,「迫不及待想让客户看到GPT-5.6能做什么」——不管是起草文档、分析数据、做演示,还是跨团队协作,产出都会更精致。除了原生接入模型,微软还会直接通过OpenAI API调用GPT-5.6,服务Microsoft 365客户。双通道,齐上阵。
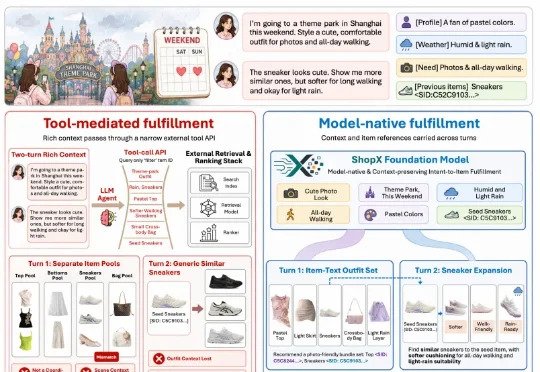
团队提出了ShopX:一个面向agentic shopping的电商大模型。它不仅仅是在搜索框外面套一个会“说话”和“调用工具”的LLM,而是赋予模型直接进入商品空间的能力,让大模型成为商品履约的核心,学会在商品空间中规划、检索、排序、组合和生成结果,进而减少接口损耗。