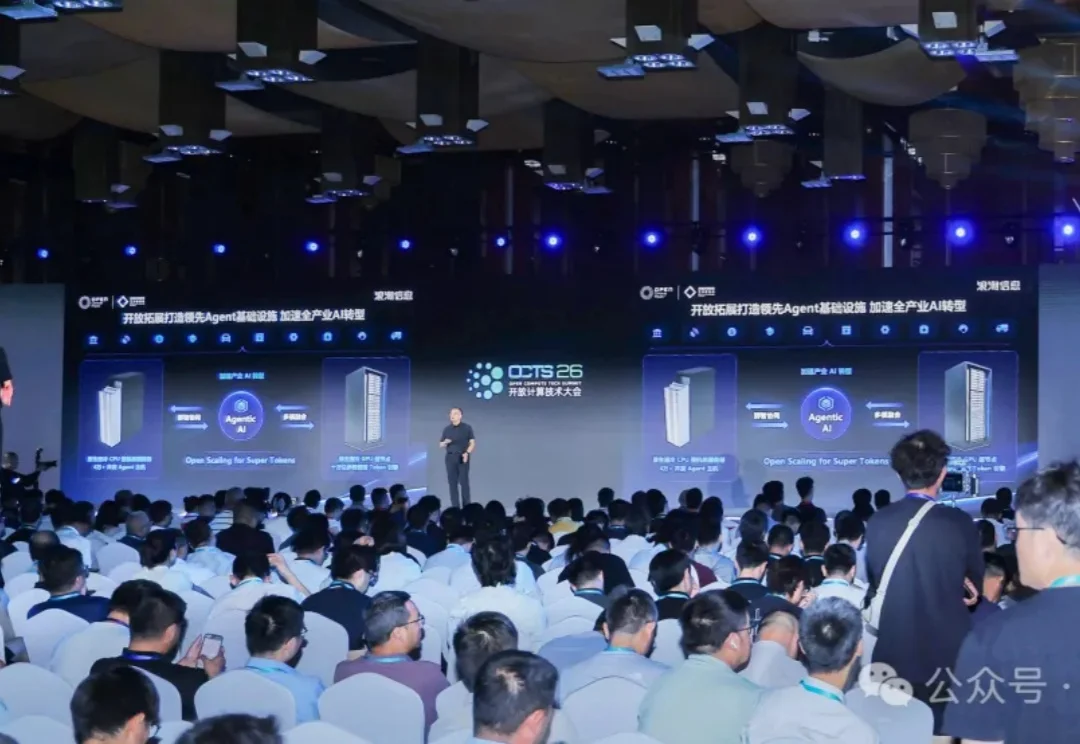
Agent要数量也要脑子!浪潮信息一边单柜养4万Agent,一边让大模型组队答题
Agent要数量也要脑子!浪潮信息一边单柜养4万Agent,一边让大模型组队答题AI基础设施的核心任务,已经从支撑大模型推理,转向支撑海量智能体的规模化运行与高质量Token的持续生产。
来自主题: AI资讯
9804 点击 2026-07-14 10:35

 搜索
AI基础设施的核心任务,已经从支撑大模型推理,转向支撑海量智能体的规模化运行与高质量Token的持续生产。
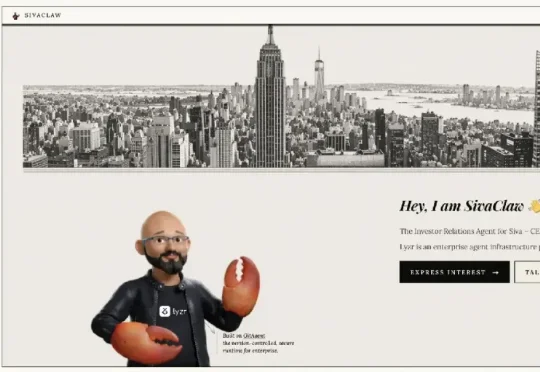
Lyzr 的为其 Agent B 轮融资开展外联活动。该轮融资据公司称有望筹集 1 亿美元,估值约为 5 亿美元。Agent 回应了来自 130 多位投资者的查询,并协助起草了数十份投资备忘录。最终,这家获得 Accenture 支持的公司吸引了来自硅谷基金、中东风投公司和金融行业投资者共计 4 亿美元的兴趣。
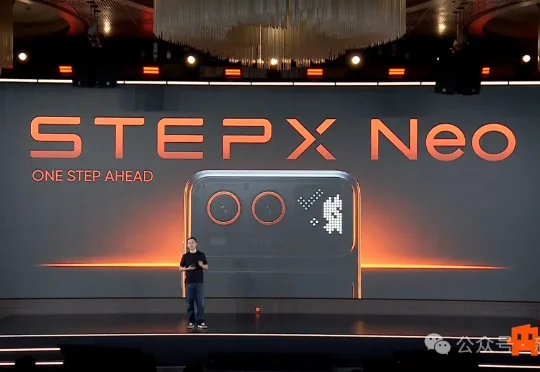
就在今天,阶跃星辰在发布会上一口气抛出三样东西——全球首个大模型原生AI终端品牌STEPX;全球首个智能体原生操作系统Step AOS;全球首款大模型原生智能体手机STEPX Neo。
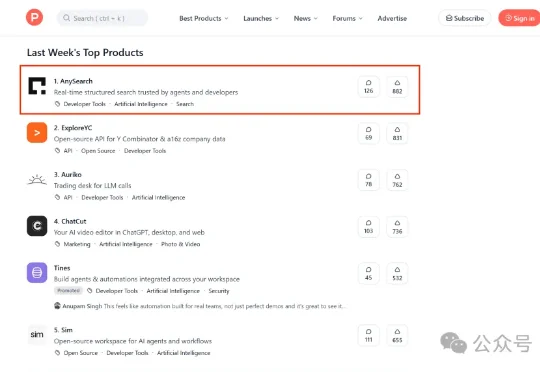
本期Product Hunt周榜Top 1出自中国团队,AnySearch——一款AI搜索产品。过去一年,PH榜一的位置被Agent、AI IDE、大模型轮番占据,几乎没见过搜索类产品的影子。就是因为在全球开发者眼里,普通AI搜索已经很难突围了。
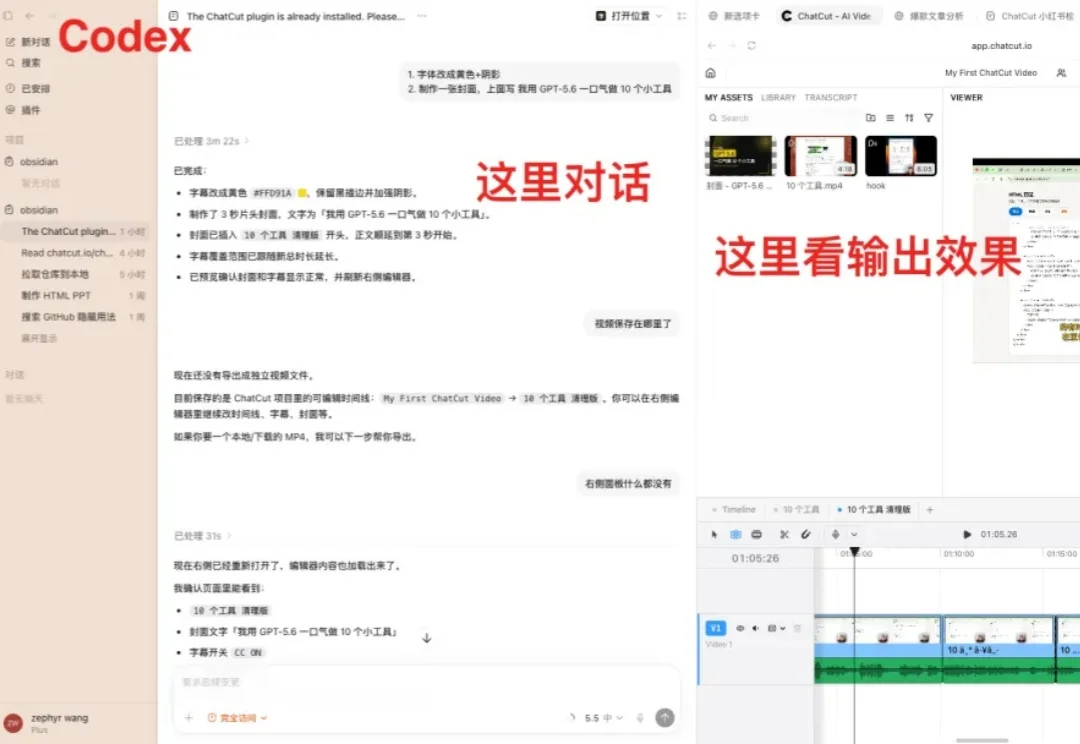
最近刷小红书,总能刷到 ChatCut。
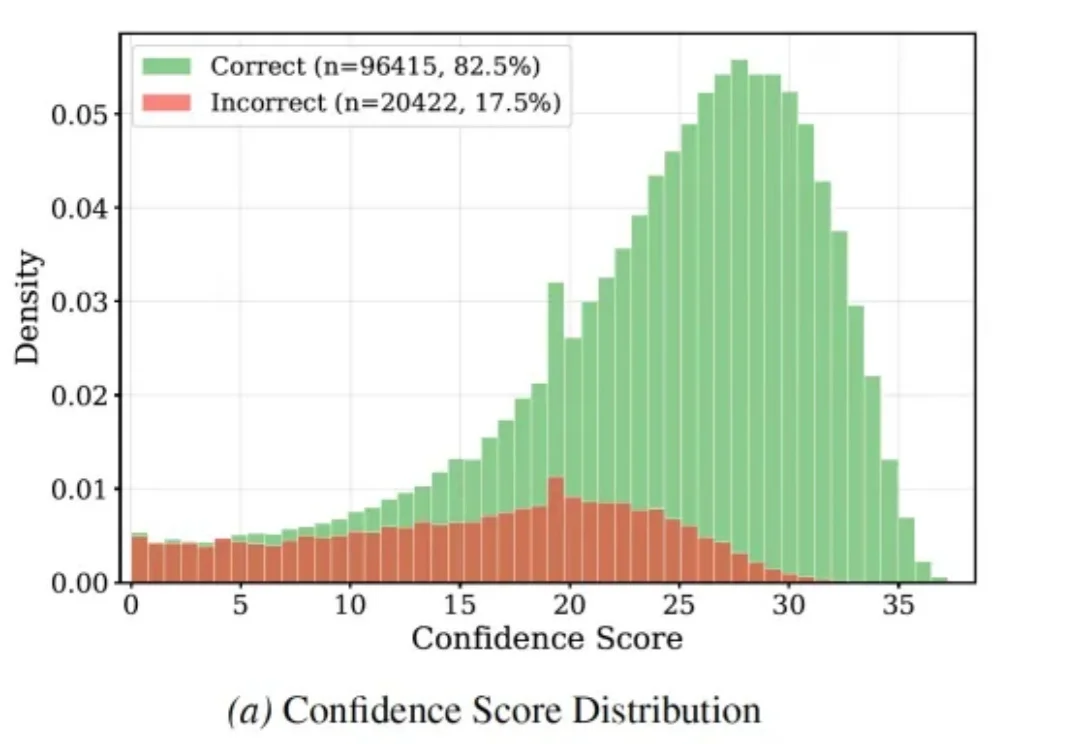
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
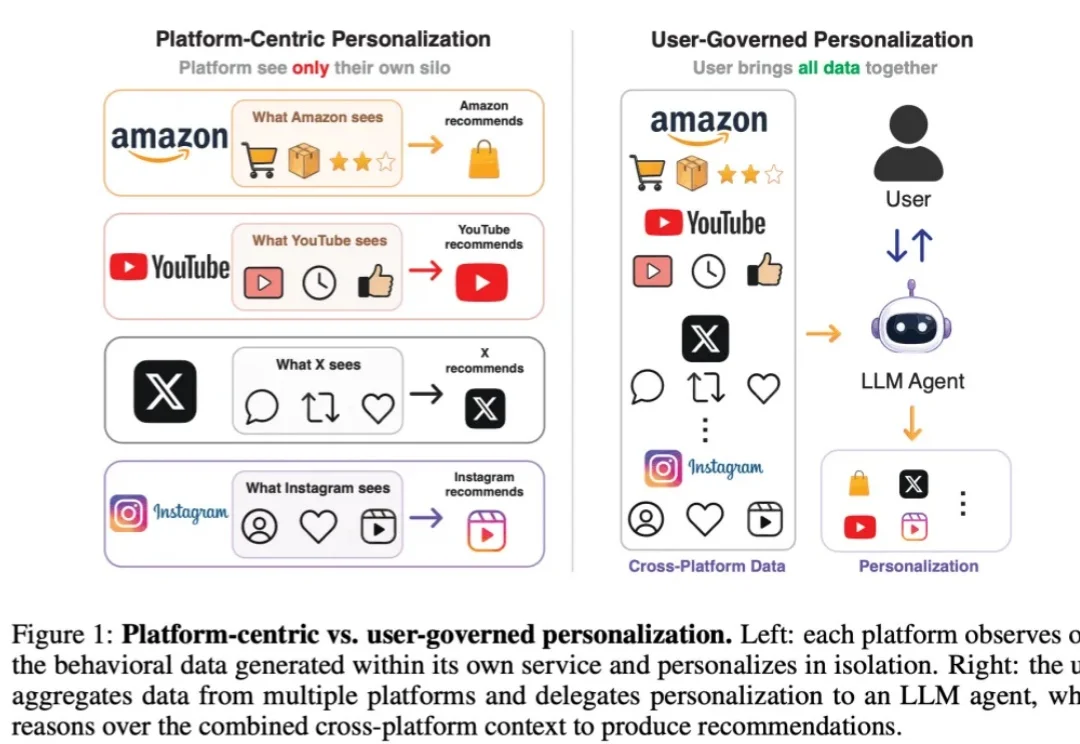
在过去二三十年的互联网发展中,个性化推荐几乎一直是平台的核心能力之一。打开视频 app,平台决定你接下来会刷到什么视频;打开购物软件,平台预测你可能会购买什么商品;打开短视频 app,平台根据你的浏览、点赞、停留和互动,不断优化信息流。某种意义上,现代互联网的用户体验本身就是由推荐系统塑造的。
过去几年,大语言模型几乎成为了AI的代名词。从ChatGPT到Google DeepMind推出的Gemini,从Anthropic开发的Claude到中国的DeepSeek,人们讨论更多的是聊天机器人、推理能力和生成内容。但如果问Google DeepMind CEO、2024年诺贝尔化学奖得主Demis Hassabis(下简称“哈萨比斯”)

上周六,7月11号,我去了旧金山一家叫Corgi Cafe的地方,参加了一场demo day。这场活动本来定在6月20号,后来因为场地和大家时间的原因,改到了这一天。主办人提前在群里说,活动在二楼,大家先在楼下咖啡馆等,她会带人上去。5点demo正式开始,一直到7点,中间还留了开放麦的环节,谁想上去讲两句都可以。
把腾讯WorkBuddy用透,你26年下半年会轻松很多。