VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测
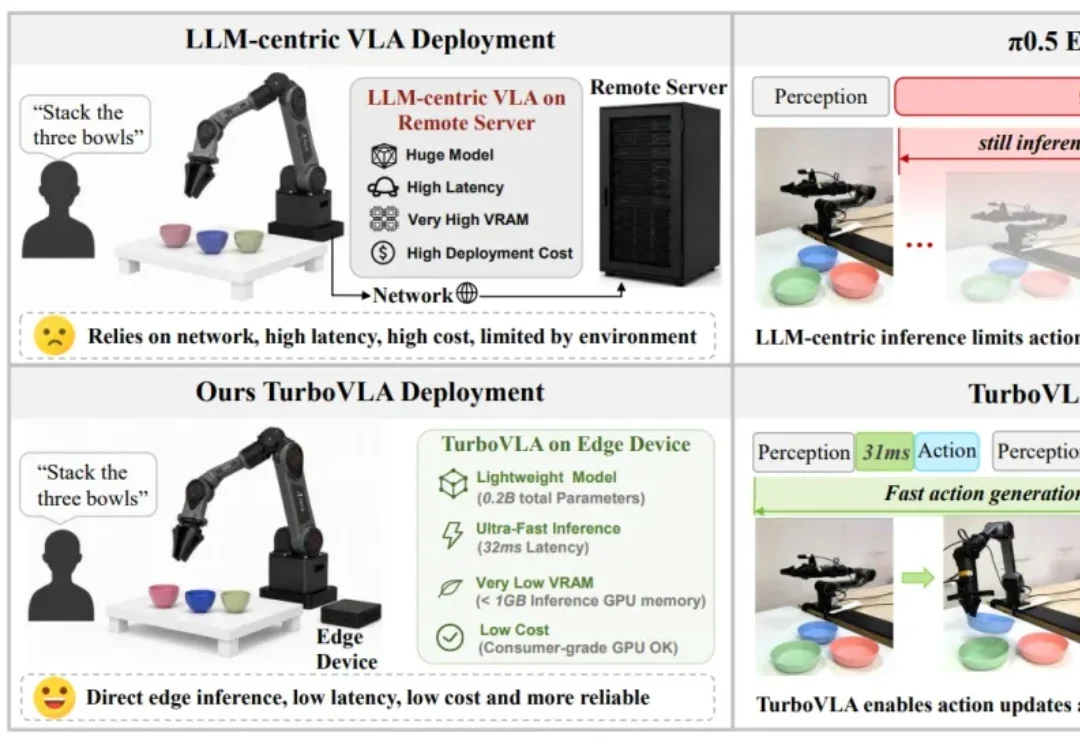
VLA动作预测必须经过LLM吗?TurboVLA仅0.2B参数,RTX 4090上跑出32Hz在线动作预测近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
搜索
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
8 月 3 日,在 AGI Playground 2026 大会上,Genspark 创始人&CEO 景鲲在现场发布了一款新产品 GenOffice。这是一个面向 Windows 和 Mac 的本地 Office 客户端。开源、免费、无广告,保留用户熟悉的文档编辑能力,同时把 AI 引入 Word、PPT 等高频办公场景。
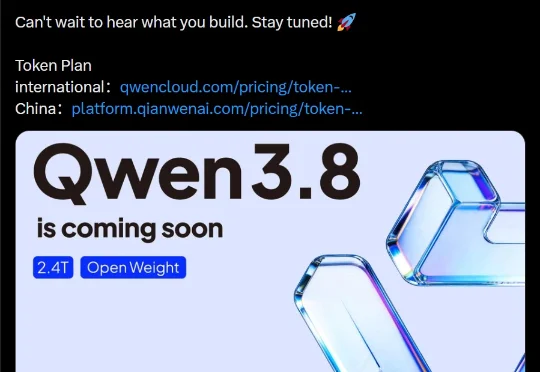
8 月 3 日,阿里巴巴正式发布新一代基座大模型 Qwen3.8,总参数量 2.4 万亿,在编程(Coding)和专业办公(Cowork)方面能力大幅提升。今日放榜的权威三方榜单 Arena 中,阿里 Qwen 模型仅次于 Anthropic 的 Claude 系列,整体性能处于全球大模型第一梯队。。
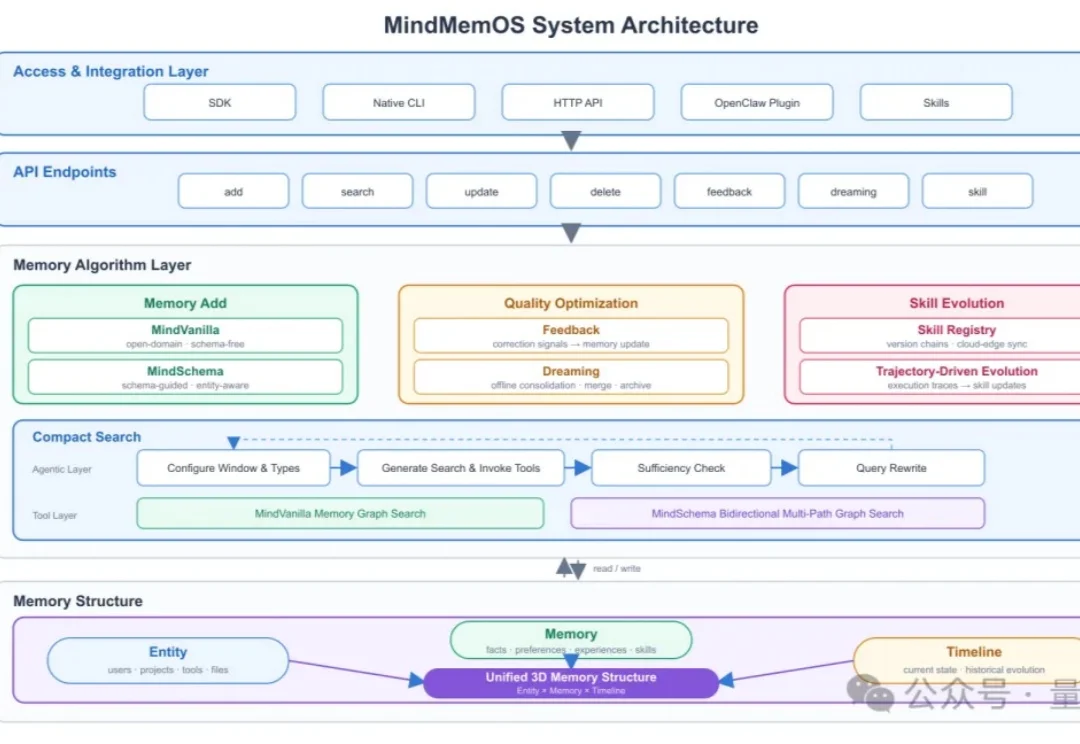
Agent的能力越来越强,但使用体验仍有一个尴尬之处: 每换一个Agent甚至换一个session,就像换了一个完全不了解你的新员工。
前段时间,米哈游的一个工程师,在测多Agent协作时忘了设熔断。几十个Agent进入循环调用。
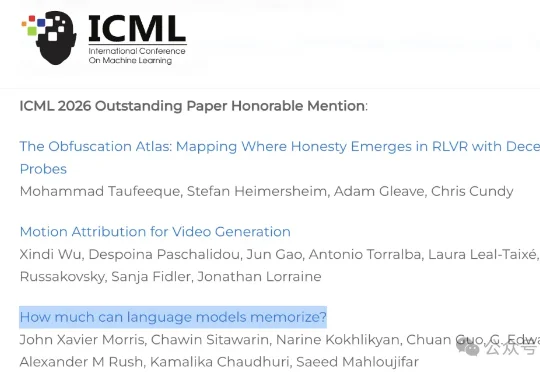
一个80亿参数的大模型,一口气吞下15万亿token的训练数据,堆到硬盘上差不多7TB。可它真正「背」得下来的,少得可怜:每个参数只装得下3.6 bit。一个英文字母8 bit,连半个都填不满。
Seltz为Agent自建一套持续更新的Web索引,让它能够及时看见公开网络中正在发生什么;AnySearch聚合开放Web和20多个垂直数据源,让Agent知道面对不同问题应该去哪里查;Octen则重写索引、排序和服务层,让Agent可以同时展开几十甚至上百次查询,更快、更大规模地看见信息。
Factory 成立于 2023 年 4 月。彼时,企业市场连 GitHub Copilot 都尚未完全接受,更不用说完全自主的 AI 软件工程代理(Autonomous Agents)了。Matan 形容创业最初的两年是一场在沙漠中的跋涉:技术理念过于超前,工程师还没准备好改变习惯,企业采购团队也充满怀疑。
今年,这条研究路线又往前走了一步。6 月,李飞飞参与的一项机器人研究 T-Rex 发布,研究者为机器人加入高频触觉反馈,让它完成翻书页、拿鸡蛋、挤牙膏、抽取薄卡片和拧灯泡等任务。
JarvisHub 给出的答案,是把可编辑画布同时变成用户工作区、Agent 的外部记忆、行动空间和共享项目状态。Agent 不再只从聊天记录里猜测上下文,而是直接「看」到画布上的提示词、参考图、候选版本、生成结果、依赖关系、失败记录和用户反馈,再据此规划、调用工具、写回结果。