DeepMind AlphaEvolve再破纪录:矩阵乘法指数40年最低!
DeepMind AlphaEvolve再破纪录:矩阵乘法指数40年最低!AlphaEvolve再次刷新记录!
来自主题: AI资讯
8964 点击 2026-09-01 14:43

 搜索
AlphaEvolve再次刷新记录!
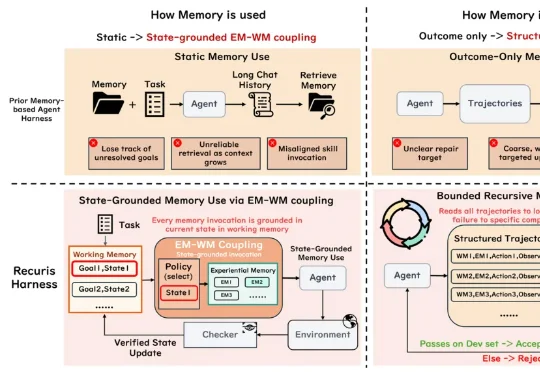
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
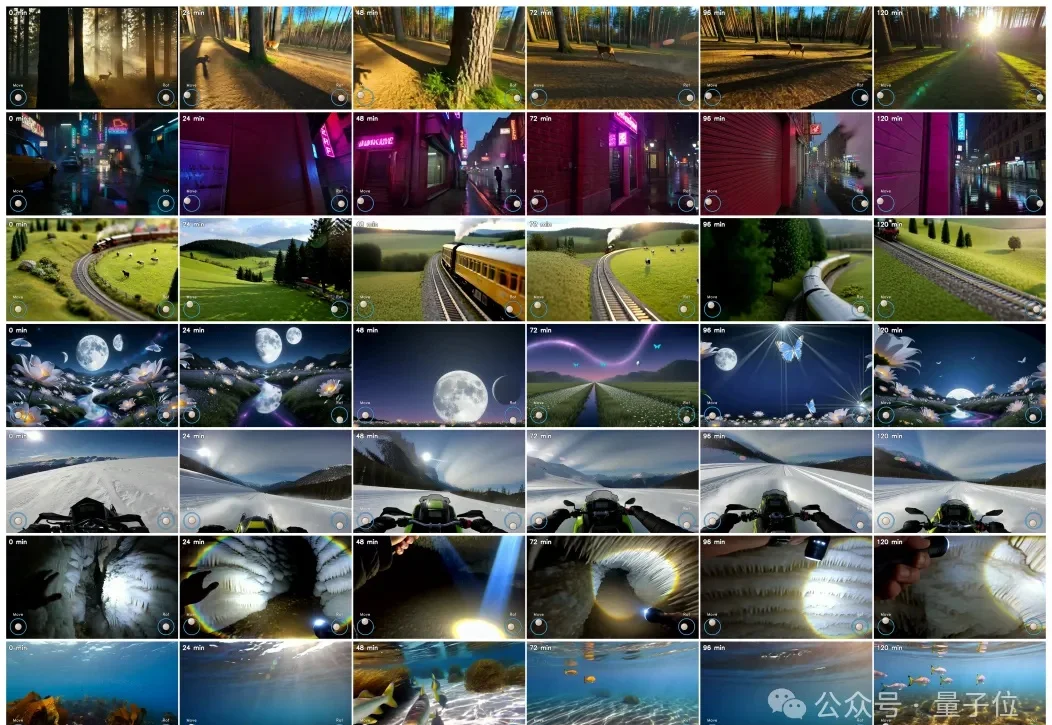
视频世界模型跑久了,往往面临三个问题: 画面发灰发糊或者过曝过饱和、场景悄悄换了地方、显存先撑不住。
过去几年,大模型的发展主线很清晰,比如更大的模型、更多的数据,以及更多的计算。但当模型从回答问题的Chatbot走向能够调用工具、执行任务的Agent,发展主线也开始发生变化。模型不仅要知道,还要在环境中行动,从反馈中判断结果,并在长时间运行中不断调整策略。
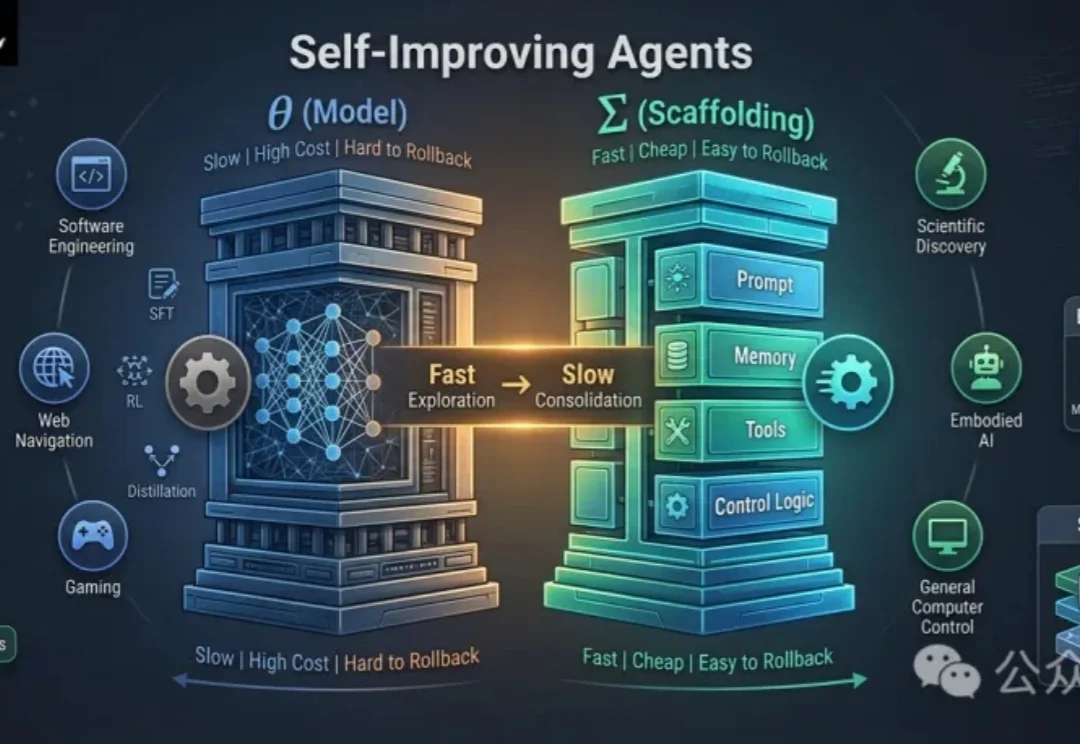
过去两年,self-reflection、self-correction、self-play、agentic RL、skill learning、test-time adaptation、open-ended evolution、self-evolving agent等概念不断涌现。
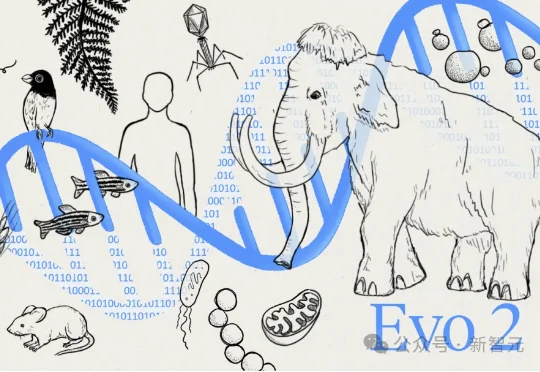
AI首次造出了,自然界不存在的病毒!消息一出,瞬间引爆全网。今天,一项来自斯坦福大学与Arc Institute的颠覆性研究,登上了顶刊Science。在这项实验中,AI一口气生成了70万个病毒基因组,其中精选了285条,进行了DNA人工合成。
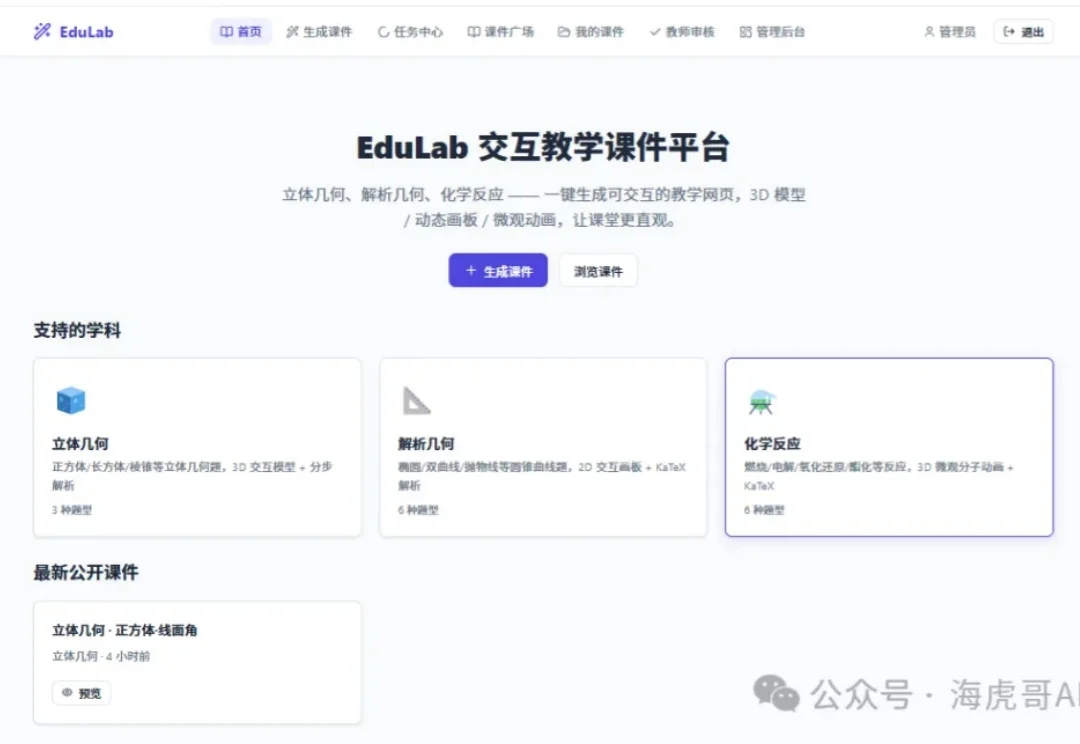
上一篇我用 Doubao-Seed-Evolving,把复杂 PRD 拆成可执行工程,做成了 AI 教学视频平台。那次重点是“知识驱动出片”:学科知识点 → 教学分镜 → 配音 → 动画 → 1080p 成片。
我们想强调的是:智能体 “跑得久”,并不等于 “具备长程能力”。真正的关键,不在于占用更多时间与算力,而在于能否在更长、更复杂、更真实的推理依赖链上持续、有效地行动。长期以来,Autonomous Agent、Self-Evolving Agent 等概念常与长程智能体混用。
Agent 执行任务的时候,会反复踩坑、不断试错,最后积累一些正确的经验。但这些经验通常只能停留在当前会话,或者当前 Agent 的记忆里,很难传给其他 AI。一个 Agent 调用某个 API,花了半个小时查文档、改参数,连续失败好几次,最后终于找到正确方法。
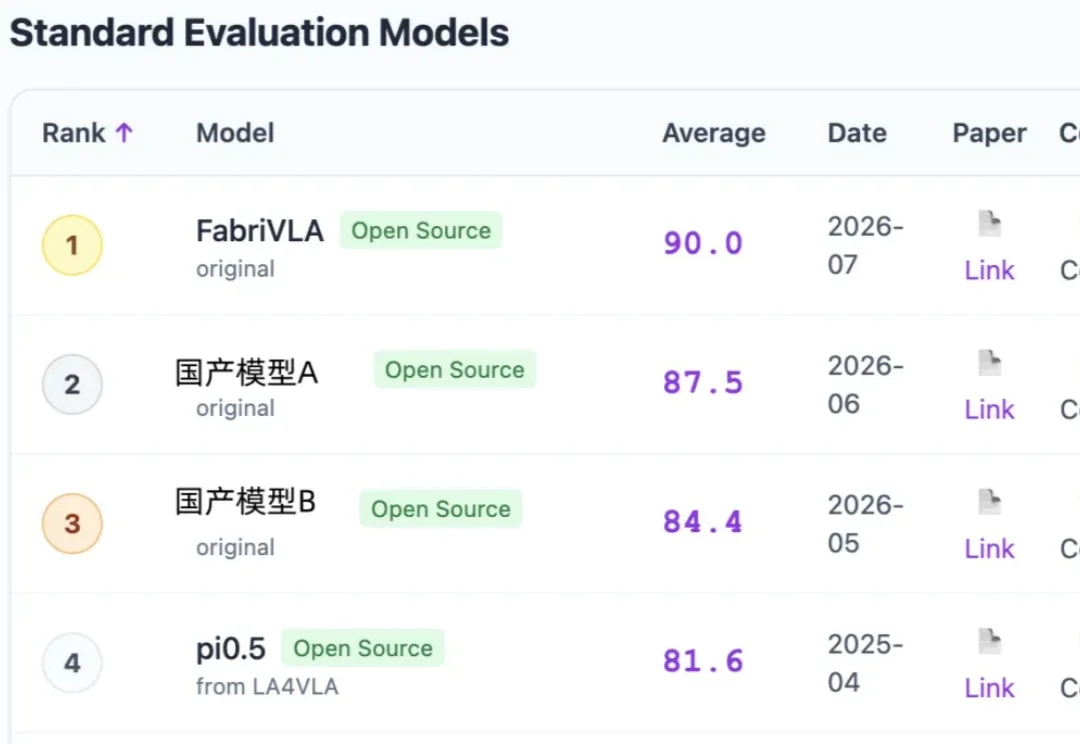
谁能想到,在全球具身智能操作能力的顶级榜单上,打败海外标杆模型π0的,居然是一个只有1B级参数的轻量级模型。