只用15%数据,多模态指令微调反超全量训练15.8%!
只用15%数据,多模态指令微调反超全量训练15.8%!来自上海交大、马来亚大学、CMU、MBZUAI、KIT和KAUST的团队提出VisNec(Visual Necessity Score,视觉必要性分数),用一个分数衡量每条训练样本里“图像到底起了多大作用”,被ECCV 2026收录。
来自主题: AI技术研报
8415 点击 2026-07-04 10:47

 搜索
来自上海交大、马来亚大学、CMU、MBZUAI、KIT和KAUST的团队提出VisNec(Visual Necessity Score,视觉必要性分数),用一个分数衡量每条训练样本里“图像到底起了多大作用”,被ECCV 2026收录。
依赖于有限机器人数据和大量人类数据,也能让 VLA 模型更稳健吗?
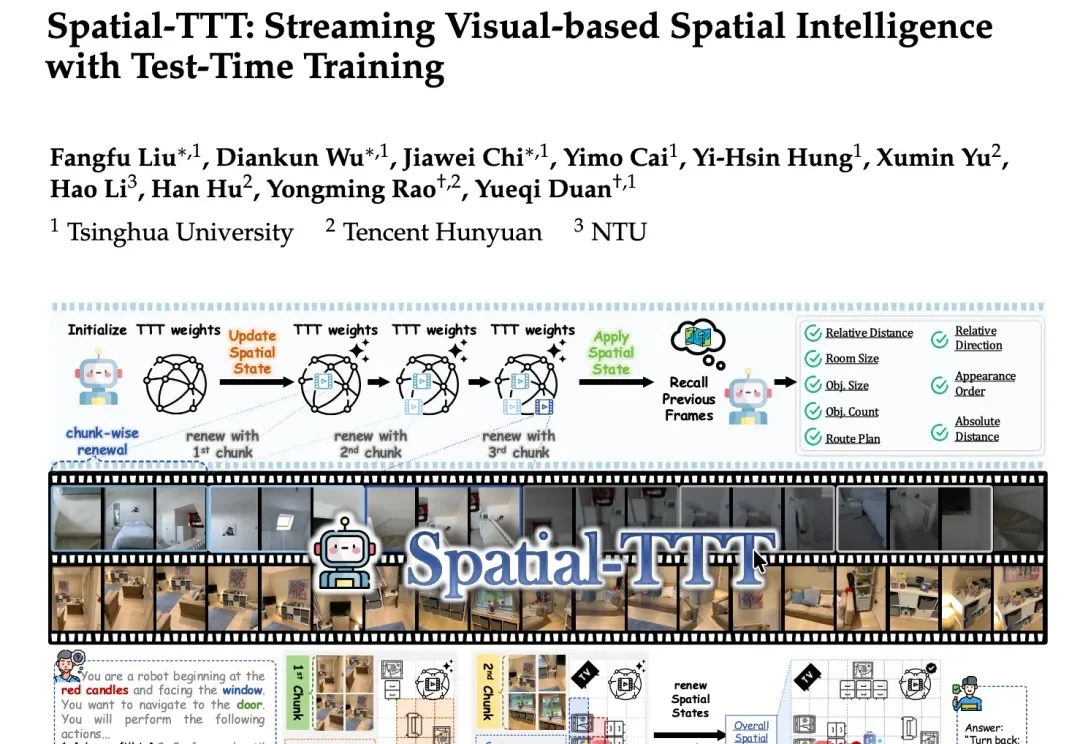
在机器人、自动驾驶、AR等真实场景中,空间理解从来都不是“看一眼图像”就能解决的问题。
王劲,香港大学计算机系二年级博士生,导师为罗平老师。研究兴趣包括多模态大模型训练与评测、伪造检测等,有多项工作发表于 ICML、CVPR、ICCV、ECCV 等国际学术会议。

SegVG是一种新的视觉定位方法,通过将边界框注释转化为像素级分割信号来增强模型的监督信号,同时利用三重对齐模块解决特征域差异问题,提升了定位准确性。实验结果显示,SegVG在多个标准数据集上超越了现有的最佳模型,证明了其在视觉定位任务中的有效性和实用性。
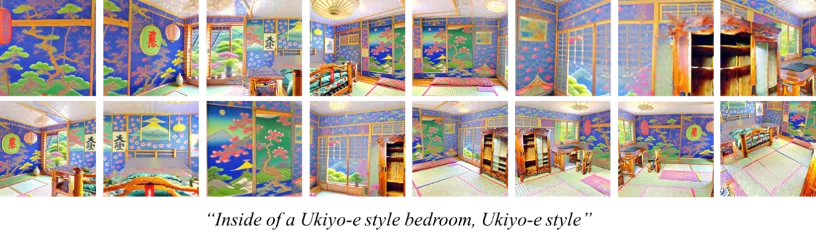
来自中国科学技术大学数据空间研究中心、香港科技大学、香港理工大学以及奥胡斯大学的研究者们提出一种新的场景生成方法 DreamScene,只需要提供场景的文本就可以生成高质量,视角一致和可编辑的 3D 场景。

chatGPT,AI,AI 3D,CE3D,扩散模型
全自动驾驶系统的纯视觉方案如特斯拉 “Tesla Vision”,仅依赖于摄像头收集的图像数据,旨在实现高效且成本效益高的自动驾驶技术。
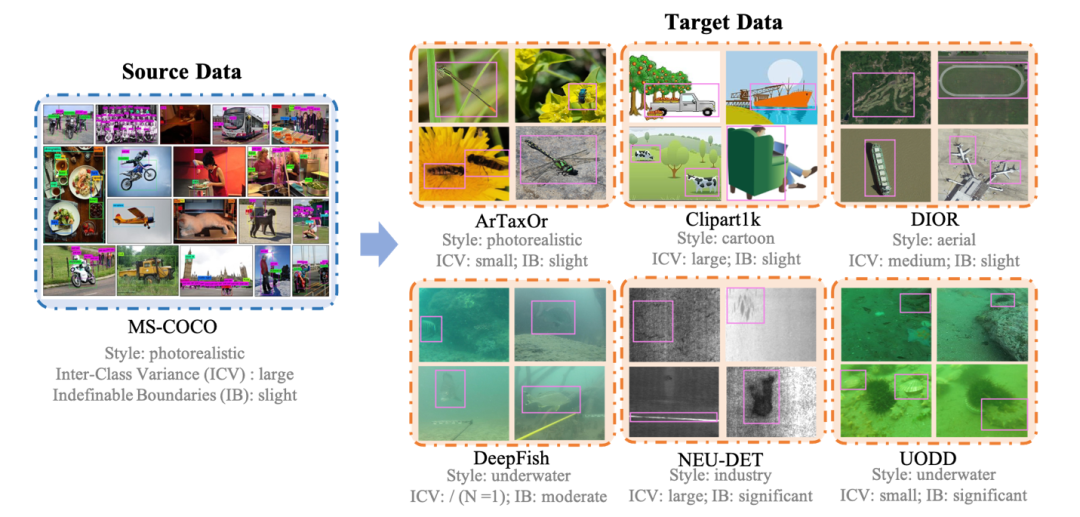
解决跨域小样本物体检测问题,入选ECCV 2024。
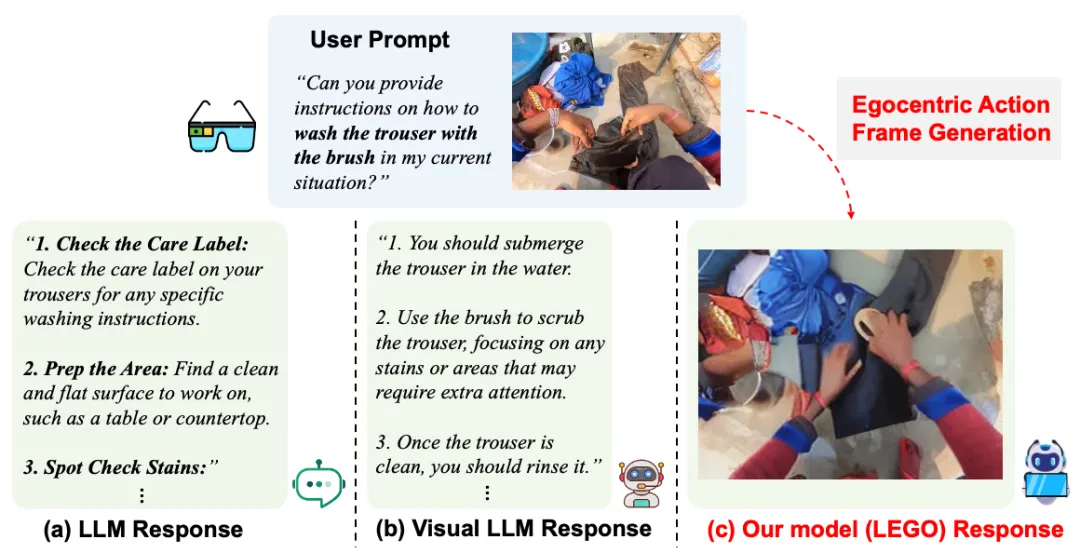
如何基于用户的问题和当前场景的照片,生成同一场景下的第一视角的动作图像,从而更准确地指导用户执行下一步行动?