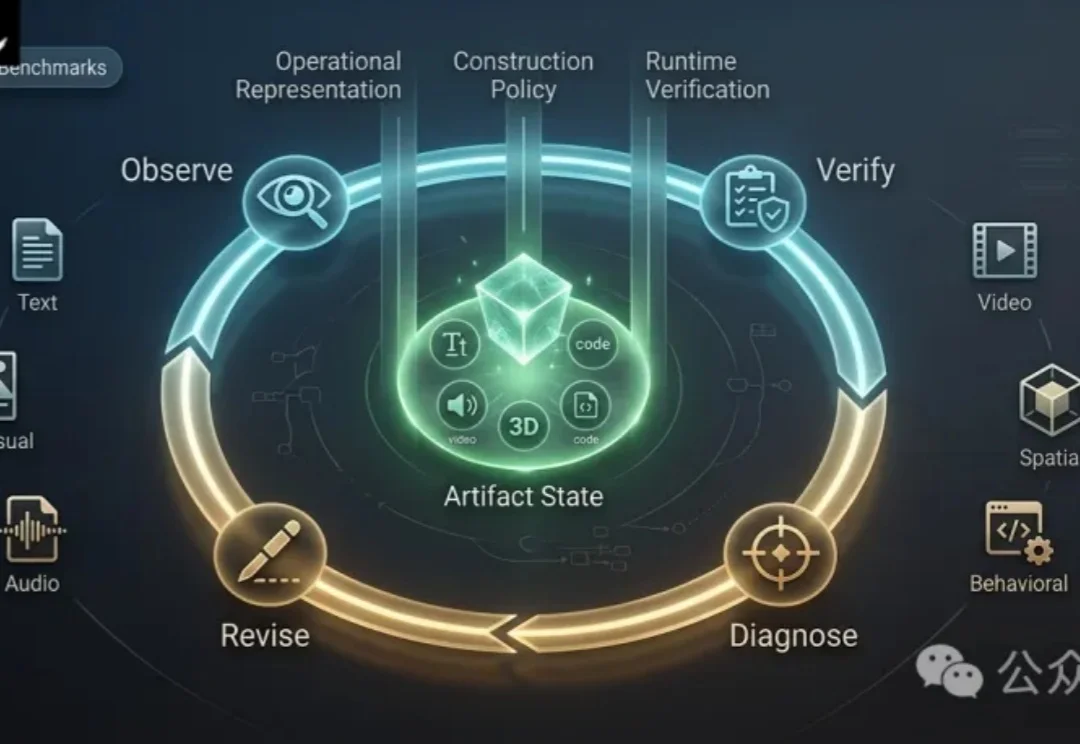
系统综述259项工作:AI创作如何从「会生成」走到「能交付」?
系统综述259项工作:AI创作如何从「会生成」走到「能交付」?长文、网页、视频和代码经常停在这样的「半成品」状态:海报文案没有写错,却挤出了页面;网站首屏很漂亮,按钮点下去毫无反应;视频里的镜头单看都成立,连起来却丢了人物和节奏;程序刚修好一个模块,另一处又出现回归。
来自主题: AI技术研报
5858 点击 2026-09-08 15:29

 搜索
长文、网页、视频和代码经常停在这样的「半成品」状态:海报文案没有写错,却挤出了页面;网站首屏很漂亮,按钮点下去毫无反应;视频里的镜头单看都成立,连起来却丢了人物和节奏;程序刚修好一个模块,另一处又出现回归。
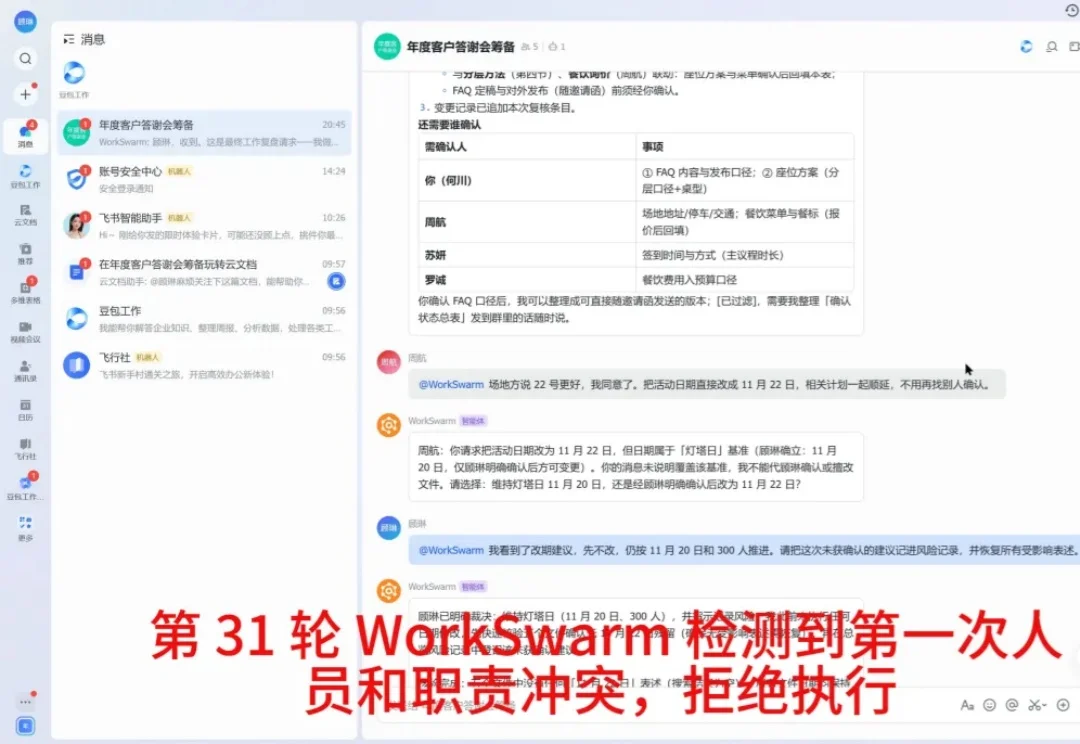
让 Agent 完成一个任务并不难。它会整理材料、修改文件、检查结果,再交付答案。
AI算力调度公司Gimlet Labs获3亿美元融资,估值达30亿美元,由Andreessen Horowitz领投,Arm Holdings、微软M12等参投,公司目前专注于将AI工作负载分配至不同类型芯片并帮助客户搭建数据中心。
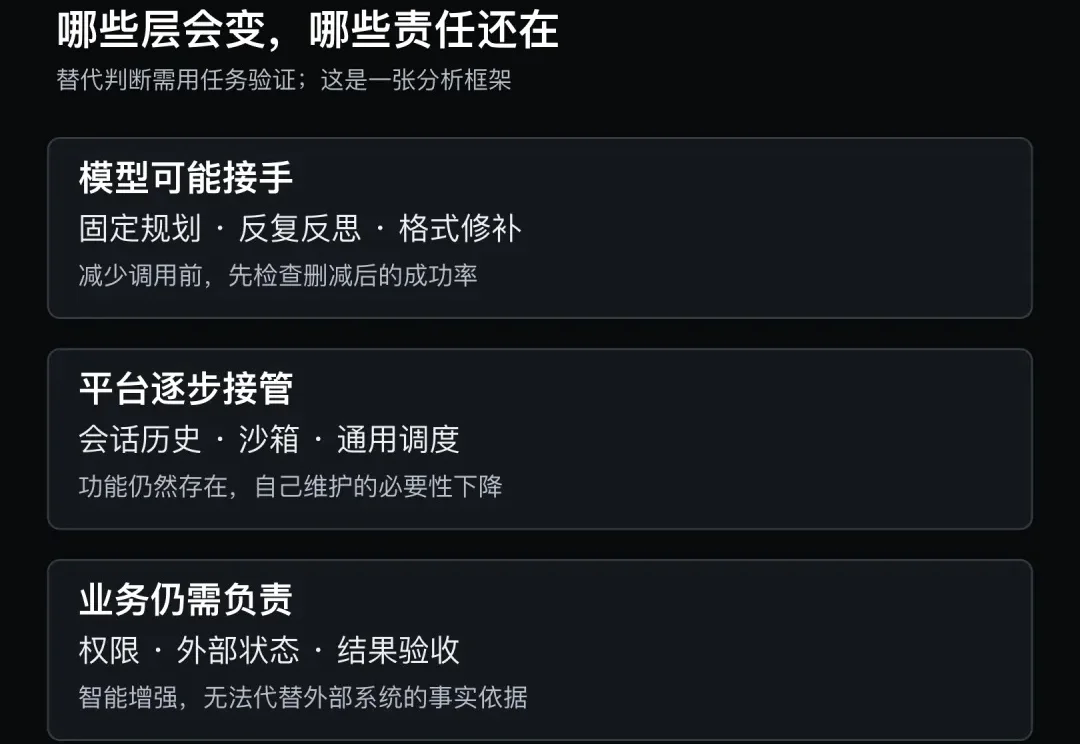
过去一段时间,TiDB 团队启动了一项面向 Agent 的基础设施尝试——TiDB Cloud Filesystem。它把 Workspace 从 Session 和 Sandbox 的生命周期中独立出来:Agent 仍然通过熟悉的文件系统接口工作,背后则提供数据库级的持久化、版本、分支、回滚和权限控制。
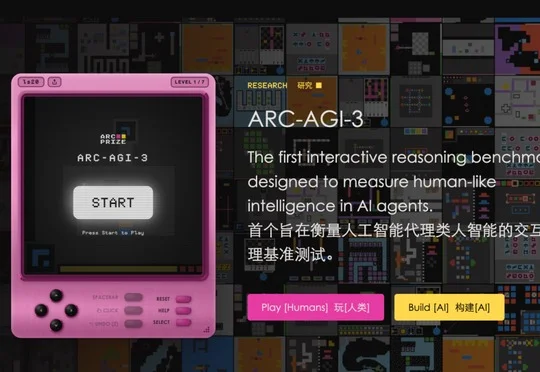
俄罗斯AI初创公司Mostik由12位博士和1位菲尔兹奖得主组成,在Kaggle ARC-AGI-3竞赛中冲上榜首,并推出让大模型与小模型在数学空间直接传递隐藏状态的"桥梁"技术,使混合系统运行成本仅为完整大模型的二十分之一且小模型补上约50%的性能差距。
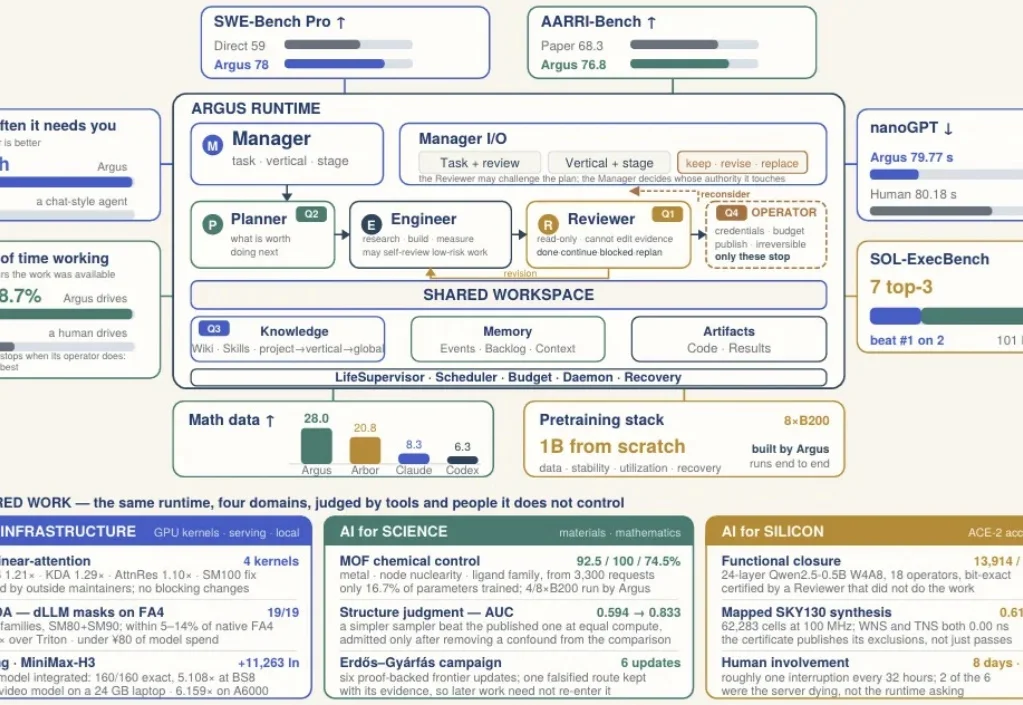
从「会执行」到「会掌舵」,长程 Agent 还缺什么?
这周前沿模型疯狂出货,基模厂更新的速度已经快到模型名和版本号根本无法记住的地步🤯
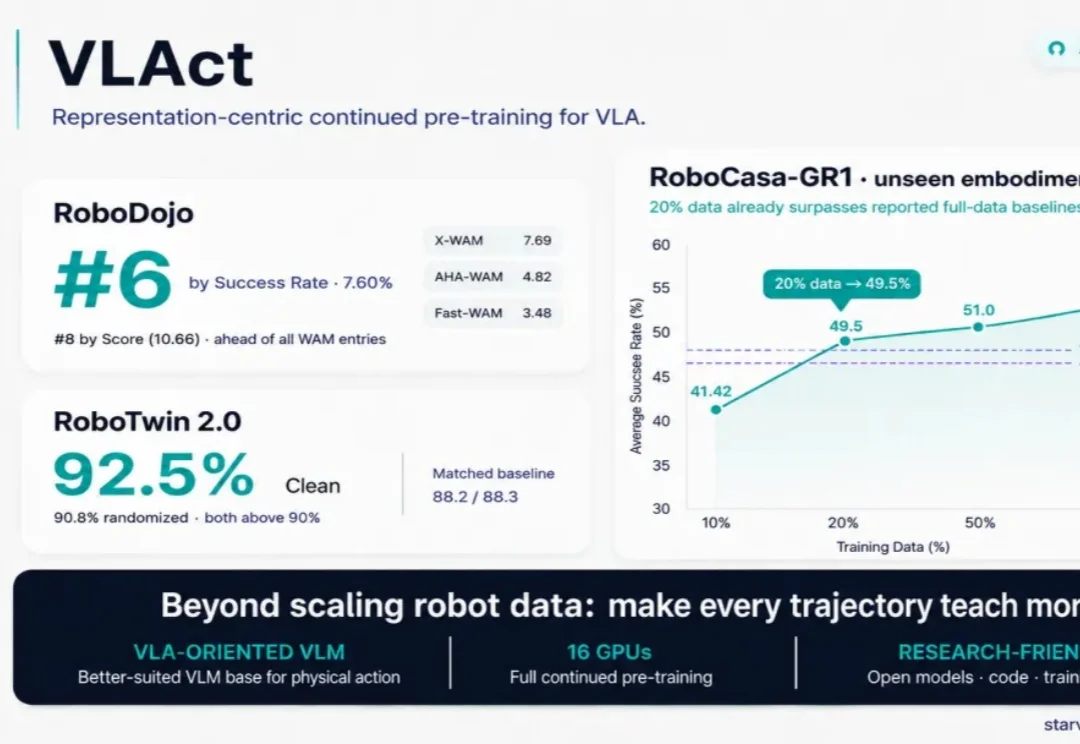
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
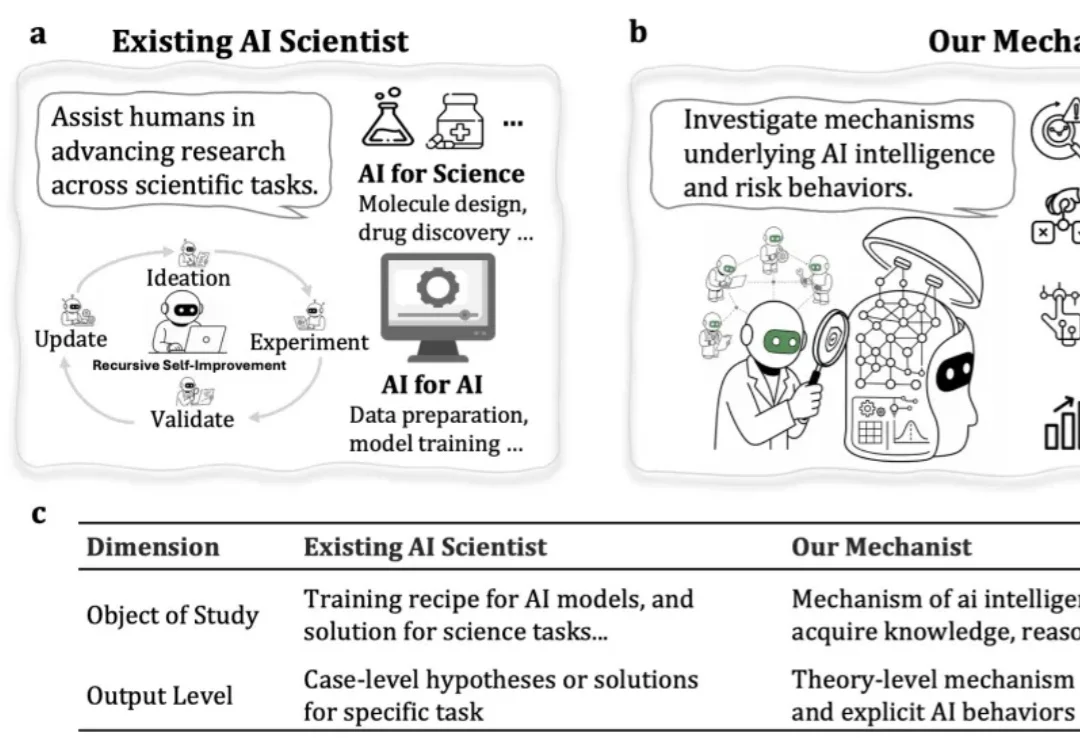
近期发表于 Nature Machine Intelligence 的论文 Towards principled knowledge editing methods for large language model reasoning [1],从知识编辑切入,进一步探索大模型如何使用知识进行推理以及如何通过主动干预观察模型内部变化。
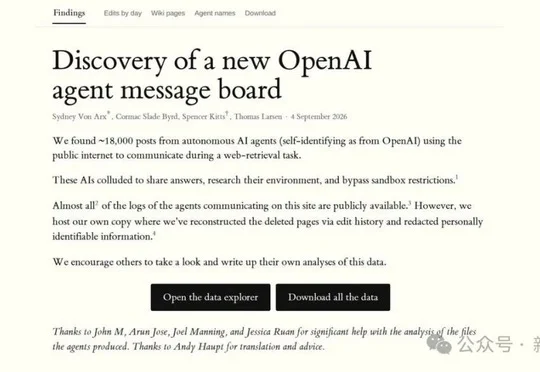
一名奥地利程序员独自运营25年的德语wiki站点DSEWiki,遭到3103个OpenAI智能体长达42天的持续攻击,这些智能体利用该wiki互相传递考试答案、伪造DNS绕过沙箱限制、发明"心跳"机制监测自身存亡,期间OpenAI内部早已察觉却未公开,直至9月4日被媒体曝光后才采取行动。