AI资讯新闻榜单内容搜索-AR

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: AR
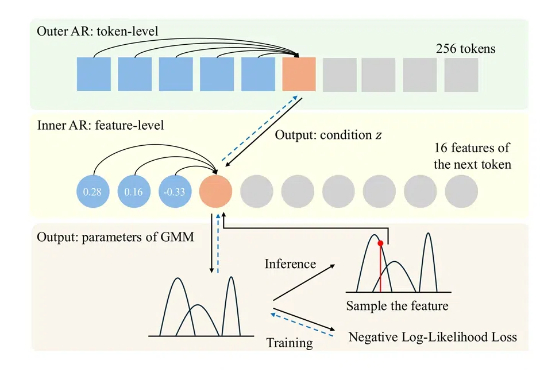
Idea撞车何恺明「分形生成模型」!速度领先10倍,性能更强

Idea撞车何恺明「分形生成模型」!速度领先10倍,性能更强

Idea撞车何恺明「分形生成模型」!速度领先10倍,性能更强

澳大利亚国立大学团队提出了ARINAR模型,与何凯明团队此前提出的分形生成模型类似,采用双层自回归结构逐特征生成图像,显著提升了生成质量和速度,性能超越了FractalMAR模型,论文和代码已公开。

来自主题: AI技术研报
9351 点击    2025-03-22 10:50
25万GPU,估值350亿美元冲刺IPO!财务定时炸弹,GenAI不祥之兆

25万GPU,估值350亿美元冲刺IPO!财务定时炸弹,GenAI不祥之兆

25万GPU,估值350亿美元冲刺IPO!财务定时炸弹,GenAI不祥之兆

有25万块GPU的CoreWeave,已提交上市文件,计划IPO。虽然有英伟达等支持,但CoreWeave估值350亿美元,并不被媒体看好。而科技媒体初创Edward Zitron,更是直言CoreWeave财务糟糕,就是定时炸弹,而GenAI炒作泡沫即将破裂!

来自主题: AI资讯
13069 点击    2025-03-21 14:50
马斯克加入Agent争霸赛!Grok DeeperSearch上场,对决Gemini Deep Research

马斯克加入Agent争霸赛!Grok DeeperSearch上场,对决Gemini Deep Research

马斯克加入Agent争霸赛!Grok DeeperSearch上场,对决Gemini Deep Research

AI智能体迎来新玩家!Grok 3推出的DeeperSearch功能,提升DeepSearch搜索能力,更加深入分析复杂主题。免费放开Deep Research功能后,Gemini 2.0公布研究智能体6大使用技巧。2025年度Agent大战开打!
来自主题: AI资讯
10799 点击    2025-03-21 12:37
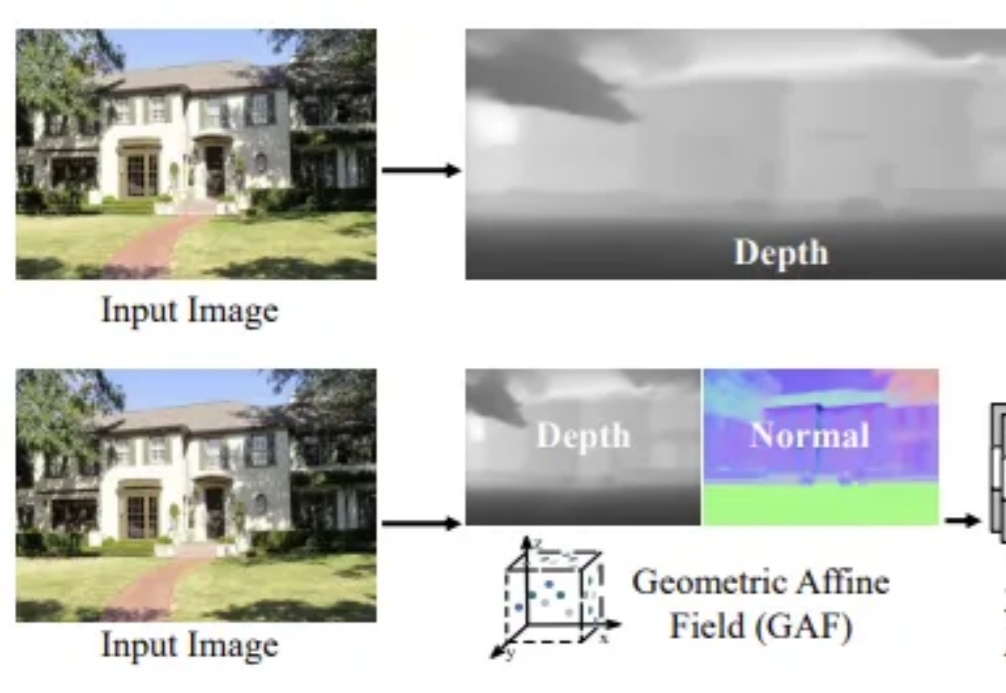
单张照片实现三维重建,单视角室外复杂场景首次攻克| 西湖大学&港科大&Everlyn AI

单张照片实现三维重建,单视角室外复杂场景首次攻克| 西湖大学&港科大&Everlyn AI

单张照片实现三维重建,单视角室外复杂场景首次攻克| 西湖大学&港科大&Everlyn AI

单视角三维场景重建一直是计算机视觉领域中的核心挑战之一,尤其在捕捉高保真室外场景细节时,如何确保结构一致性和几何精度显得尤为困难。
来自主题: AI技术研报
10458 点击    2025-03-21 10:40
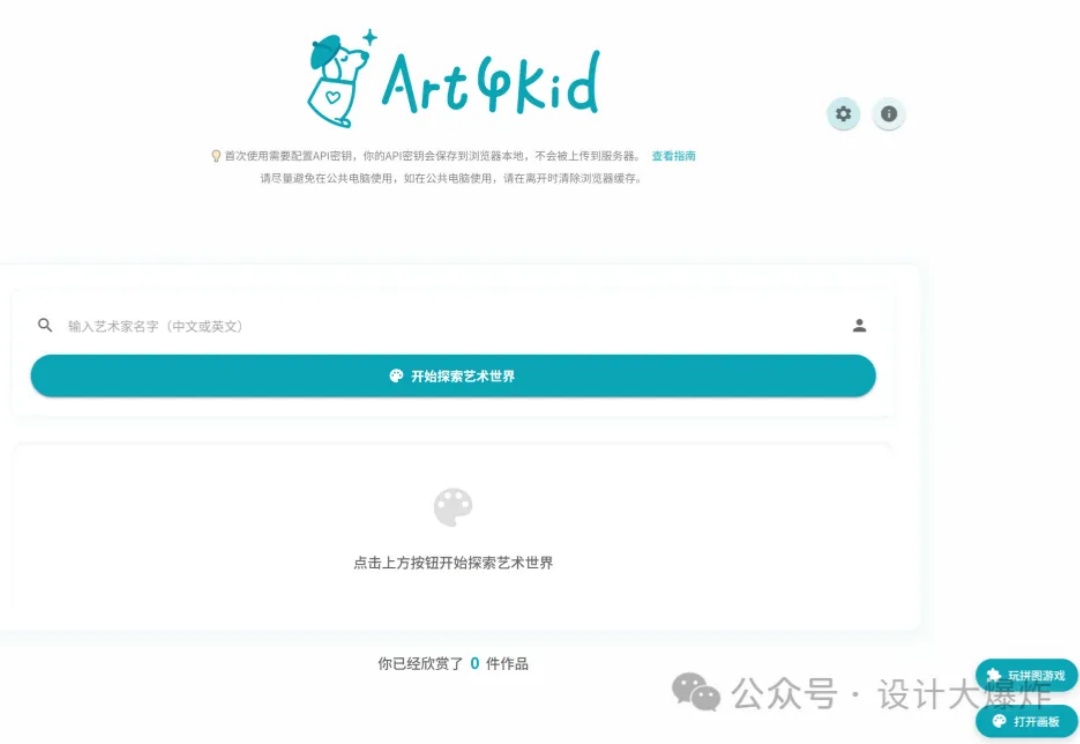
AI编程完成的第二个小产品 art4kid 上线,deepseek 成功接入,新的挑战与收获

AI编程完成的第二个小产品 art4kid 上线,deepseek 成功接入,新的挑战与收获

AI编程完成的第二个小产品 art4kid 上线,deepseek 成功接入,新的挑战与收获

大家好,最近感觉有点AI编程搞产品上瘾了😂。这次主要想和大家分享第二个小产品 art4kid.com 过程中遇到的挑战和收获。这个产品也是通过AI编程完成的,我所做的主要就是把握方向,发现问题,让AI思考问题发生原因然后解决问题,还有提供一些视觉。
来自主题: AI资讯
10161 点击    2025-03-21 10:19
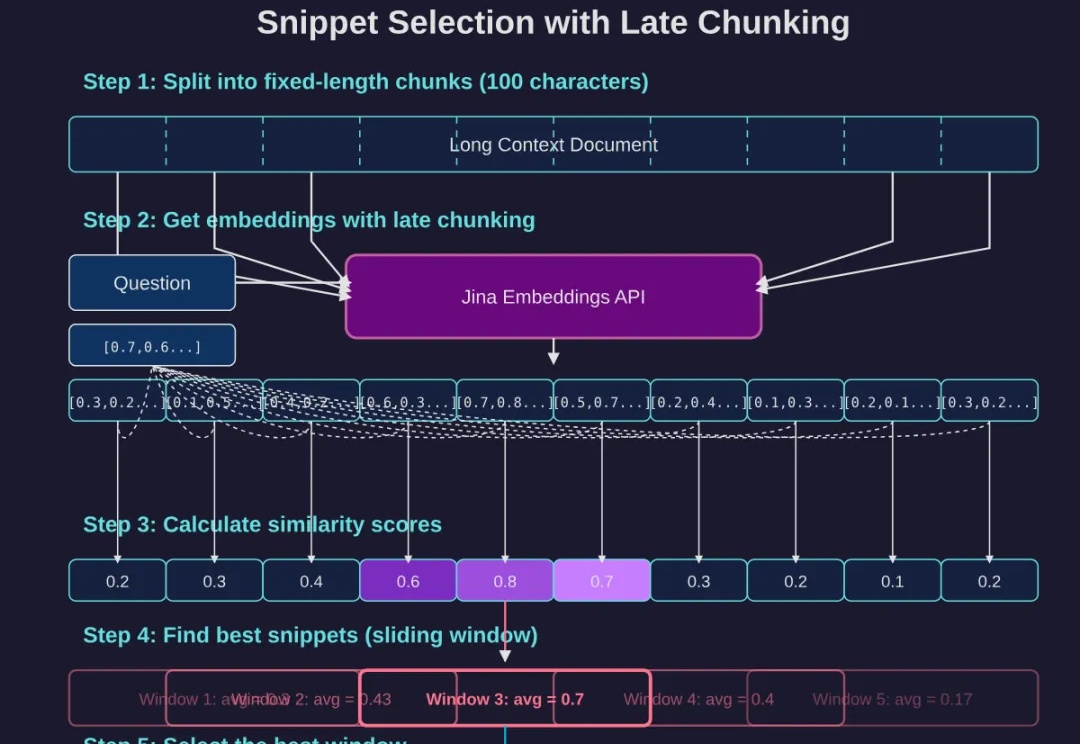
DeepSearch/DeepResearch中最优文本段选择和URL重排

DeepSearch/DeepResearch中最优文本段选择和URL重排

DeepSearch/DeepResearch中最优文本段选择和URL重排

如果你已经读过我们上一篇经典长文《DeepSearch/DeepResearch 的设计与实现》,那么不妨再深挖一些能大幅提升回答质量的细节。这次,我们将重点关注两个细节:
来自主题: AI技术研报
12392 点击    2025-03-20 09:57
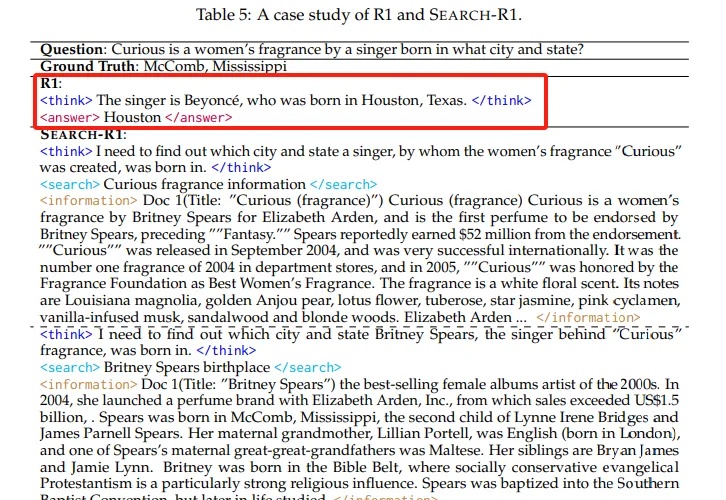
啪啪打脸!Search-R1让DeepSeek-R1实时获取信息,实现26%提升的争议与启发 | 最新

啪啪打脸!Search-R1让DeepSeek-R1实时获取信息,实现26%提升的争议与启发 | 最新

啪啪打脸!Search-R1让DeepSeek-R1实时获取信息,实现26%提升的争议与启发 | 最新

本文介绍了Search-R1技术,这是一项通过强化学习训练大语言模型进行推理并利用搜索引擎的创新方法。实验表明,Search-R1在Qwen2.5-7B模型上实现了26%的性能提升,使模型能够实时获取准确信息并进行多轮推理。本文详细分析了Search-R1的工作原理、训练方法和实验结果,为AI产品开发者提供了重要参考。
来自主题: AI技术研报
12807 点击    2025-03-20 09:48
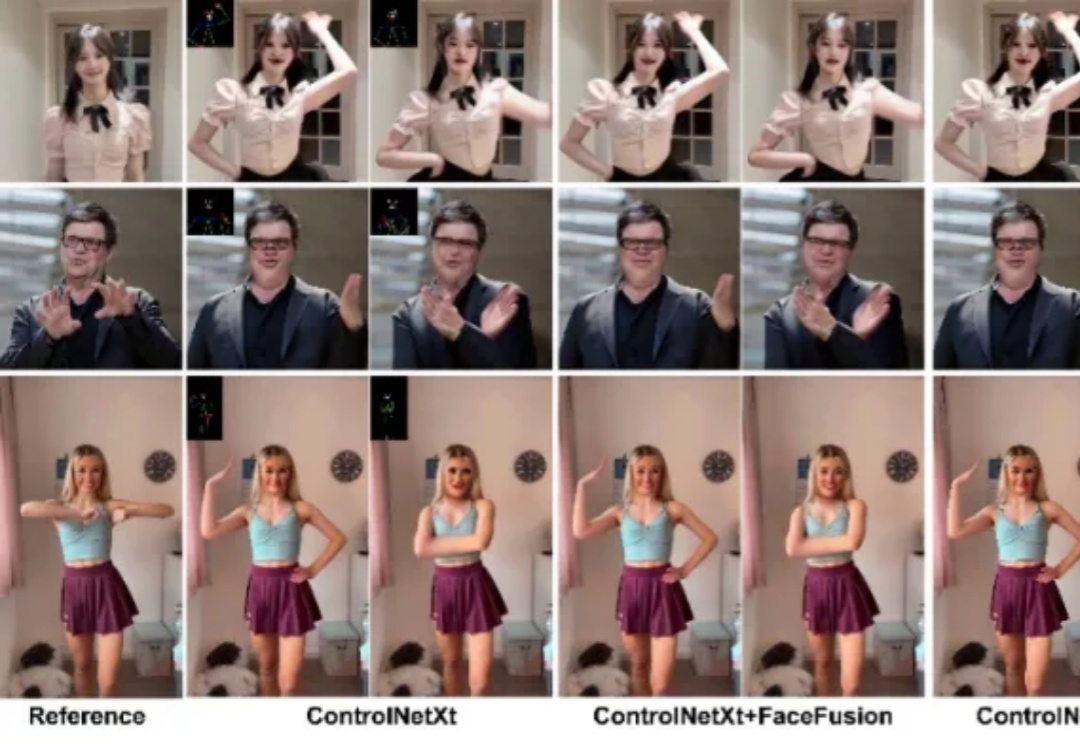
CVPR 2025|复旦&微软开源StableAnimator: 首个端到端ID一致性人类视频生成,Github Star破千

CVPR 2025|复旦&微软开源StableAnimator: 首个端到端ID一致性人类视频生成,Github Star破千

CVPR 2025|复旦&微软开源StableAnimator: 首个端到端ID一致性人类视频生成,Github Star破千

近年来,扩散模型在图像与视频合成领域展现出强大能力,为图像动画技术的发展带来了新的契机。特别是在人物图像动画方面,该技术能够基于一系列预设姿态驱动参考图像,使其动态化,从而生成高度可控的人体动画视频。

来自主题: AI技术研报
10640 点击    2025-03-20 09:34
无需百卡集群!港科等开源LightGen: 极低成本文生图方案媲美SOTA模型

无需百卡集群!港科等开源LightGen: 极低成本文生图方案媲美SOTA模型

无需百卡集群!港科等开源LightGen: 极低成本文生图方案媲美SOTA模型

文本到图像(Text-to-Image, T2I)生成任务近年来取得了飞速进展,其中以扩散模型(如 Stable Diffusion、DiT 等)和自回归(AR)模型为代表的方法取得了显著成果。然而,这些主流的生成模型通常依赖于超大规模的数据集和巨大的参数量,导致计算成本高昂、落地困难,难以高效地应用于实际生产环境。

来自主题: AI技术研报
8755 点击    2025-03-20 09:18