30B大模型跑进手机,推理引擎开始自我进化
30B大模型跑进手机,推理引擎开始自我进化无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
来自主题: AI资讯
8312 点击 2026-10-24 13:43

 搜索
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
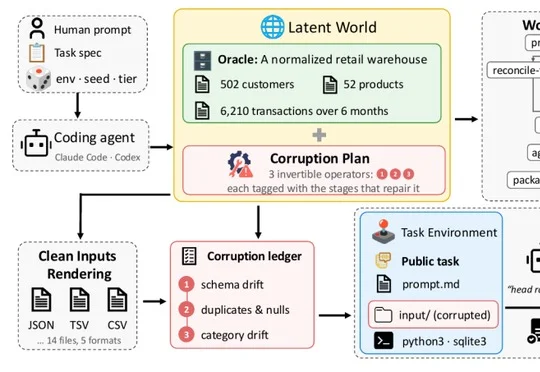
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。
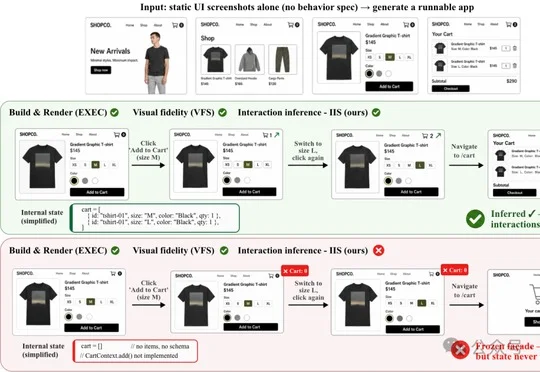
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
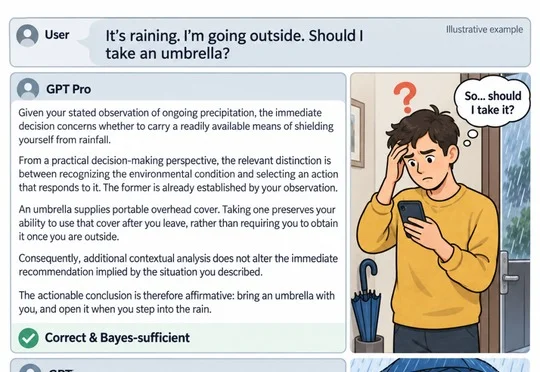
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
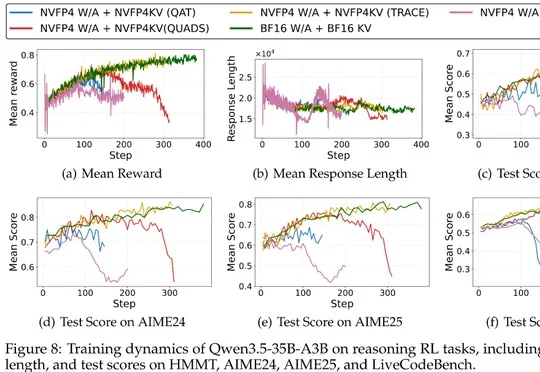
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
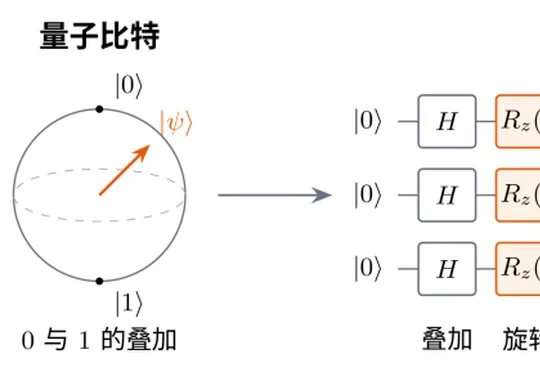
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
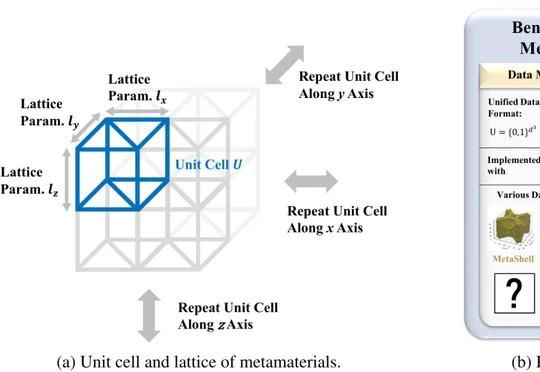
弗吉尼亚理工大学与Meta团队提出ReGDiff,通过RAS整理潜空间并用SRR短程排斥引导扩散采样,在MetaTruss和MetaShell上较最强基线平均提升几何合理性8.9%、新颖性46.4%和多样性128.6%。
国务院办公厅印发《关于适应人工智能技术发展助力构建就业友好型发展方式的意见》,从6个方面部署18项任务,提出拓展人工智能就业空间、减缓就业替代影响并健全风险评估和劳动者权益保障。
上海交大00后团队创办的芯生代完成数千万元种子轮融资,计划让Agent为不同模型、芯片和场景生成可自我迭代的定制推理引擎,其EvoKernel框架已将昇腾算子生成正确率从4%提升至83%。
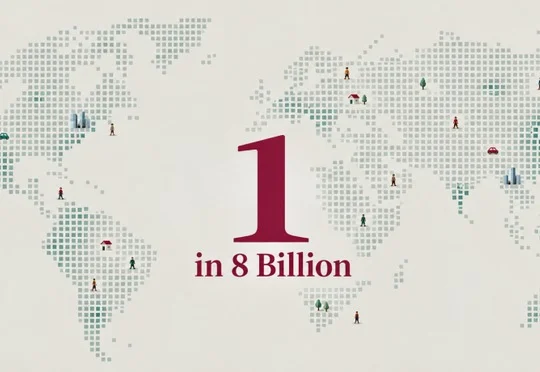
独立开发者借助Claude约4小时做出网页游戏1 in 8 Billion,支持按172个国家和地区的统计数据随机投胎并模拟一生,随后在韩国和日本社交平台传播。