全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低
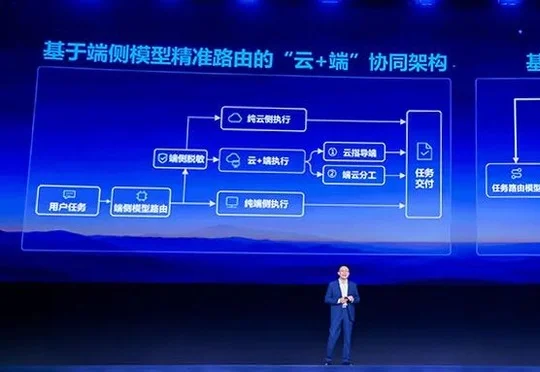
全国产芯片训练的大模型来了!百万上下文,价格比DeepSeek V4.1 Flash更低科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
搜索
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
独立开发者借助Claude约4小时做出网页游戏1 in 8 Billion,支持按172个国家和地区的统计数据随机投胎并模拟一生,随后在韩国和日本社交平台传播。
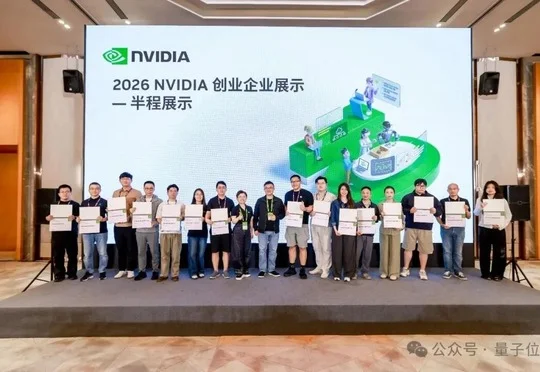
达瓦科技凭借实时世界模型产品Scenes AI拿下NVIDIA半程展示卓越企业奖,其34B模型在单张NVIDIA GeForce RTX消费级显卡上实现720P、25帧实时输出。
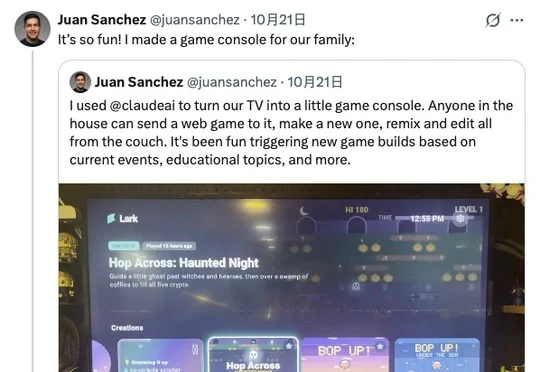
用户借助 Claude Code 制作开源项目 TV Detox,在逐项确认后关闭 Android 电视广告和预装应用;OpenAI 评测显示 GPT-6.1 Sol 迁移 COBOL 的隐藏测试准确率最高达 97.9%,但真实银行系统仍需专家审查。
这一周的AI视频圈,简直是神仙打架。
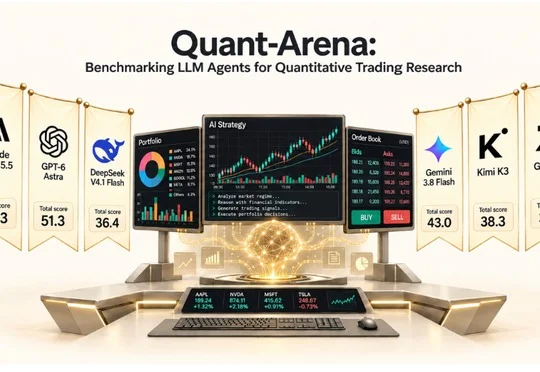
EinsiaAI旗下Navers Lab发布Quant Arena,将6家厂商的9个模型置于A股历史数据中评测,4个代表策略盈利、5个亏损,最佳GPT-6 Astra年化收益10.7%仍低于17.1%的市场基准。
美团AI也在加码中。
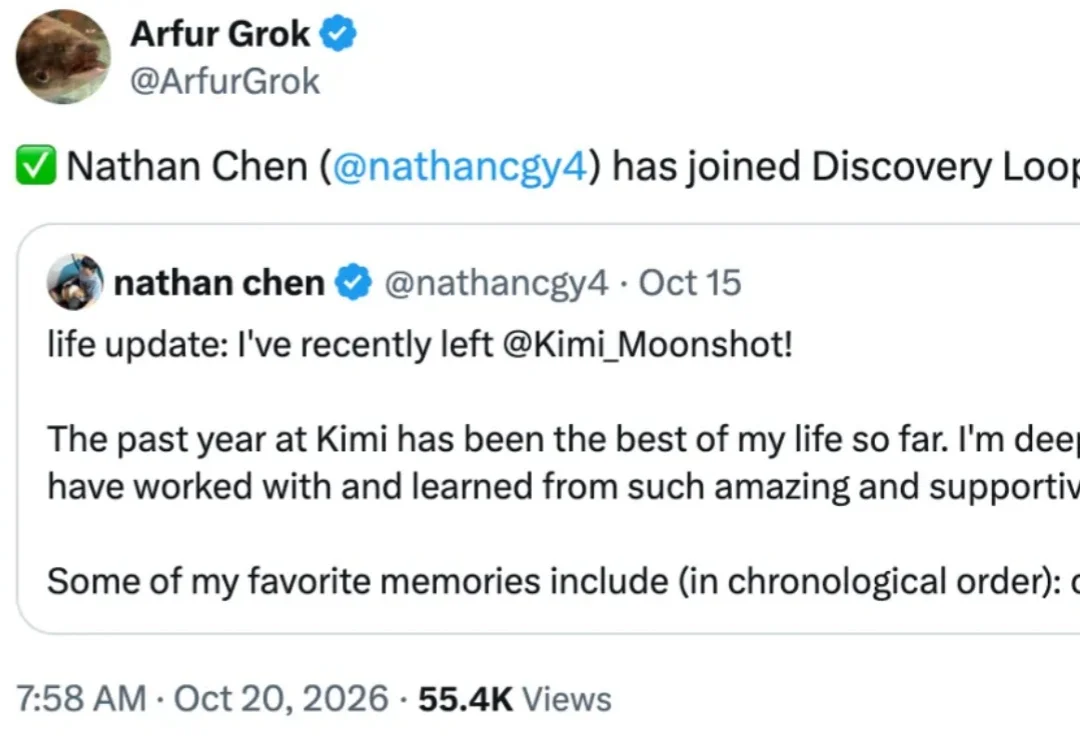
据机器之心了解,17 岁 AI 研究者陈广宇,已经加入 Jeff Dean 等人创立的 Discovery Loop 团队。
7个月融资超13亿元。
万亿美元AI大饼,烙到一半卡住了。