
小众架构赢麻了!通过编辑功能 LLaDA2.1 让100B扩散模型飙出892 tokens/秒的速度!
小众架构赢麻了!通过编辑功能 LLaDA2.1 让100B扩散模型飙出892 tokens/秒的速度!谁能想到啊,在自回归模型(Autoregressive,AR)当道的现在,一个非主流架构的模型突然杀了回马枪——被长期视为学术玩具的扩散语言模型,直接在复杂编程任务中飙出了892 tokens/秒的速度!
来自主题: AI资讯
11699 点击 2026-02-11 10:47

 搜索
谁能想到啊,在自回归模型(Autoregressive,AR)当道的现在,一个非主流架构的模型突然杀了回马枪——被长期视为学术玩具的扩散语言模型,直接在复杂编程任务中飙出了892 tokens/秒的速度!
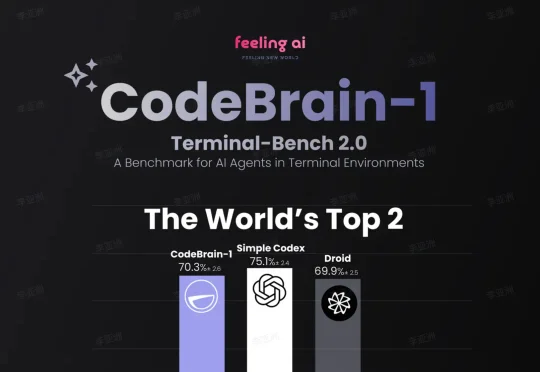
就在这个被 Anthropic 和 OpenAI 视为衡量 Agent 真实工程能力全球权威基准 Terminal-Bench 2.0 榜单上,中国团队 Feeling AI 凭借 CodeBrain-1,搭载最新 GPT-5.3-Codex 底座模型,一举冲到 72.9%(70.3%) 并跻身全球排行榜第二,成为榜单前 10 中唯一的中国团队。
今天,阿里巴巴发布了新一代图像生成基础模型Qwen-Image 2.0,这一模型支持长达一千个token的超长指令、2k分辨率,并采用了更轻量的模型架构,模型尺寸远小于Qwen-Image 2.0的20B,带来更快的推理速度。
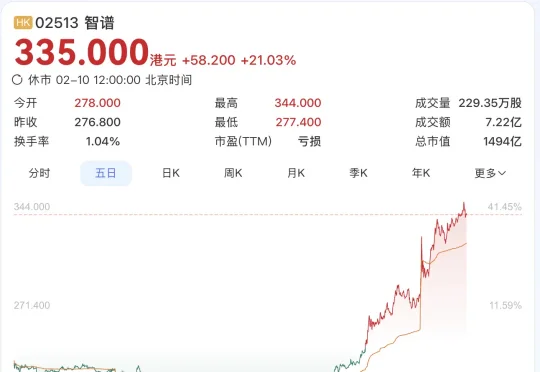
不管Pony Alpha是不是智谱的,下一代旗舰大模型GLM-5都要来了。GLM-5采用了DeepSeek-V3/V3.2架构,包括稀疏注意力机制(DSA)和多Token预测(MTP),总参数量745B,是上一代GLM-4.7的2倍。
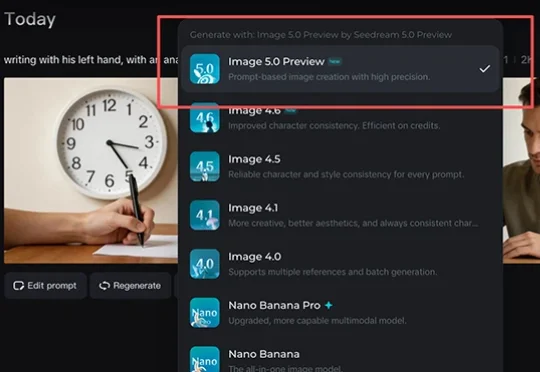
新模型对标Nano Banana Pro,能免费体验。Seedance 2.0的热度还没下去,字节新模型又来了!今日,字节图像生成模型Seedream 5.0 Preview在视频编辑应用剪映、剪映海外版Capcut、字节AI创作平台小云雀均已上线,在即梦AI平台开启灰度测试,图片生成可限时免费体验。
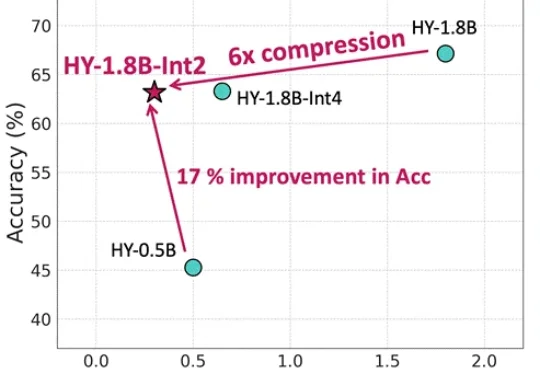
等效参数量仅0.3B,内存占用仅600MB,更适合端侧部署还带思维链的模型来了。腾讯混元最新推出面向消费级硬件场景的“极小”模型HY-1.8B-2Bit,体量甚至比常用的一些手机应用还小。
这两天,AI 视频圈被偷摸摸上线的 Seedance 2.0 刷屏了。在 AI 视频领域颇有影响力的博主海辛,在即刻分享了自己对它的观点:「Seedance 2.0 是我 26 年来最大的震撼」、「我觉得它碾压 Sora2」。
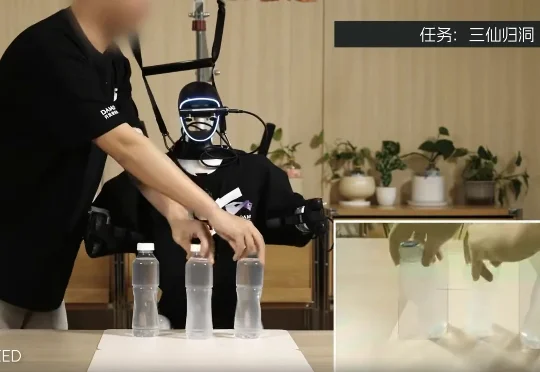
2026 年,那么多机器人上春晚,能给大家表演个包饺子吗?相信这是很多人会好奇的一个问题。
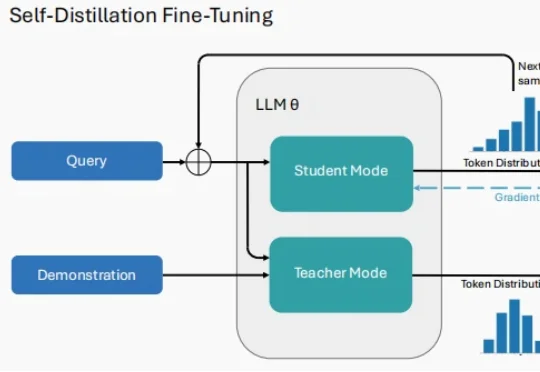
2026 年刚拉开序幕,大模型(LLM)领域的研究者们似乎达成了一种默契。 当你翻开最近 arXiv 上最受关注的几篇论文,会发现一个高频出现的词汇:Self-Distillation。
去年11月,奥地利独立开发者Peter Steinberger花了一个小时,把Claude的API接上WhatsApp,做了一个能通过聊天软件操控电脑的AI助手。他当时觉得这个想法太明显了,大公司肯定会做,就没当回事。大公司没有做。今年1月25日,他把这个项目放上GitHub,一天拿到9000颗星。两周后的今天,这个叫OpenClaw的开源项目已经突破17万星。