走在GPT 4.5前面?3D、视频直接扔进对话框,大模型掌握跨模态推理
走在GPT 4.5前面?3D、视频直接扔进对话框,大模型掌握跨模态推理最近,有人在社交媒体上发布了一张有关 GPT4.5 更新的截图。图中内容显示,和 GPT 系列之前推出的模型相比,GPT4.5 最大的惊喜可能就是处理 3D 和视频的能力。至于 3D 能力到底是指看得懂 3D 图像,还是能输入 3D 模型,目前只能靠猜。
来自主题: AI技术研报
7306 点击 2023-12-17 19:41

 搜索
最近,有人在社交媒体上发布了一张有关 GPT4.5 更新的截图。图中内容显示,和 GPT 系列之前推出的模型相比,GPT4.5 最大的惊喜可能就是处理 3D 和视频的能力。至于 3D 能力到底是指看得懂 3D 图像,还是能输入 3D 模型,目前只能靠猜。
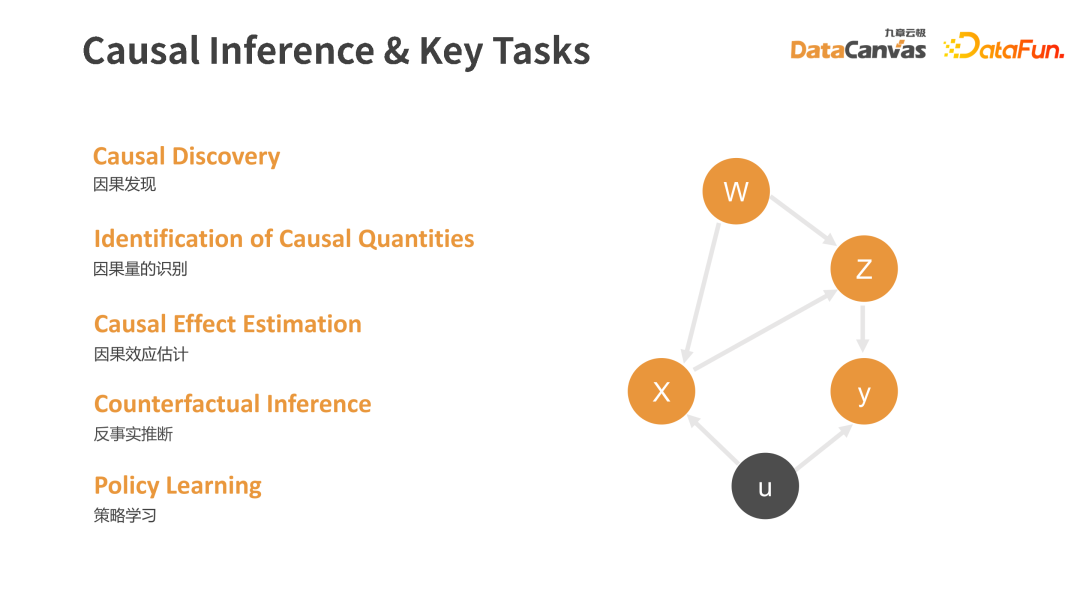
在数字化建设不断推进的今天,随着技术的不断发展,从统计学、机器学习、深度学习,再到因果学习以及最新的热门大模型方向,九章云极 DataCanvas 始终紧贴最前沿的、最能助力企业和落地实践的方向,不断进行着面向决策和面向智能的探索。本文将分享大模型时代下的因果推断。

小模型的风潮,最近愈来愈盛,Mistral和微软分别有所动作。而网友实测发现,Mistral-medium的代码能力竟然完胜了GPT-4,而所花成本还不到三分之一。
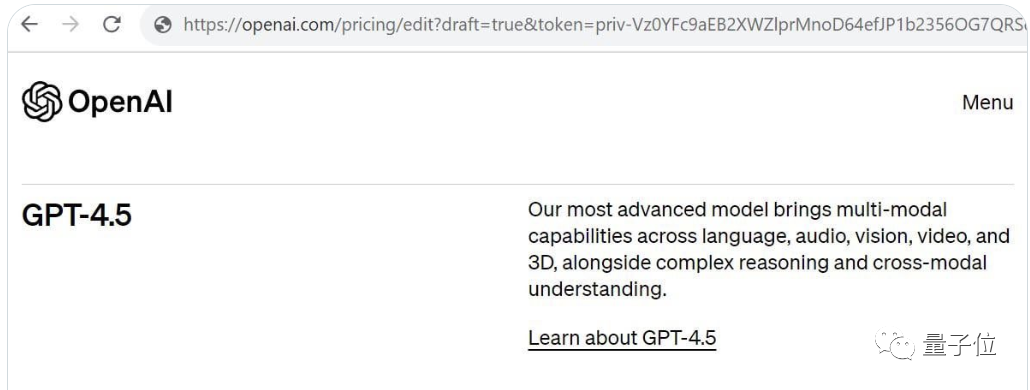
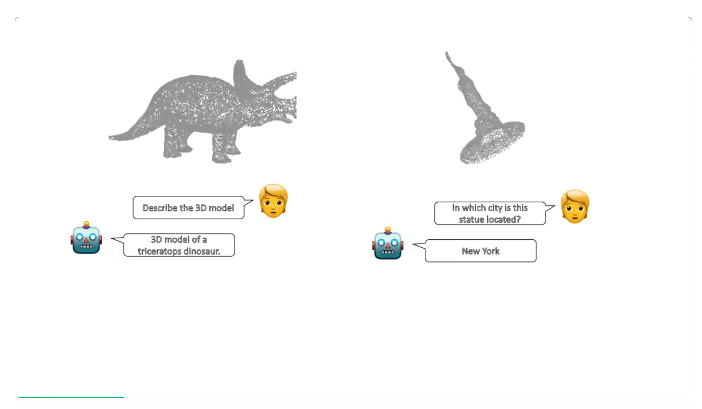
GPT 4.5疑似大泄漏: 一个是新模型将具备全新多模态能力,文本语音图片以及视频和3D信息全都能一并处理,并且还可以跨模态理解。
在 3D 生成领域,根据文本提示创建高质量的 3D 人体外观和几何形状对虚拟试穿、沉浸式远程呈现等应用有深远的意义。

日前,由美国罗格斯大学和密西根大学研究团队提出的 AI Agent——WarAgent 便成功模拟了包括第一次世界大战、第二次世界大战和中国古代战国时期战争在内的历史重大国际冲突。

现在ChatGPT等大模型一大痛点:处理长文本算力消耗巨大,背后原因是Transformer架构中注意力机制的二次复杂度。
哈工深发布全新多模态大语言模型九天(JiuTian-LION),融合细粒度空间感知和高层语义视觉知识,在13个评测任务上实现了sota性能。
这是最近在社交媒体上爆火的扩散模型视错觉画,随便给AI两组不同的提示词,它都能给你画出来!
GPT-4无法通过图灵测试!UCSD团队研究证明60年前AI在测试中打败了ChatGPT,更有趣的是人类在测试中的胜率仅有63%。
Anthropic的模型可解释性团队,从大模型中看到了它的「灵魂」——一个可解释的更高级的模型。
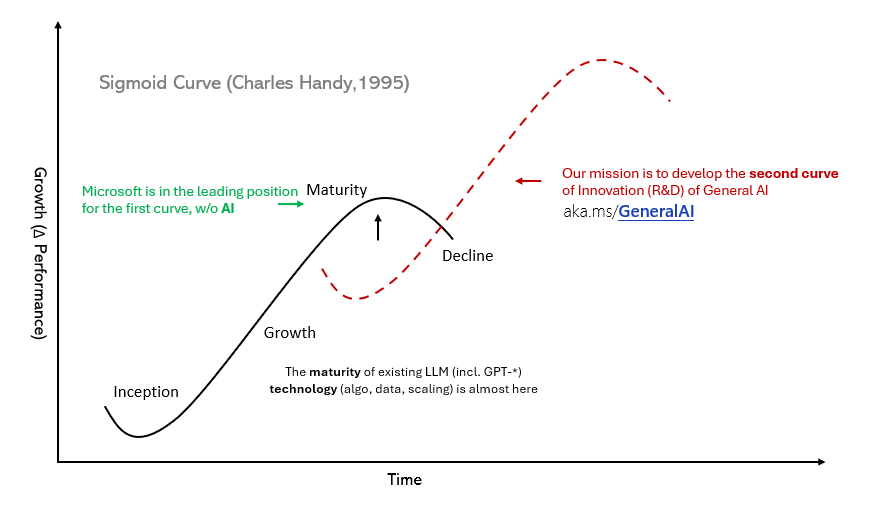
从人工智能的发展历程来看,GPT 系列模型(例如 ChatGPT 和 GPT-4)的问世无疑是一个重要的里程碑。由它所驱动的人工智能应用已经展现出高度的通用性和可用性,并且能够覆盖多个场景和行业 —— 这在人工智能的历史上前所未有。

目前最好的大型多模态模型 GPT-4V 与大学生谁更强?我们还不知道,但近日一个新的基准数据集 MMMU 以及基于其的基准测试或许能给我们提供一点线索,
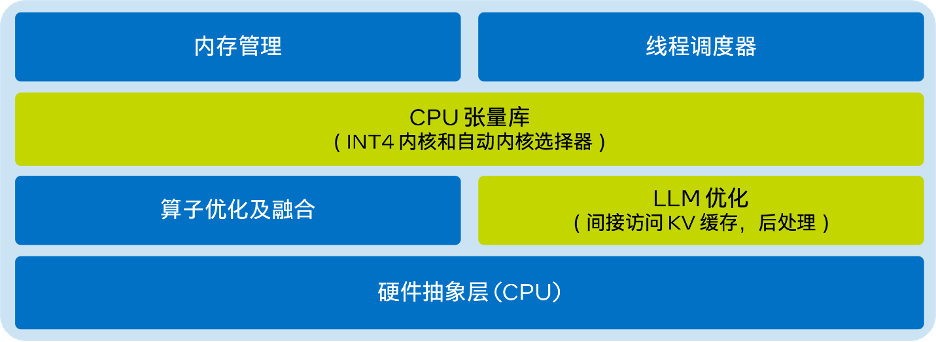
只需不到9行代码,就能在CPU上实现出色的LLM推理性能。英特尔® Extension for Transformer创新工具包中的LLM Runtime为诸多模型显著降低时延,且首个token和下一个token的推理速度分别提升多达40倍和2.68倍,还能满足更多场景应用需求。
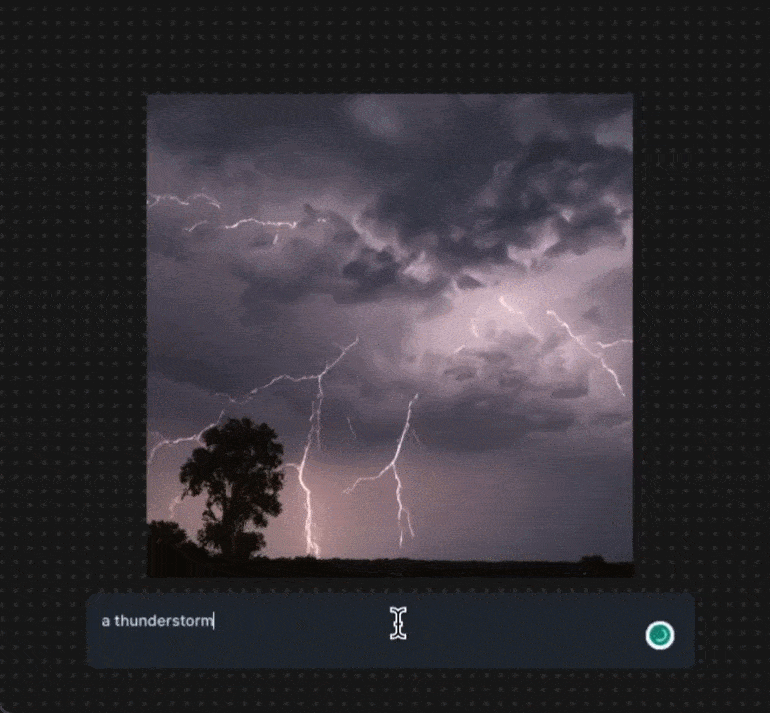
,Stability AI 推出了新一代图像合成模型 Stable Diffusion XL Turbo,引发了一片叫好。人们纷纷表示,图像到文本生成从来没有这么轻松。

只用了 17 天,人工智能(AI)便独自创造了 41 种新材料,每天超过两种。相比之下,人类科学家可能需要几个月的尝试和实验,才能创造出一种新材料。
今天,备受广大开发者欢迎的深度学习框架Keras,正式更新了3.0版本,实现了对PyTorch和JAX的支持,同时性能提升,还能轻松实现大规模分布式训练。
研究人员利用GPT4-Vision构建了一个大规模高质量图文数据集ShareGPT4V,并在此基础上训练了一个7B模型,在多项多模态榜单上超越了其他同级模型。
浪潮信息发布源2.0基础大模型,并一口气开源了1026亿、518亿、21亿三个大模型!而在编程、推理、逻辑这些老大难问题上,源2.0都表现出了令人印象深刻的性能。
Transformer 架构可以说是近期深度学习领域许多成功案例背后的主力军。构建深度 Transformer 架构的一种简单方法是将多个相同的 Transformer 「块」(block)依次堆叠起来,但每个「块」都比较复杂,由许多不同的组件组成,需要以特定的排列组合才能实现良好的性能。
来自中国科学院深圳先进技术研究院、中国科学院大学和 VIVO AI Lab 的研究者联合提出了一个无需训练的文本生成视频新框架 ——GPT4Motion。GPT4Motion 结合了 GPT 等大型语言模型的规划能力、Blender 软件提供的物理模拟能力,以及扩散模型的文生图能力,旨在大幅提升视频合成的质量。
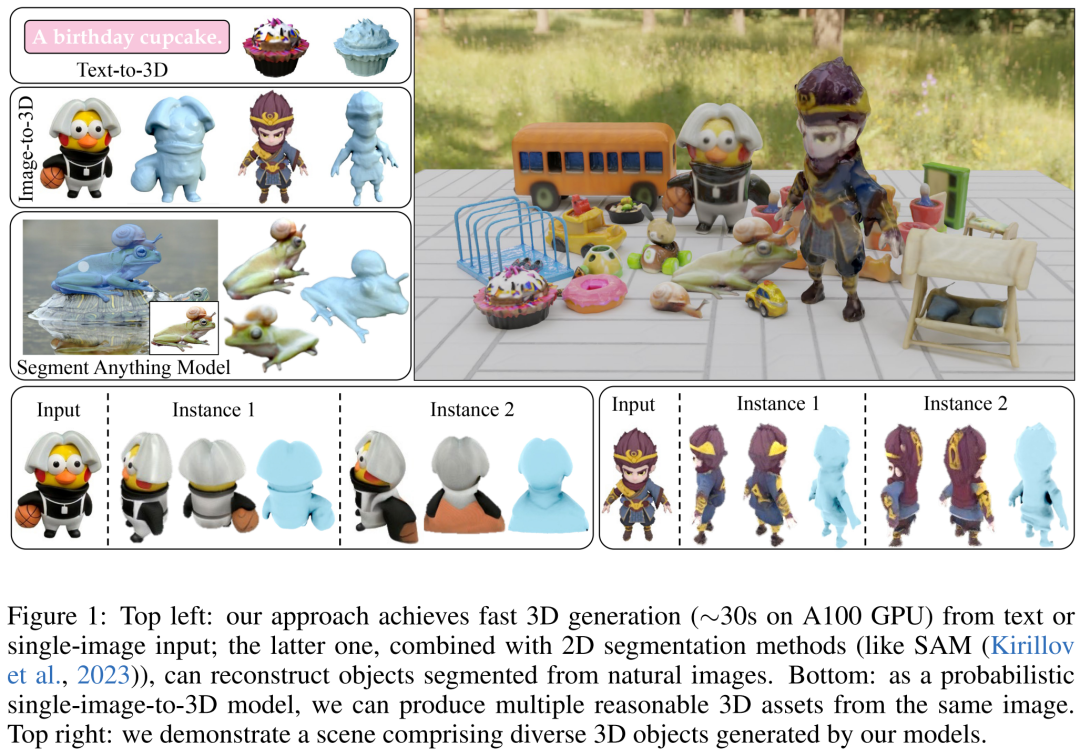
3D 生成是 AI 视觉领域的研究热点之一。本文中,来自 Adobe 研究院和斯坦福大学等机构的研究者利用基于 transformer 的 3D 大型重建模型来对多视图扩散进行去噪,并提出了一种新颖的 3D 生成方法 DMV3D,实现了新的 SOTA 结果。
我们都知道,大语言模型(LLM)能够以一种无需模型微调的方式从少量示例中学习,这种方式被称为「上下文学习」(In-context Learning)。这种上下文学习现象目前只能在大模型上观察到。比如 GPT-4、Llama 等大模型在非常多的领域中都表现出了杰出的性能,但还是有很多场景受限于资源或者实时性要求较高,无法使用大模型。
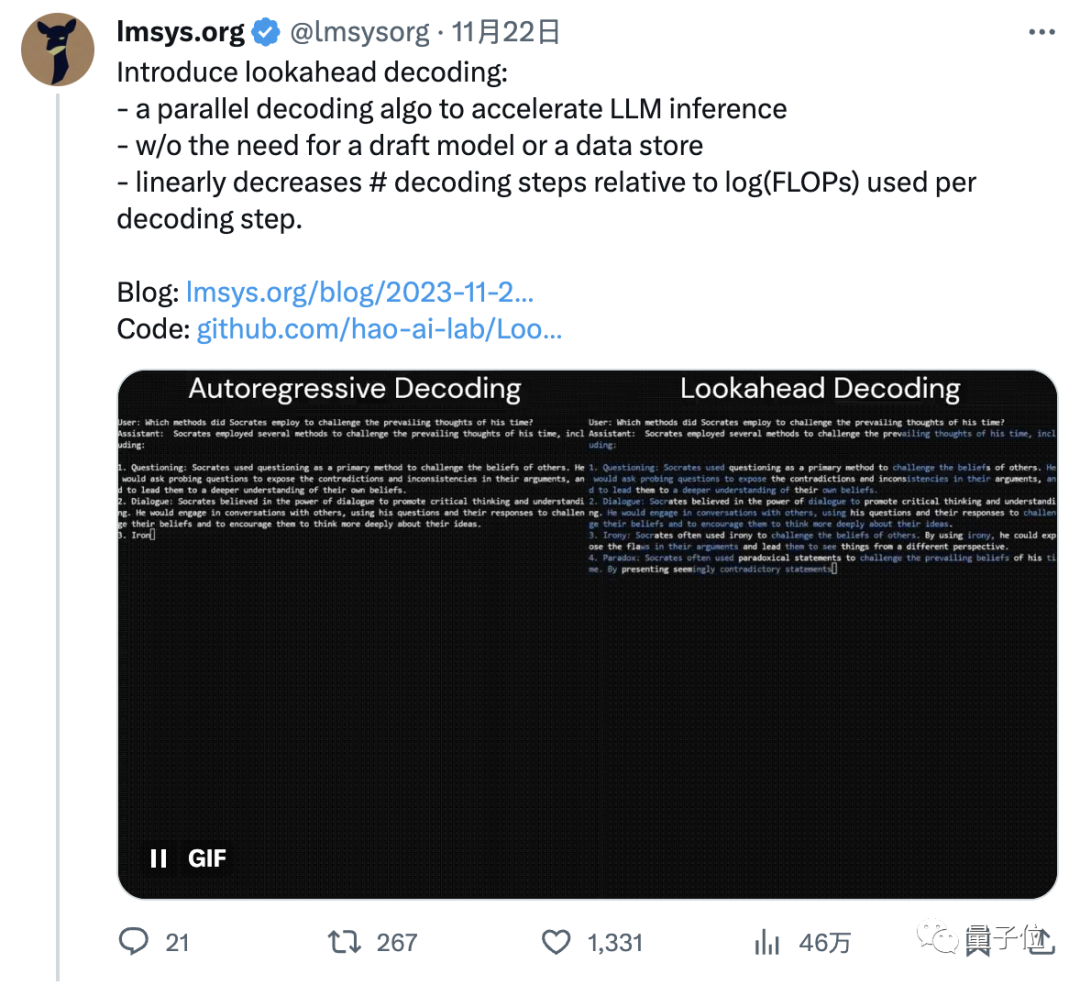
小羊驼团队的新研究火了。他们开发了一种新的解码算法,可以让模型预测100个token数的速度提高1.5-2.3倍,进而加速LLM推理。
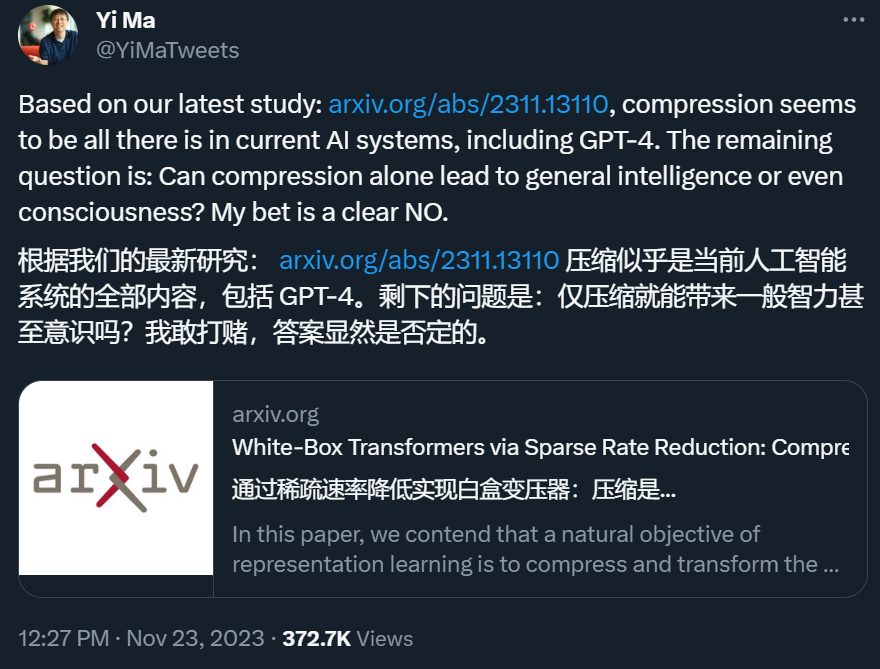
AGI 到底离我们还有多远?在 ChatGPT 引发的新一轮 AI 爆发之后,伯克利和香港大学的马毅教授领导的一个研究团队给出了自己的最新研究结果:包括 GPT-4 在内的当前 AI 系统所做的正是压缩。
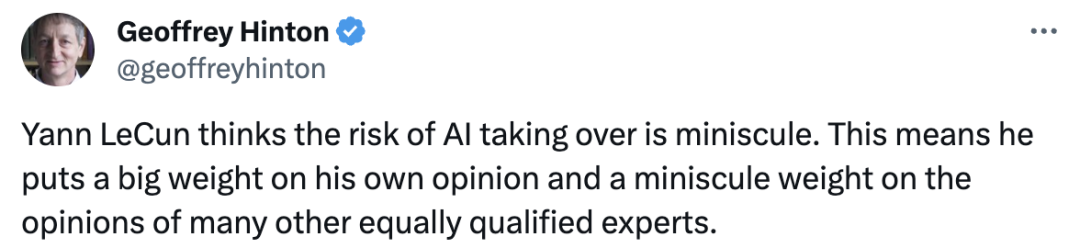
大模型能否理解自己所说,Hinton和LeCun再次吵起来了。LeCun新论文证明,GPT-4回答问题准确率仅为15%,自回归模型不及人类。AI大佬的激战再次掀起。Hinton在线直接点名LeCun,说他对AI接管风险的看法对人类的影响微乎其微。 这意味着,他把自己的意见看得很重,而把许多其他同样有资格的专家的意见看得很轻
用视觉来做Prompt!沈向洋展示IDEA研究院新模型,无需训练或微调,开箱即用
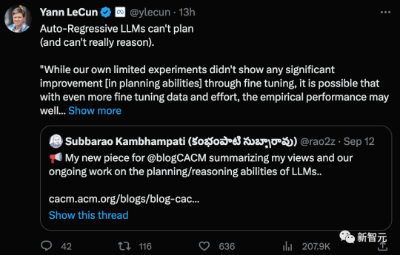
LeCun引战,LLM根本不会推理!大模型「涌现」,终究离不开上下文学习
知名投资机构coatue发布115页《2023年人工智能产业链》报告,就 AI 的现状、改善我们生活的预期、AI 对一些行业的巨大影响、开源 AI 模型现状以及以 AI 为中心的技术栈机会等做了分享,认为最好的 AI 人工智能还没有到来。
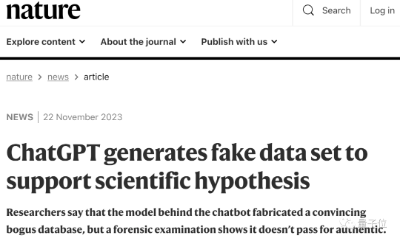
学术造假有了GPT-4,变得更容易了.这两天,一篇刊登在Nature上的新闻表示,GPT-4生成的造假数据集,第一眼还真不一定看得出来。