
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
多轮智能体任务只有一个终点奖励,但在一条包含搜索、工具调用和多轮决策的轨迹里,决定成败的往往是一个不起眼的查询词、动作或对象选择。
这正是多轮语言智能体强化学习中的时间信用分配难题:终点奖励告诉模型“这条轨迹最后对不对”,却没有告诉它“中间哪一步值得被强化”。
当前的主流方案是让同一个模型在训练时阅读任务相关的程序性技能,再回头给无技能轨迹中的token打分。但教师的高置信度并不等于这一步真的对任务有帮助:它可能只是更偏好某种句式、格式或语言表达。
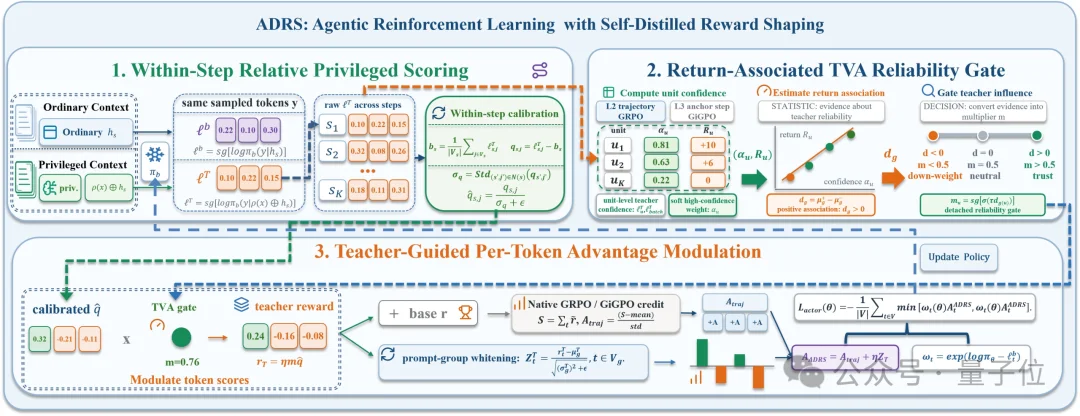
针对这个问题,来自中国科学技术大学与阿里巴巴集团的研究团队提出ADRS(Agentic Reinforcement Learning with Self-Distilled Reward Shaping),把训练期的特权技能转化为与回报相关的token级信用,并直接接入原生的reward-to-advantage-to-policy路径。
在ALFWorld中,智能体要先找到正确房间,再拿起物体、改变状态并完成放置;在WebShop中,它要搜索商品、检查属性、保留用户约束并完成购买。只看最后的成功标签,无法区分一条轨迹里的关键动作和无关的语言填充。
ADRS把挑战拆成三点:教师分数不能直接跨交互步骤比较,不同步骤的上下文长度和模型不确定性使原始log概率的偏移与尺度都在变化;教师置信度不一定是有用的置信度,一个token被高度偏好可能只是因为语言上常见;独立的蒸馏损失可能绕开GRPO/GiGPO正在构造的组相对advantage。
ADRS是位于轨迹采样和actor更新之间的信用构造层,不改变底层RL算法,也不把技能文本带到推理阶段。每轮训练分三步:无技能采样——行为策略在不读取技能的情况下生成多轮轨迹;训练期重评分——固定同一策略快照,对已生成token分别用普通上下文和带任务匹配技能的上下文重评分,技能只在训练期出现,rollout与推理都保持skill-free;构造并注入信用——教师信号经校准和可靠性门控后加到基础token reward上,交给原有的advantage算子更新策略。
具体分三层:
论文在ALFWorld、WebShop和搜索式QA三类环境上评估,覆盖Qwen2.5-3B/7B和Qwen3-1.7B。150-step共同预算下,3B模型的ALFWorld成功率达到94.5%,较最强基线提升10.1个百分点;WebShop的Score/Success为87.5/76.6;7B上ALFWorld达到96.1%。重要的是,rollout和推理都不读取技能,提升全部来自训练期对token信用的重新构造。
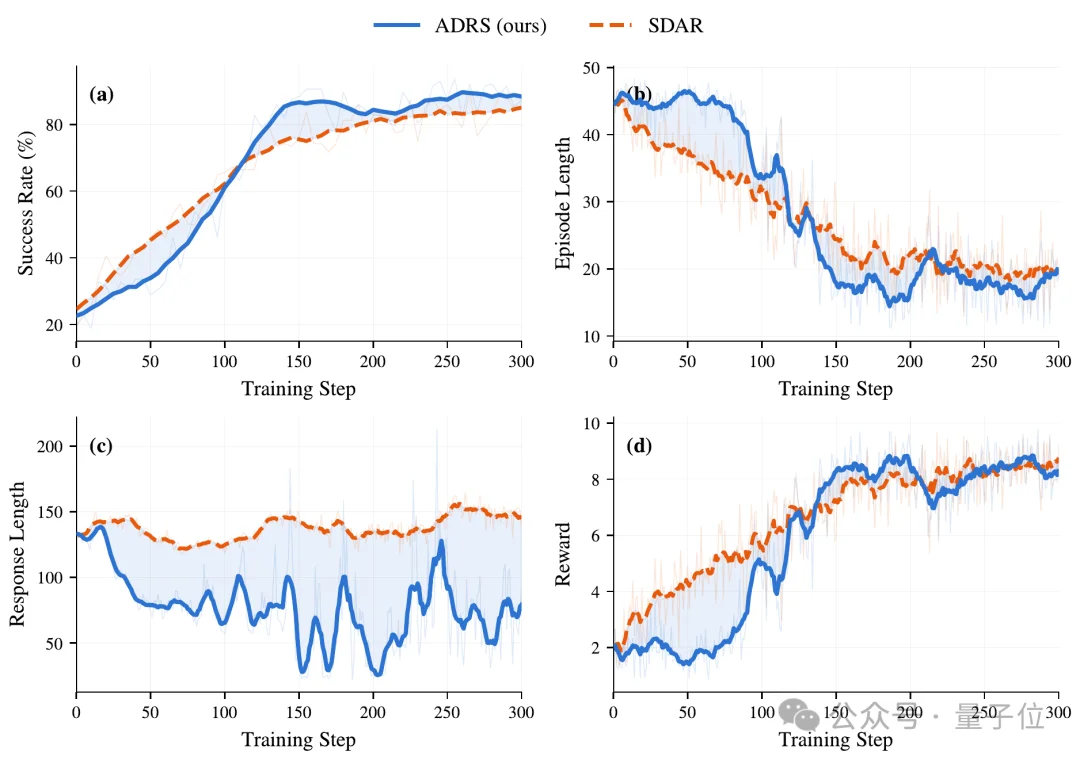
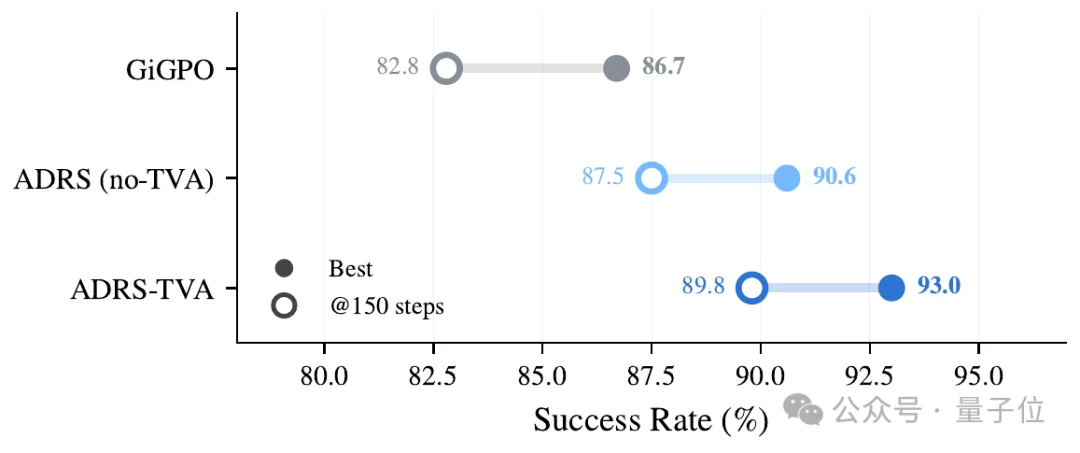
消融上,GiGPO82.8%→ADRS(无TVA)87.5%→ADRS+TVA89.8%,TVA在token级特权信用之外再带来2.3个百分点,说明“教师偏好”与“教师偏好是否和回报相关”并不是同一个问题。token诊断显示,训练到150步时action与style token的更新幅度比达到95.3——ADRS不是平均地强化整段回答,而是把更新对准真正决定执行结果的动作和对象。数据效率上,使用60%训练数据即超过全量GRPO;在未见任务上平均高出11.9个百分点;最大交互步数增至50时,成功率为94.5%对84.4%,交互链路越长优势越明显。
方法的边界同样清楚:TVA使用的是batch内的统计关联而非因果归因;效果依赖底层advantage算子是否保留token级差异;重评分也带来训练期的额外前向计算。但方向已经清晰:当多轮智能体面对的不是一步到位的答案,而是一连串会产生延迟后果的决策时,真正重要的不是“这条轨迹最后成功了”,而是——成功之前,究竟是哪一个token做对了关键选择。
论文标题:Agentic Reinforcement Learning with Self-Distilled Reward Shaping
作者:Ranxu Zhang、Guinan Chen、Shaodong Chen、Jinghao Lin、Xiaozhou Xu、Zhe Sun、Yanyong Zhang、Chao Wang等
论文链接:https://arxiv.org/abs/2608.03223
文章来自于"量子位",作者 "ADRS 团队"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
