
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
最强的 AI 模型,正在遭遇一批最有钱的大客户设限。
原因不是模型能力不够,恰恰因为模型越来越强,企业准备交给它处理的数据也越来越敏感。
9 月 14 日,据 The Information 报道,英伟达、Palantir 和 Booz Allen Hamilton 等公司正在限制部分 Anthropic 模型的使用,或者要求 AI 公司提供更严格的数据保护承诺。报道涉及 Anthropic 和 OpenAI 两家前沿模型公司,其中公开披露的几项具体限制主要集中在 Anthropic 身上。
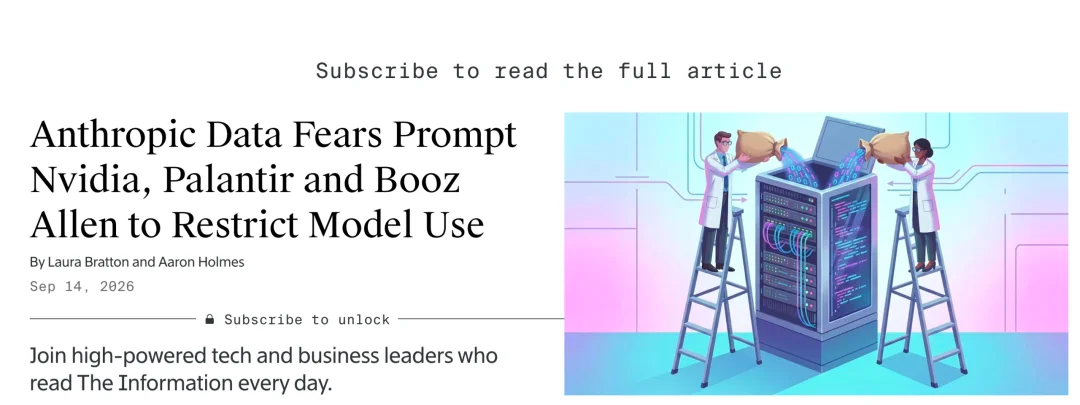
Palantir 提出的要求尤其强硬。据报道,Palantir 希望 Anthropic 给出不可撤销的「零数据留存」(Zero Data Retention,ZDR)承诺,否则不会通过自己的软件平台向客户广泛开放相关模型。
英伟达也在收紧使用范围。Anthropic 的模型目前主要被用于敏感程度较低的内部工作,涉及公司专有信息时,英伟达更倾向使用自家的 Nemotron 模型。
Booz Allen 的边界更加明确:涉及专有数据的网络安全项目,不允许员工使用 Anthropic 的商业模型。
看起来,这只是几家公司重新调整 AI 使用政策。但真正值得关注的问题已经浮出水面:当 AI 开始进入企业最核心的业务,谁来掌握那些经过模型的数据?
这个问题,正在成为前沿模型进入企业市场的新门槛。
过去两年,企业部署大模型时最常问的问题之一,是:「我的数据会不会被拿去训练?」现在,问题已经更进一步。
即使不用于模型训练,企业依然会关心数据会被保存多久,保存在谁的服务器里,谁有权限查看,安全系统会读取什么,以及这些日志是否可能被模型供应商用于其他分析。
对于普通聊天,这些区别可能并不明显。对于芯片设计、供应链、网络安全、金融交易、政府项目和企业内部代码库,每一项都可能直接决定模型能不能进入生产环境。
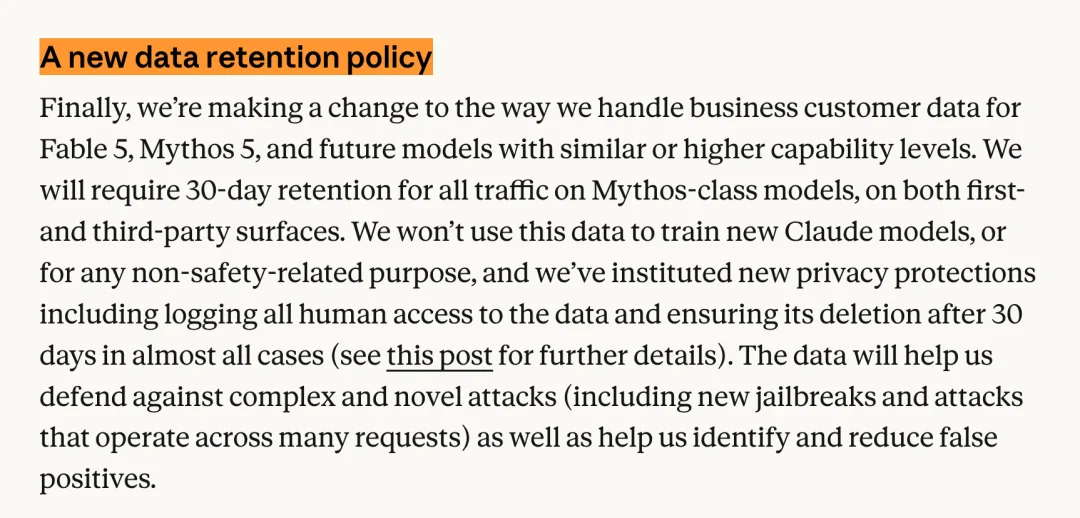
这次争议,很大程度上与 Anthropic 在今年 6 月推出 Claude Fable 5 时实施的新数据留存政策有关。Anthropic 当时规定,Fable 5、Mythos 5,以及未来能力达到类似水平的模型,默认需要保留 30 天的使用数据。公司解释称,这些数据主要用于安全监测,包括识别跨越多次请求的复杂攻击、新型 jailbreak,以及降低安全系统的误判。
https://www.anthropic.com/news/claude-fable-5-mythos-5?utm_source=chatgpt.com
Anthropic 同时明确表示,这部分数据不会用于训练新的 Claude 模型,也不会被用于与安全无关的用途。这里有一个很重要的细节。30 天留存并不适用于所有 Claude 商业产品。它针对的是 Fable 5、Mythos 5 这类能力更强的前沿模型,以及未来达到相应能力级别的模型。
Anthropic 给出的理由也很现实。模型能力越强,潜在的滥用风险越高。单看某一轮对话,很难识别一些经过长期策划的攻击。保留一段时间的活动日志,可以让安全系统从多轮行为中寻找异常模式。
问题随之出现。对于 Anthropic 来说,这些日志是安全防线的一部分。对于部分企业客户来说,让数据离开自己的控制范围,本身就是风险。双方的矛盾由此产生。
这一点很容易被混淆。目前 OpenAI 明确表示,ChatGPT Enterprise、ChatGPT Business、API 等商业产品中的企业数据,默认不会用于训练或改进模型。企业需要主动选择加入数据共享,相关内容才可能进入模型改进流程。Anthropic 的商业服务同样有类似的数据保护承诺。
所以这次争论的关键,不能简单概括成「AI 公司要拿客户数据训练模型」。企业正在要求更高一级的控制。它们希望确认:模型供应商最好连数据本身都不要长期持有。
这一变化和企业 AI 的使用方式有关。早期的大模型主要负责写邮件、总结文档、生成营销文案。即使使用 SaaS 服务,数据风险通常还可以通过权限管理和脱敏解决。Agent 出现之后,情况开始变化。模型开始接触代码仓库、内部知识库、数据库、企业应用和生产系统。
一次完整任务可能持续数小时甚至数天,它看到的不再是一份孤立的文档。整个执行过程中产生的 prompt、工具调用记录、系统返回结果和操作轨迹,都可能拼出企业内部非常完整的业务信息。
对于英伟达这样的公司,里面可能包含芯片研发、供应链和客户信息。对于 Booz Allen,网络安全项目本身就可能涉及高度敏感的数据和系统细节。对于 Palantir,很多客户来自政府、国防和大型企业,数据治理从一开始就是产品的一部分。
模型能力进入这个级别以后,「我们不会用你的数据训练模型」已经很难解决全部顾虑。企业还会继续追问:
数据到底在哪里?
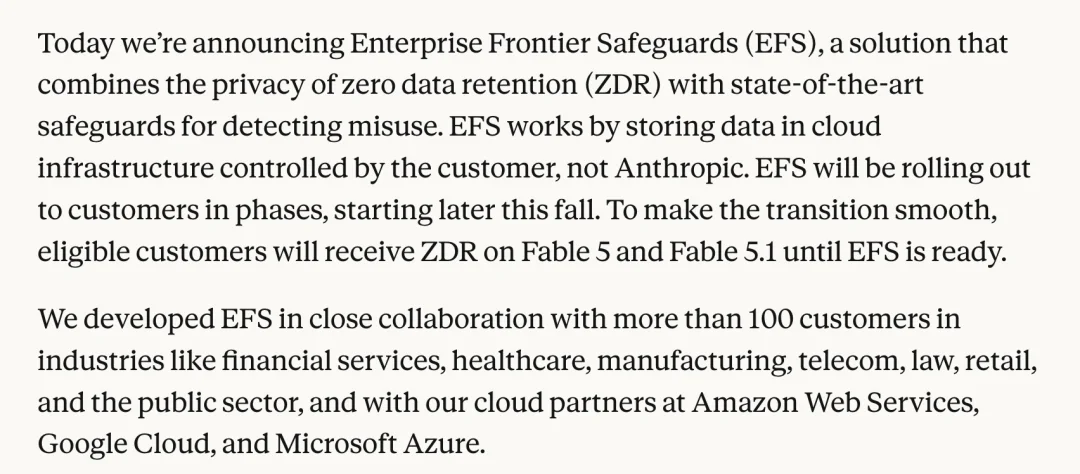
Anthropic 也意识到了这个矛盾。9 月 1 日,公司正式公布了 Enterprise Frontier Safeguards,简称 EFS。
这套系统试图同时解决两件此前存在冲突的事情:企业要求零数据留存,Anthropic 又需要对高能力模型进行持续的安全监测。
https://www.anthropic.com/news/enterprise-frontier-safeguards?utm_source=chatgpt.com
解决办法是改变日志存放的位置。启用 EFS 后,用于安全监测的活动数据可以直接保存在客户自己的云账户中,包括 Amazon S3、Azure Blob Storage 和 Google Cloud Storage。加密密钥由客户管理,访问策略由客户决定,审计日志同样留在客户控制的环境中。
Anthropic 的自动安全系统依然可以运行。当系统检测到值得进一步关注的异常模式时,信号会发送给客户。默认情况下,后续的人类审核也由客户自己完成,Anthropic 员工无需直接查看这些数据。Anthropic 将这种设计形容为同时提供零数据留存级别的隐私,以及针对前沿模型的自动安全监控。
EFS 目前还没有全面开放。Anthropic 计划从今年秋季晚些时候开始分阶段上线,并逐步扩大覆盖范围。在 EFS 正式可用之前,符合条件的企业客户可以继续以零数据留存模式使用 Fable 5.1。
值得注意的是,这套方案并不是 Anthropic 闭门设计出来的。Anthropic 称,它与金融、医疗、制造、电信、法律、零售和公共部门等行业超过 100 家客户共同开发 EFS,同时与 AWS、Google Cloud 和 Microsoft Azure 合作。
从这个角度看,EFS 本身已经说明了一件事:数据托管方式正在从企业采购模型时的一项合同条款,进入产品架构本身。
与此同时,企业也开始寻找另一种解决方案。9 月 10 日,英伟达和 Palantir 宣布合作推出一套面向关键供应链的「主权 AI」方案。
两家公司把 Palantir Foundry、AIP,与英伟达 Nemotron 开放模型结合起来,并首先部署到英伟达自己的供应链系统中。
官方介绍中有一句话很关键:这套系统允许企业在使用 AI 的同时,继续保持对专有数据的控制和所有权。系统既可以部署在云端,也可以运行在本地基础设施。
英伟达自己成了第一个用户。根据英伟达披露的案例,其供应链系统会处理产能、原材料、生产周期,以及来自邮件、天气、地缘政治和供应商沟通中的大量非结构化信息。Nemotron 模型可以在 Palantir 的治理体系内使用这些信息,辅助供应链决策。
官方并没有把这个项目描述成对 Claude 或 OpenAI 模型的替代,却展示了企业 AI 的另一条技术路线。如果数据非常敏感,企业完全可以选择开放权重模型,在自己能够控制的基础设施中运行。
模型可能不是任何榜单上最强的那一个。数据不需要离开自己的边界。对很多企业来说,这个交换开始变得可以接受。
英伟达本身处在全球 AI 产业最核心的位置,与几乎所有主要模型公司都有合作关系。它当然理解前沿闭源模型的能力价值。与此同时,它拥有自己的模型、算力和部署栈,有条件把敏感任务留在内部。
这给企业市场带来了一个越来越清晰的选择:模型能力是一条坐标轴,数据控制能力是另一条。
此前,模型领先几个百分点,往往足以改变企业的技术选择。当 AI 深入企业核心系统之后,模型能力的优势还要经过安全、合规、数据主权和部署方式的过滤。尤其在金融、医疗、国防、网络安全、芯片和政府等领域,后面几项很可能直接拥有否决权。
这也是开放模型在企业市场一直拥有特殊价值的原因。企业可以自己部署,日志可以自己保存,模型可以放在指定区域,网络可以与外部隔离。涉及极敏感信息时,甚至可以部署到完全自有的基础设施中。
模型供应商无法天然获得运行过程中产生的数据。对某些业务来说,这种可控性本身就是产品能力。
当几个模型都足够强以后,真正决定谁能进入公司最核心系统的,可能是一个更朴素的问题:谁能让客户始终握住自己的数据。
参考链接:
https://www.theinformation.com/articles/anthropic-data-fears-prompt-nvidia-palantir-booz-allen-restrict-model-use
文章来自于"机器之心",作者 "机器之心编辑部"。


【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
