
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
单科冠军不够,具身智能落地需要没有结构性短板的底座
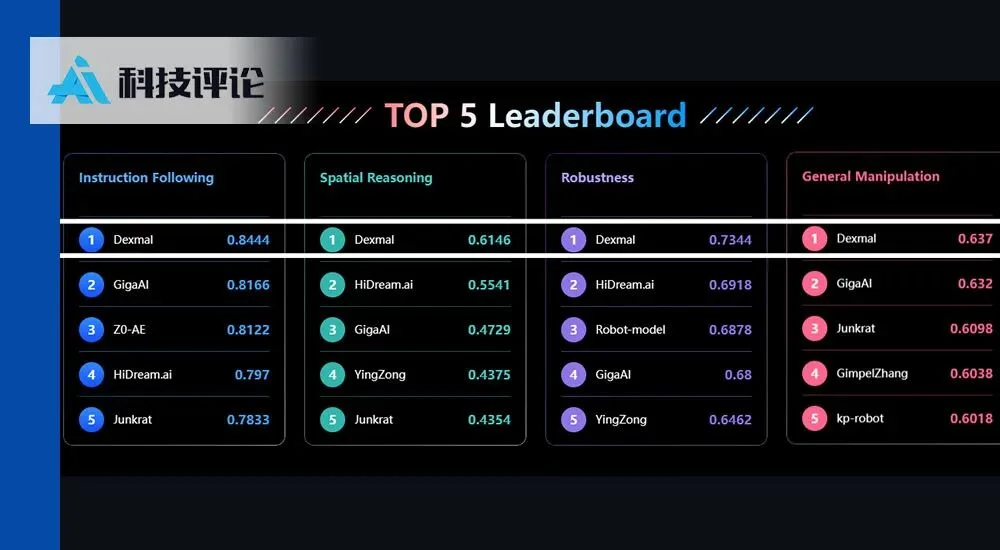
一个模型同时占据四个能力子榜单的榜首,这在具身智能行业里不多见。
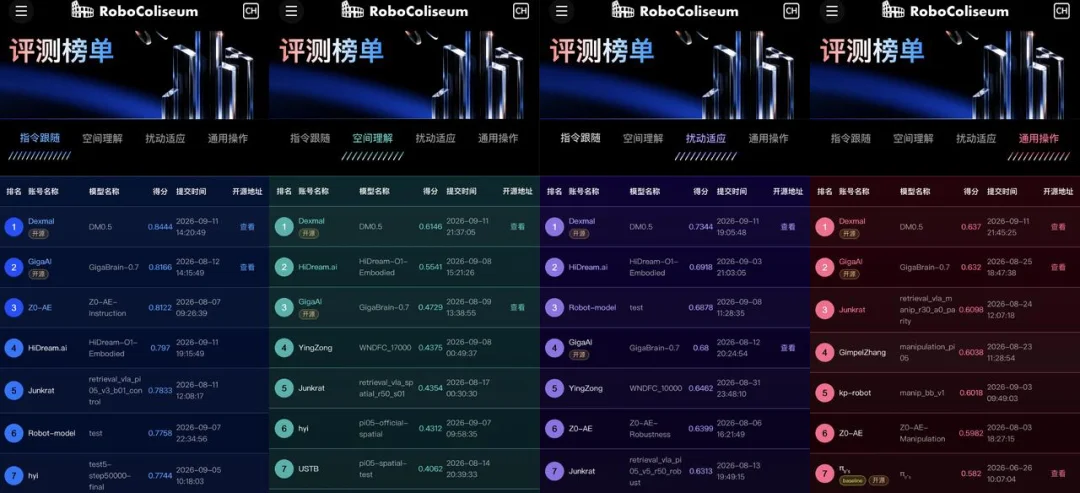
RoboColiseum 是由智元机器人发起,联合高校、科研机构、开源社区及机器人企业共同建设的评测平台,它把评测拆成四个维度:指令跟随、空间理解、扰动适应、通用操作。参评者只要在任何一个维度上有结构性短板,就会在对应的子榜上掉下来。
而原力灵机的通用具身基础模型 DM0.5 在四个子榜上全部排名第一,且目前是唯一做到这一点的模型。
AI科技评论想知道,这张成绩单有多可信?DM0.5 又凭什么霸榜?
演示效果和真实场景之间存在差距,这在机器人行业早不是什么新鲜事。普通商品尚有卖家秀与买家秀之别,遑论技术尚未成熟的具身智能。因此,模型越是层出不穷,行业就越需要可信赖、细颗粒的公共标尺,帮助挑选出真正的强者。
然而现实并不乐观,AI科技评论观察到,具身评测行业长期存在几个痛点,让分数的可信度打了折扣。
第一个痛点,是仿真跑分高、真机落地差。 仿真环境里的物理参数、视觉渲染和真实世界相差甚远,模型在仿真里得了高分,搬到真机上可能是一塌糊涂。市面上大部分仿真评测基准并没有做系统的真机-仿真对比实验,更没有公开结果。
针对 Sim2Real 的一致性问题,RoboColiseum 负责人吴墨告诉AI科技评论,平台通过空间智能技术在仿真环境中高保真重建真实世界,配合激光雷达还原几何信息,再对物体的质量、重心、碰撞几何、动静摩擦力、转动惯量,以及机器人本体的相机内外参、刚度阻尼、末端控制响应等物理参数逐项校准。最终验证结果显示,仿真与真机的模型表现一致性达到 89.5%,单个任务的成功率差异均小于 10%。
第二个痛点,是评测基准生命周期短。 具身模型迭代太快,一套榜单推出后半年,头部模型就把分数堆满了,无法再区分好坏。“刷榜”现象在大语言模型领域早有端倪,原本被设计为终身学习的 LIBERO,从发布到被刷穿,只坚持了不到三年。
RoboColiseum 现有 78 个评测任务、超过 3000 个泛化 case,训练集和评测集完全隔离,评测集对每个任务都做了充分的泛化配置,让轨迹回放类方案彻底失效。
第三个痛点,是单点能力强不代表真实场景好用。 行业里不少评测基准的设计,本质上是在考一道题——把模型在某个原子能力上压榨到极限,然后把这个数字当成模型能力的代理指标。这种评测逻辑在能力单一、任务简单的早期阶段是够用的。但问题在于,真实场景的任务几乎没有一个是单科题。工厂里的分拣机器人,要同时听懂调度指令、判断传送带上包裹的空间位置、应对随机摆放姿态的干扰,最后把一系列原子动作组合成完整的操作流程。单点能力强的模型进了真实场景,这边表现不错,那边掉链子,整体任务完成率依然惨淡。
而 RoboColiseum 围绕四个维度展开评测,分别对应机器人在真实世界中完成任务所需要的能力分层:指令是基础,空间是认知,扰动是鲁棒,操作是落地。从语义到物理,从感知到执行,构成了一套相对完整的考察链条。
在四大子榜单上,原力灵机 DM0.5 以指令跟随 0.8444、空间理解 0.6146、扰动适应 0.7344、通用操作 0.6370 的成绩,全部排名第一。
四榜同时第一比单项第一难得多,因为这四个维度考的是不同层次的能力,彼此之间并不互相加持。一个记忆能力超强的模型,未必能在空间理解上占优;擅长执行精细操作的模型,未必在扰动适应上稳得住。四个子榜,相当于对模型做了四次独立考核,任何一个短板都会直接体现在对应的排名上,无法被其他维度的优势掩盖。这也是为什么行业里单项能力突出的模型并不少见,但能同时在多个维度维持领先的模型极少。
我们仔细研究了 DM0.5 的架构和数据源,每个维度上都有具体的技术支撑。
指令跟随方面,DM0.5 在预训练阶段设计了具身思维链:动作生成之前,模型要先走完一套内部推理流程——目标物体在哪、上一步干了什么、这步该不该结束、不这么干会怎样。11 项推理任务覆盖任务规划和动作生成两个层面,逼模型理解“指令×本体×环境”三方的关系,而不是背答案。这一层预训练能力沉淀下来之后,DM0.5 展现出 zero-shot 级别的泛化——在没有见过的任务配置上,仍然能应对多样的动作组合和语言条件约束。
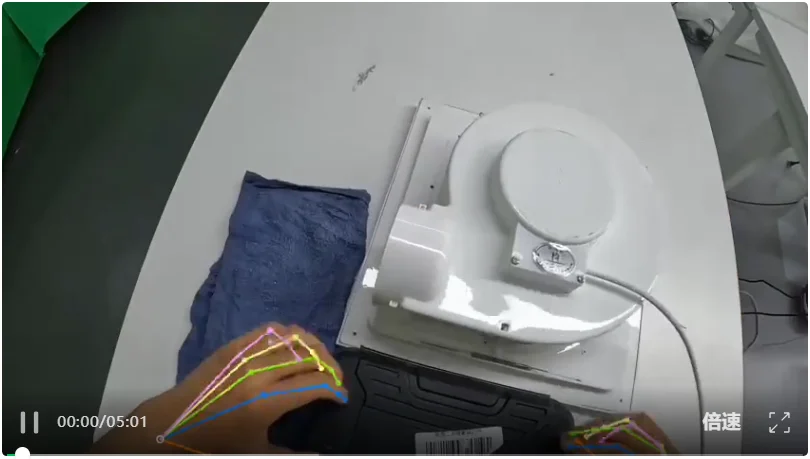
空间理解方面,DM0.5 的预训练数据包含 10 万小时 Egocentric 视频,并基于这些数据支持毫米级精度的 3D 空间标注生成。这意味着模型在预训练阶段就在大规模地学习从第一视角理解三维空间,而不是事后用有限的机器人操作数据“打补丁”。
我们注意到,原力灵机与天津大学、清华大学合作的论文《GeoVLA: Empowering 3D Representations in Vision-Language-Action Models》入选 IROS 2026 认知机器人最佳论文奖提名,核心工作正是把三维几何表征显式引入 VLA 模型的决策过程——让模型不只在二维图像空间里做判断,而是在具有深度、距离和几何关系的三维世界里理解场景。
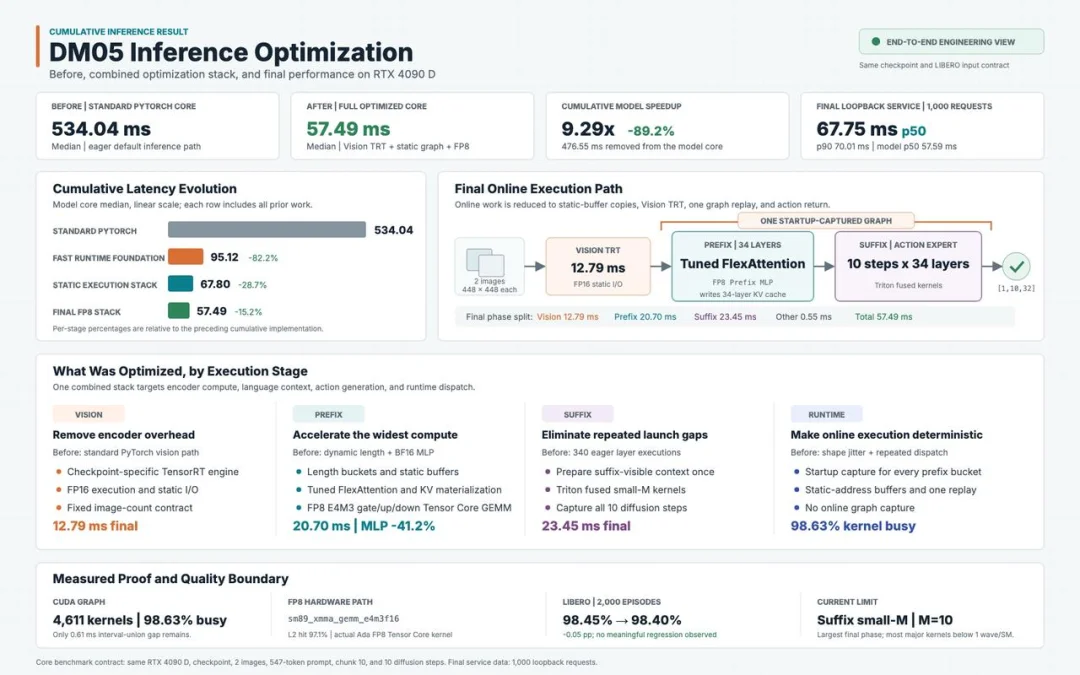
扰动适应和工业落地最直接相关,这方面,DM0.5 靠两件事兜底。一是推理速度:通过多项工程优化,模型核心延迟从 534 毫秒压到 57.49 毫秒,9.29 倍加速,同时在 2000 个 LIBERO 测试 episode 上成功率几乎无损(98.45% 降至 98.40%)。人眨一次眼约 100 到 150 毫秒,DM0.5 的“感知-思考-出手”全流程比眨眼还快,干扰发生的瞬间,模型已经完成了重新感知和决策。二是原生 60 秒记忆:即使任务被中断,模型知道刚才做到哪里了,能够续接而不是从头来。
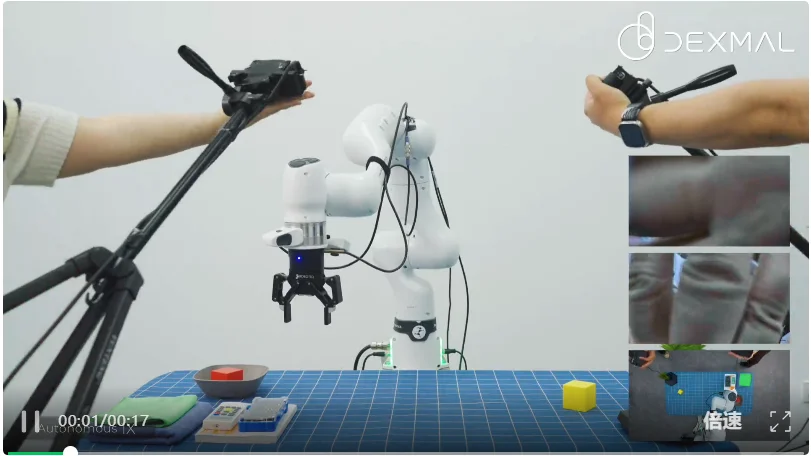
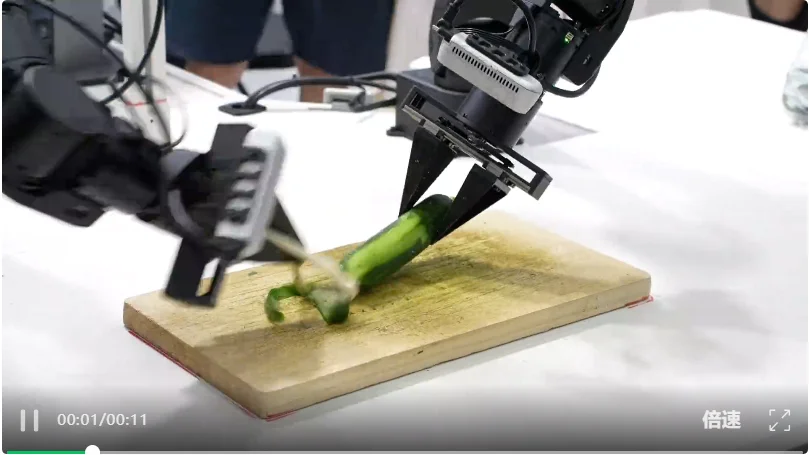
通用操作方面,考的是在前三项能力全部就位之后,把原子技能有效组合完成完整任务序列的能力。物流分拣场景里,DM0.5 不依赖预设脚本,纯靠实时视觉识别和决策,平均 3 秒一件,准确率超 99%;亚毫米积木拼装场景里,出现接错时能自主感知失败,半秒内调整姿态重新抓取纠错,每 12 秒完成一次拼装,全天候无间断;灵巧手场景里,DM0.5 配合后训练,控制带有 58 个自由度的灵巧手完成切黄瓜、削黄瓜等厨房任务——柔性物体形状随机、易滚动,传统工业机器人靠预设轨迹根本无法应对,只能让底座模型实时感知、实时决策。
第一的获取方式,值得拿出来单独说。
DM0.5 在 RoboColiseum 上的路径是:强大的预训练底座,没有针对评测任务做专项优化,只是通过常规监督微调将模型能力迁移到了 RoboColiseum 的机器人构型和任务上,完成从底座到榜单任务的适配。
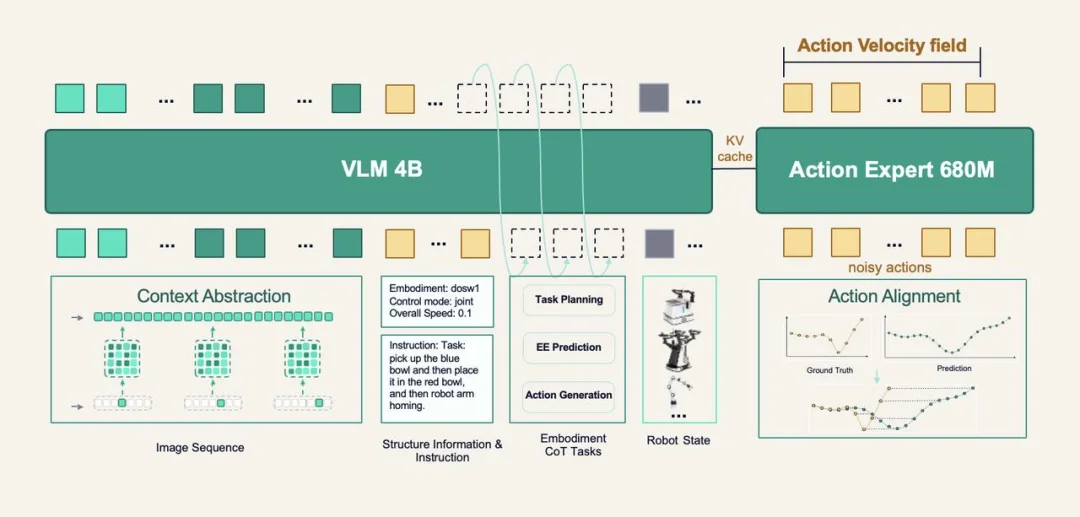
这个细节的意义在于,它让这份成绩更接近对底座模型真实能力的测量,而不是对评测优化技巧的测量。
额外对齐并非没有价值,但在具身领域,这类介入往往意味着模型开始针对特定的任务做定向优化。这种优化在某些场景下效果显著,但也容易让模型的泛化能力下降——在训练分布内表现优异,出了分布就掉价。
DM0.5 靠 SFT 就能登顶,说明它的预训练底座在指令理解、空间感知、历史记忆和动作生成上,已经形成了足够坚实的通用能力基础。这种通用性,才是支撑它在不同评测框架下都能维持领先的根本原因。
原力灵机并非第一次拿到这样的好成绩。
上个月,DM0.5 刚刚登顶 RoboDojo——由香港大学多媒体实验室联合 UC 伯克利、清华大学等全球近 20 所顶尖机构共同发起的权威评测基准。AI 科技评论当时专门做了一篇深度分析,重点在于 Memory 维度。DM0.5 在记忆维度上取得 47.74 分和 47.44% 的成功率,而第二名只有 13.37 分和 12.11%——得分差了 3 倍多,成功率差了接近 4 倍。
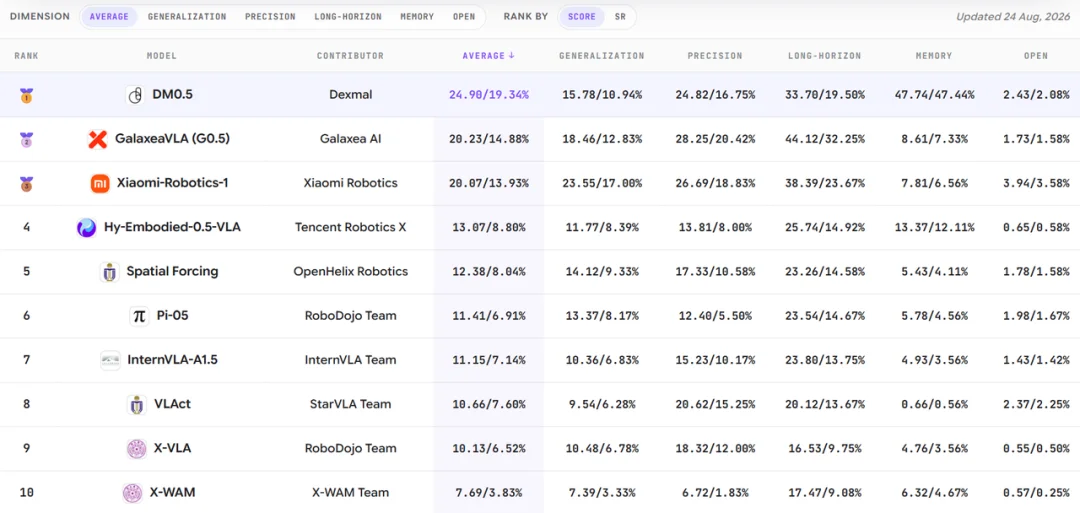
如果说 RoboDojo 是一次横向比较,那么 DM0.5 在其他评测基准上的纵向成绩,则构成了另一条佐证线索。在真机与仿真评测中,LIBERO 综合成功率达到 99.0%;RoboTwin 2.0 简单和复杂场景下成功率分别为 93.6% 和 93.3%;VLA-Arena 三档难度下依次为 89.0%、53.6%、44.1%;导航场景仿真测试中,R2R 和 RxR 的 Val-Unseen 成功率分别达到 59.7% 和 65.5%,相比所有基线方法均取得显著优势。真机评测 RoboChallenge Table30 V2 里,面对 ARX5、UR5、ALOHA、Dexmal-Mirror 四种异构机型、30 个复杂任务,DM0.5 以 43.0% 的整体成功率、54.42 的综合得分同样位列第一。
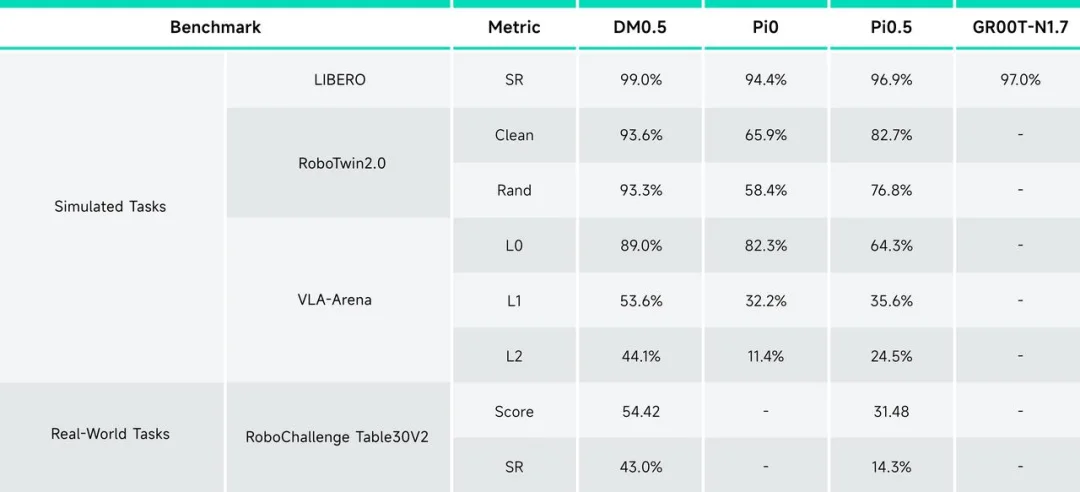
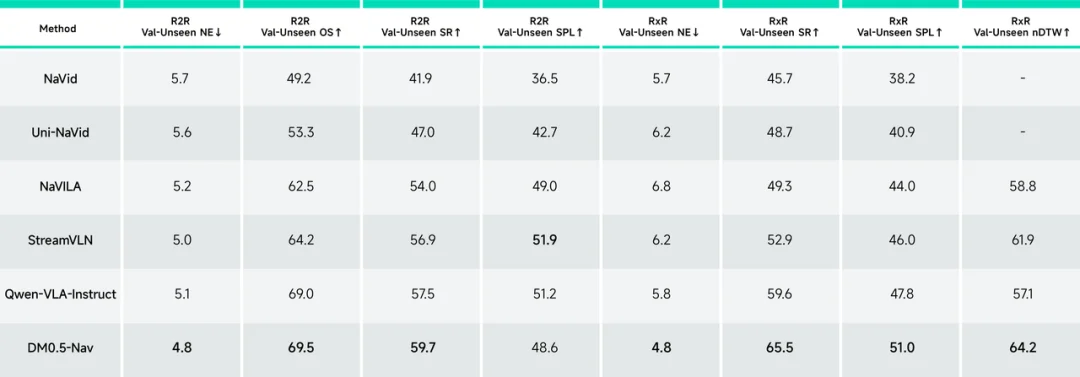
跨越仿真与真机、覆盖操作与导航、兼容单一机型与多种异构构型,这些数字共同指向同一个结论:DM0.5 的成绩并非依赖某一个场景或评测框架的特殊适配,而是在多个独立的考场上反复被验证过的。
第三个佐证来自国际同行的引用。Physical Intelligence(π)在两次关键输出中,都将原力灵机的 MemoryVLA 纳入了学术参照系:一次是发布具身记忆架构论文 MEM(Multi-Scale Embodied Memory for Vision Language Action Models),一次是将 MEM 的理念落地为旗舰产品 π0.7。
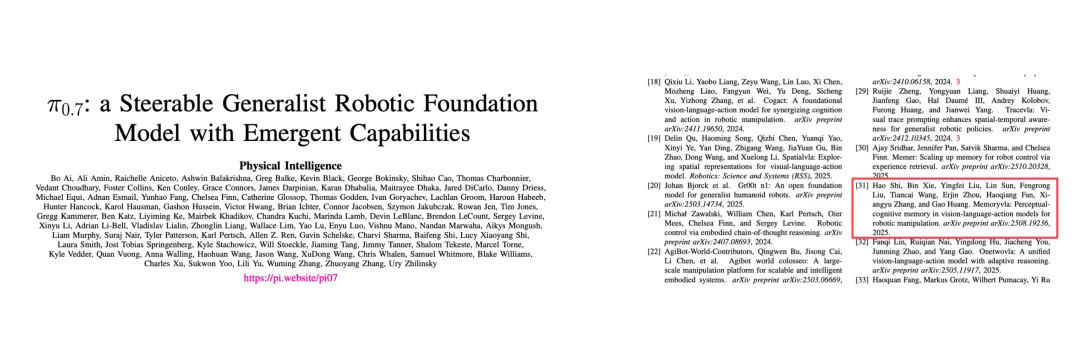
MemoryVLA 受认知科学中工作记忆与海马体双机制启发,提出感知-认知记忆库,构建了一套面向动作控制的双流 latent memory 机制。PI 在大脑和小脑的全局视角定义问题,而 MemoryVLA 则在小脑记忆这条路径上给出了一套经过大规模实验验证的完整方案。两者是独立探索、方向趋同,这大概是 PI 连续两次引用的原因。
DM0.5 目前的状态,可以用三件事来描述。
第一件:推理速度进入实时控制的时间窗口。通过 Vision TensorRT、Tuned FlexAttention、FP8 E4M3 Tensor Core、Triton 融合算子和 CUDA Graph 的联合优化,DM0.5 的模型核心延迟从 534 毫秒压到 57.49 毫秒,API 响应控制在 70 毫秒内(p50 67.75 ms,p90 70.01 ms),累计加速 9.29 倍,延迟降低 89.2%。整套 VLA 推理系统快了一个数量级,大模型的智力第一次跑进了实时控制要求的时间窗口。
第二件:全面开源。DM0.5 模型权重、训练框架,以及从 LIBERO、RoboTwin 2.0 到 RoboChallenge、真机 SO101 的多个下游任务完整工作流,已陆续在 GitHub 和 Hugging Face 上开放,核心代码也提交给了 LeRobot 社区。这个选择的背后有一个值得关注的行业逻辑:具身智能目前最缺的不是哪家公司独占一切,而是一个经过全科验证的公共底座。一个全科有效的底座开源出来,开发者可以把有限的资源用在特定场景的微调和落地上,而不必从零开始验证架构是否可靠。国际电信联盟(ITU)具身智能焦点组首次线下会议上,原力灵机当选了“开源生态”工作组组长单位。
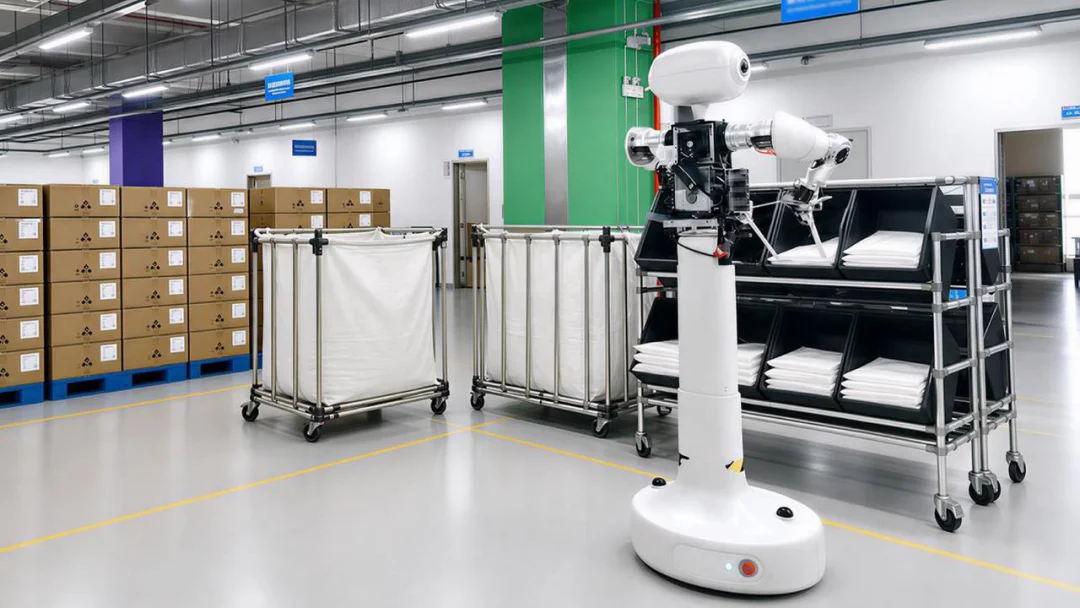
第三件:真机落地持续推进。原力灵机已在多个真实场景中部署测试:大型国际零售商仓储中,多台搭载 DM0.5 的机器人正与其他类型机器人协同作业,完成商品搬运与分拣;大型 3C 制造商工厂里,搭载 DM0.5 的机器人正配合生产线进行包装和废料回收。从榜单到工厂,这是评测成绩在真实世界中被验证的下一步。
RoboDojo 和 RoboColiseum,一个由顶级学术机构操持,一个由产业机构主导;一个侧重记忆、长程执行和开放语义,一个侧重指令理解、空间认知、鲁棒性和操作组合。两套体系的出题逻辑几乎没有刻意对齐,但 DM0.5 在两个考场上都站在了最高处。
具身智能的评测体系还在建立中,行业至今没有一个像大语言模型那样被普遍接受的权威基准。在这个标准尚未收敛的阶段,能在多个不同方向的严格评测上都稳在第一梯队,含金量反而比刷穿某一套题更重。因为它证明的是,在标准统一之前就已经做好了应对任何标准的准备。
AI 科技评论之前写道,“全科优秀,才是进入百万小时时代的必要条件,每门课都没有结构性漏洞,数据才会真正转化为能力。”这句话说的是数据 Scaling 的前提。而现在看来,它同样适用于落地:工厂要求鲁棒性和节拍,家庭要求语义理解和精细操作,仓储要求长程稳定性,没有哪个真实场景会迁就你的短板。一个能力有结构性漏洞的模型,在某一类场景里可能跑得不错,但很难真正跨越到普适落地。
这也是为什么四榜同时第一,比任何一个单项冠军都更值得关注。只有整个能力谱系足够宽、足够均衡,才能同时承接真实世界里多样的任务要求。
物理世界的智能,靠单科状元是不够的。行业最终需要的,是能经得住不同考场、不同考官、不同考题的长期答题者。
文章来自于"AI科技评论",作者 "邓哲敏"。


【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
